ffmpeg — мощный инструмент для конвертирования файлов в большинстве известных видеоформатов. Программа ffmpeg не имеет графического интерфейса, однако позволяет выполнять задачи, перед которыми другие видеоконвертеры попросту бессильны.
Ниже рассмотрим, как установить ffmpeg в Ubuntu 20.04 из официальных репозиториев, а также с использованием snap-пакета. А затем поговорим о том, как с его помощью переконвертировать небольшое видео из одного формата в другой.
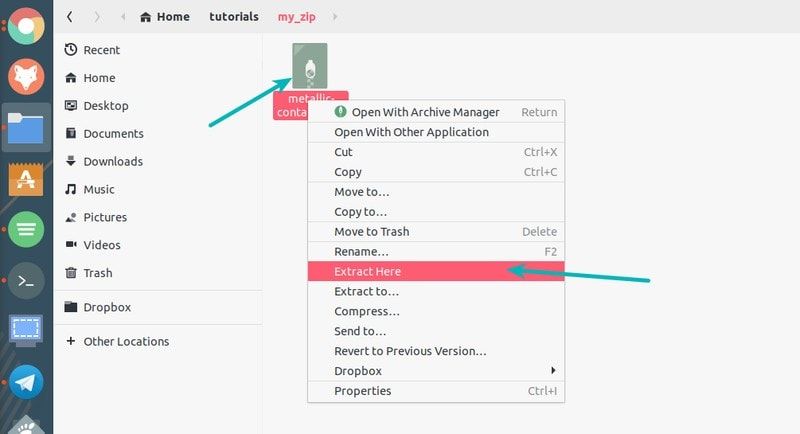
Zip — это один из самых распространенных и наиболее популярных способов создания сжатых архивных файлов. Это также один из самых старых форматов архивных файлов, он был создан в 1989 году. Поскольку он широко используется, вы будете регулярно сталкиваться с zip-файлами.
В одном из предыдущих уроков я показал, как заархивировать папку в Linux. В этом кратком руководстве для начинающих я покажу вам, как распаковывать файлы в Linux. Читать →
Apache Tomcat или просто Tomcat — это бесплатный веб-сервер с открытым исходным кодом, разработанный Apache Software Foundation для реализации Java Servlet, JavaServer Pages, Java Expression Language и технологий веб-сокетов. Он предоставляет http-сервер «чистой Java».
Apache Tomcat предоставляет HTTP-коннектор по умолчанию на порту 8080, что позволяет использовать его в качестве веб-сервера, такого как Apache, для ваших приложений Java. Читать →
Мы рассмотрим процесс поднятия двух контейнеров с PostgreSQL и настройки репликации данных между ними. Использовать будем систему на базе Linux, однако, сам процесс настройки Docker и репликации не зависит от операционной системы.
Подготовка компьютера
На компьютере, где мы будем запускать наш кластер баз данных должен быть установлен Docker. Также мы сразу рассмотрим развертывание нужной нам инфраструктуры в docker-compose. Для установки необходимой одноименной платформы смотрим инструкцию Установка Docker на Linux.
После мы можем переходить к поднятию контейнеров.
Запуск контейнеров с СУБД
Как говорилось выше, мы будем поднимать наши контейнеры с помощью docker-compose.
postgresql_01/postgresql_02 — названия для сервисов, контейнеры для которых мы будем поднимать.
image — образ, из которого будут создаваться контейнеры. В данном примере мы берем официальный образ postgres.
container_name — имя, которое будет присвоено контейнеру после его запуска. В нашем примере это postgresql_01 и postgresql_02.
restart — режим перезапуска. Говорит, в каких случаях наш контейнер должен стартовать.
volumes — хорошим тоном для работы базы данных в контейнере является проброс каталога хостового компьютера внутрь контейнера. Таким образом, после удаления контейнера данные останутся на компьютере. В нашем примере в каталоге /data будут созданы каталоги postgresql_01 и postgresql_02, которые будут прокинуты в каталог /var/lib/postgresql/data контейнера.
environment — для первого запуска необходима инициализация базы данных. Без пароля системы выдает ошибку. Поэтому мы задаем переменную среды POSTGRES_PASSWORD.
Условимся, что первичный сервер или master будет в контейнере с названием postgresql_01. Вторичный — postgresql_02. Мы будем настраивать потоковую (streaming) асинхронную репликацию.
Настройка на мастере
Подключаемся к контейнеру docker:
docker exec -it postgresql_01 bash
Заходим под пользователем postgres:
su - postgres
Создаем пользователя, под которым будем подключаться со стороны вторичного сервера:
createuser --replication -P repluser
* в данном примере будет создаваться учетная запись repluser с правами репликации.
Система потребует ввода пароля. Придумываем его и набираем дважды.
Выходим из-под пользователя postgres:
exit
Выходим из контейнера:
exit
Открываем конфигурационный файл postgresql.conf:
vi /data/postgresql_01/postgresql.conf
Приводим к следующием виду некоторые параметры:
wal_level = replica

max_wal_senders = 2

max_replication_slots = 2

hot_standby = on

hot_standby_feedback = on
* где
wal_level указывает, сколько информации записывается в WAL (журнал операций, который используется для репликации). Значение replica указывает на необходимость записывать только данные для поддержки архивирования WAL и репликации.
max_wal_senders — количество планируемых слейвов;
max_replication_slots — максимальное число слотов репликации (данный параметр не нужен для postgresql 9.2 — с ним сервер не запустится);
hot_standby — определяет, можно или нет подключаться к postgresql для выполнения запросов в процессе восстановления;
hot_standby_feedback — определяет, будет или нет сервер slave сообщать мастеру о запросах, которые он выполняет.
Посмотрим подсеть, которая используется для контейнеров с postgresql:
И добавляем строку после остальных «host replication»:
host replication all 172.19.0.0/16 md5
* в данном примере мы разрешили подключение пользователю replication из подсети 172.19.0.0/16 с проверкой подлинности по паролю.
Перезапустим докер контейнер:
docker restart postgresql_01
Настройка на слейве
Выполним настройку вторичного сервера. Для начала, удалим содержимое рабочего каталога вторичной базы:
rm -r /data/postgresql_02/*
* в данном примере мы удалим все содержимое каталога /data/postgresql_02.
Мы должны быть уверены, что в базе нет ничего важного. Только после этого стоить удалять данные.
Заходим внутрь контейнера postgresql_02:
docker exec -it postgresql_02 bash
Выполняем команду:
su - postgres -c "pg_basebackup --host=postgresql_01 --username=repluser --pgdata=/var/lib/postgresql/data --wal-method=stream --write-recovery-conf"
* где postgresql_01 — наш мастер; /var/lib/postgresql/data — путь до каталога с данными слейва.
Система должна запросить пароль для пользователя repluser — вводим его. Начнется процесс репликации, продолжительность которого зависит от объема данных.
Проверка
Смотрим статус работы мастера:
docker exec -it postgresql_01 su - postgres -c "psql -c 'select * from pg_stat_replication;'"
Смотрим статус работы слейва:
docker exec -it postgresql_02 su - postgres -c "psql -c 'select * from pg_stat_wal_receiver;'"
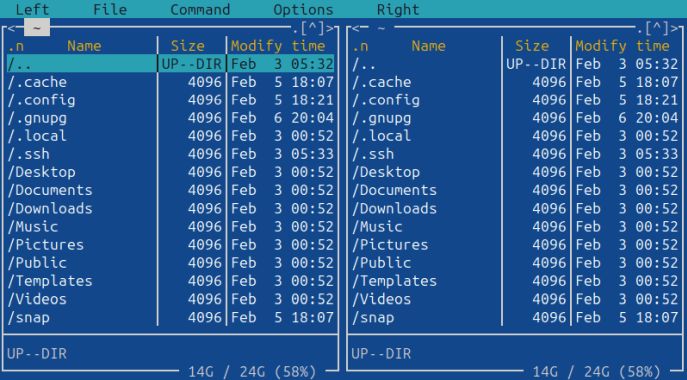
Midnight Commander — консольный файловый менеджер для Linux
Если вам часто необходимо работать с большим количеством файлов в консольном окружении из под Linux, то есть достаточно удобный. В консольном окружении для работы с файлами вы должны знать основные команды и их синтаксис. К счастью, в Linux также имеется текстовый файловый менеджер, работающий в консольном окружении. Он называется Midnight Commander или в простонародье MC. Читать →
Сервер Ansible: CentOS Linux release 7.9.2009 (Core).
Node 1: CentOS Linux release 7.9.2009 (Core).
Node 2: CentOS Linux release 7.9.2009 (Core).
Node 3: CentOS Linux release 7.9.2009 (Core).
Node 4: CentOS Linux release 7.9.2009 (Core).
1. Задача.
К примеру, нам требуется с помощью внедрения custom facts для Ansible организовать сбор версий контейнеров, запущенных на серверах, а так же сбор версий некоторого программного обеспечения на серверах, которое имеет файл с указанием версии в своём каталоге /ecp/po/version.txt.
Собранная информация должна формироваться в json-формат.
Дополнительно требуется рассмотреть средства визуализации информации в удобном виде (opensource web-приложения).
2. Решение задачи.
Решение будет состоять из нескольких этапов:
загрузка и выполнение скрипта на узлах с целью получить json файлы;
выгрузка файлов json с узлов;
склеивание узловых файлов json в один сводный файл;
просмотр сводного файла.
В системе Ansible есть возможность собирать системную информацию, которая собирается в виде фактов с помощью встроенного модуля setup.
Со сбором стандартных переменных по умолчанию всё предельно ясно, но что делать, если мы хотим сформировать наши собственные переменные на всех хостах, чтобы в дальнейшем использовать их в нашем коде?
Для этого существует возможность добавления Custom facts, что делается следующим образом:
на любом хосте, контролируемом Ansible, создаётся каталог /etc/ansible/facts.d;
внутри каталога размещаются один либо несколько файлов с расширением *.fact, например custom.fact;
файлы возвращают данные в формате json.
Создаем инвентарь test-servers.inventory на 4 тестовых сервера:
Создаем специальный custom.fact файл для загрузки на узлы, который, по сути, является скриптом для выполнения некоторого комплекса действий на удалённом узле.
По замыслу будут собираться некоторые переменные и заворачиваться в разметку json.
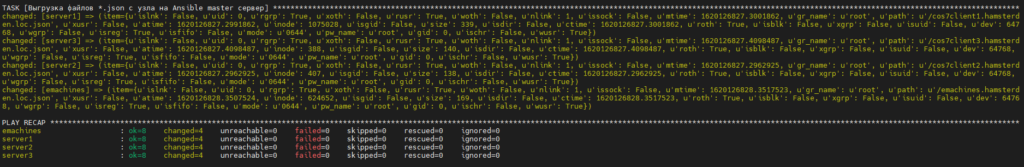
Создаём специальный playbookcustom-facts-fetch.yml, содержащий сценарий /ansible/files/custom.fact для узла, возвращающий некоторый файл json на Ansible master сервер с каждого узла:
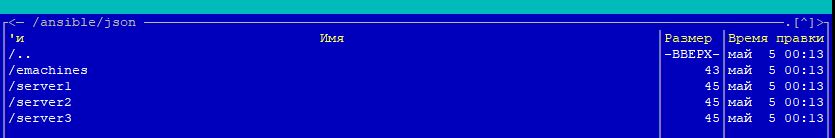
После успешной отработки playbook на сервере Ansible master появится каталог /ansible/json с подкаталогами ‘имя_узла‘:
В каждом из которых будет находиться json файл вида имя_узла.json:
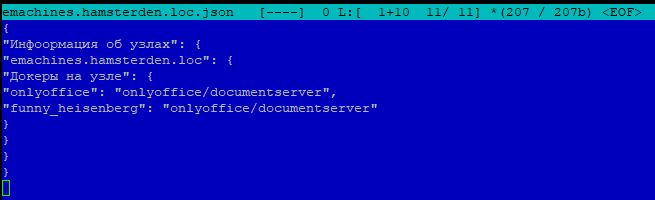
Содержимое json файла первого узла emachines:
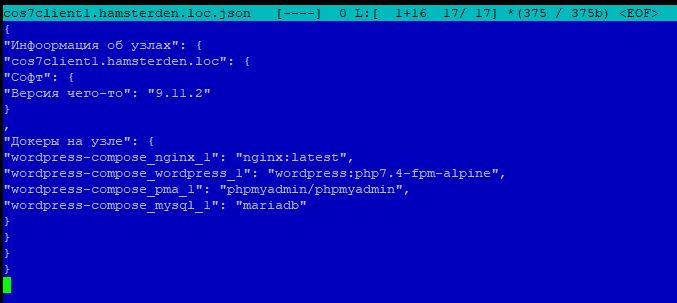
Содержимое json файла второго узла server1:
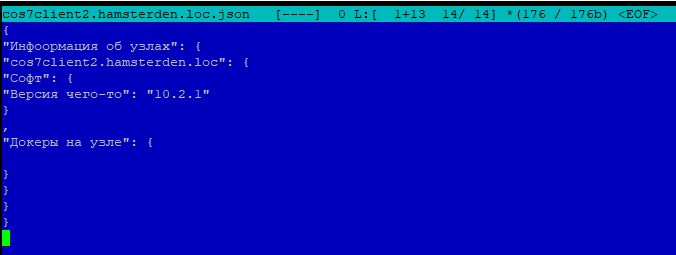
Содержимое json файла третьего узла server2:
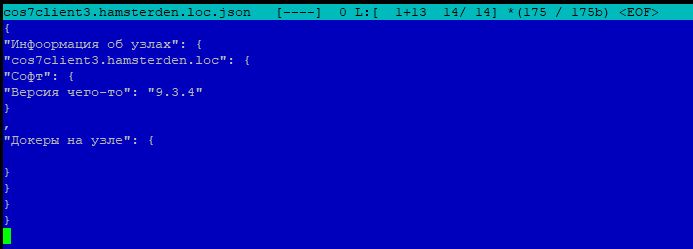
Содержимое json файла четвертого узла server3:
Получилось несколько файлов json, по файлу с каждого целевого узла.
Сколько узлов мы задействовали для Ansible custom facts, столько и json файлов и будет.
В первом файле emachines.hamsterden.loc.json не имеется фрагмент с названием «Версия чего-то‘, по втором файле cos7client1.hamsterden.loc.json такой фрагмент имеется, а так как в custom.fact реализована проверка на фактическое наличия файла /ecp/po/version.txt.
К примеру, наличие файла /ecp/po/version.txt бывает только у серверов типа «web-server». Так как скрипт «сам учитывает» тип сервера, то можно смело применять custom.fact на все целевые серверы и файл json всегда будет генерироваться корректно для каждого типа серверов.
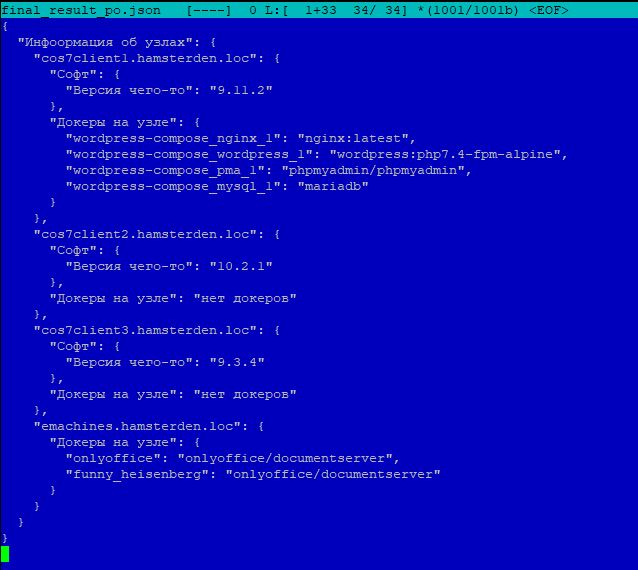
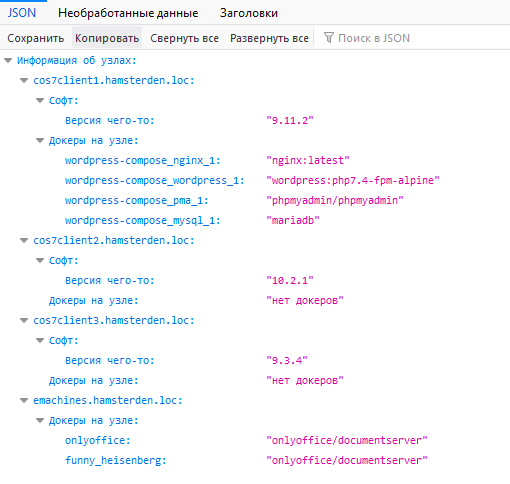
Для создание сводного json файла по всем файлам со всех узлам, воспользуемся утилитой jq.