2. Ansible Vault для хранения конфиденциальных данных.
Если ваши плейбуки Ansible содержат конфиденциальные данные, такие как пароли, ключи API и учетные данные, важно обеспечить их безопасность с помощью шифрования. Ansible предоставляет ansible-vault для шифрования файлов и переменных.
Несмотря на то, что любой файл данных Ansible, а также двоичные файлы, возможно зашифровать изначально, чаще для шифрования переменных файлов, содержащих конфиденциальные данные, используется ansible-vault. После шифрования файла с помощью этого инструмента вы сможете выполнять, редактировать или просматривать его, только предоставив соответствующий пароль, указанный при первом шифровании файла.
2.1. Создание нового зашифрованного файла.
Вы можете создать новый зашифрованный файл Ansible с помощью:
# ansible-vault create credentials.yml
Эта команда выполнит следующие действия:
Сначала вам будет предложено ввести новый пароль. Вам нужно будет указывать этот пароль при каждом доступе к содержимому файла, будь то редактирование, просмотр или просто запуск плейбука или команд с использованием его значений.
Затем откроется редактор командной строки по умолчанию, чтобы вы могли заполнить файл требуемым содержимым.
Наконец, когда вы закончите редактирование, ansible-vault сохранит файл как зашифрованный.
2.2. Шифрование существующего файла.
Чтобы зашифровать существующий файл Ansible, вы можете использовать следующую команду:
# ansible-vault encrypt credentials.yml
Эта команда запросит у вас пароль, который вам нужно будет вводить при каждом доступе к файлу credentials.yml.
2.3. Просмотр содержимого зашифрованного файла.
Если вы хотите просмотреть содержимое файла, который ранее был зашифрован с помощью ansible-vault, и вам не нужно изменять его содержимое, вы можете использовать команду:
# ansible-vault view credentials.yml
Она предложит вам указать пароль, который вы выбрали при первом шифровании файла с помощью ansible-vault.
2.4. Редактирование зашифрованного файла.
Чтобы изменить содержимое файла, который ранее был зашифрован с помощью ansible-vault, выполните:
# ansible-vault edit credentials.yml
Эта команда предложит вам указать пароль, который вы выбрали при первом шифровании файла credentials.yml. После проверки пароля откроется редактор командной строки по умолчанию с незашифрованным содержимым файла, что позволит вам внести нужные изменения. По завершении вы можете сохранить и закрыть файл, как обычно, и обновленное содержимое будет сохранено и зашифровано.
2.5. Расшифровка файлов.
Если вы хотите навсегда расшифровать файл, ранее зашифрованный с помощью ansible-vault, вы можете сделать это с помощью следующего синтаксиса:
# ansible-vault decrypt credentials.yml
Эта команда предложит вам ввести тот пароль, который использовался при первом шифровании файла. После проверки пароля содержимое файла будет сохранено на диск в виде незашифрованных данных.
3. Использование нескольких паролей.
Ansible поддерживает для хранилища несколько паролей, сгруппированных по разным идентификаторам. Это полезно, если вы хотите иметь выделенные пароли хранилища для различных сред – для разработки, тестирования и производства.
Чтобы создать новый зашифрованный файл с пользовательским идентификатором хранилища, включите параметр --vault-id вместе с меткой и расположением, где ansible-vault может найти пароль для этого хранилища. Метка может быть любой, а расположение может быть либо prompt (что означает, что команда должна предложить вам ввести пароль), либо путь к файлу паролей.
Это создаст новый идентификатор по имени dev, который использует prompt для получения пароля. Комбинируя этот метод с файлами переменных группы, вы сможете создать отдельные хранилища для каждой среды приложения:
Мы использовали dev и prod в качестве идентификаторов хранилищ, чтобы продемонстрировать, как вы можете создавать отдельные хранилища для каждой среды. Самостоятельно вы можете создать столько хранилищ, сколько захотите, и использовать любой ID.
Теперь, чтобы просмотреть, отредактировать или расшифровать эти файлы, вам необходимо предоставить тот же ID хранилища и источник пароля вместе с командой ansible-vault:
Если вам нужно автоматизировать процесс инициализации серверов в Ansible с помощью стороннего инструмента, вам потребуется способ ввода пароля хранилища без его запроса. Вы можете сделать это, используя файл паролей через ansible-vault.
Файл паролей может быть простым текстовым файлом или исполняемым скриптом. Если файл является исполняемым, выходные данные, созданные ним, будут использоваться в качестве пароля хранилища. В противном случае в качестве пароля хранилища будет использоваться необработанное содержимое файла.
Чтобы применить файл паролей в ansible-vault, необходимо указать путь к файлу паролей при выполнении любой из команд vault:
Ansible не различает контент, который был зашифрован с помощью prompt, и простой файл пароля при условии, что входной пароль один и тот же. С практической точки зрения это означает, что файл можно зашифровать, используя prompt, а затем создать файл пароля для хранения того же пароля, который использовался в методе prompt. Также верно и обратное: вы можете зашифровать содержимое, используя файл паролей, а затем использовать метод prompt, предоставляя тот же пароль при запросе Ansible.
Для большей гибкости и безопасности, чтобы не хранить свой пароль в текстовом файле, вы можете использовать скрипт Python для получения пароля из других источников.
Официальный репозиторий Ansible содержит несколько примеров сценариев, которые вы можете использовать для справки при создании своего скрипта под потребности вашего проекта.
5. Запуск плейбука с зашифрованными данными.
Каждый раз, когда вы запускаете плейбук, в котором используются данные, ранее зашифрованные с помощью ansible-vault, вам нужно будет указывать пароль хранилища в команде playbook.
Если вы использовали параметры по умолчанию и prompt при шифровании данных плейбука, вы можете использовать опцию --ask-vault-pass, чтобы Ansible запрашивал пароль:
Если вы используете данные, зашифрованные с помощью ID, вам нужно указать тот же ID хранилища и источник пароля, который вы использовали при первом шифровании данных:
Сервер Ansible: CentOS Linux release 7.9.2009 (Core).
Node 1: CentOS Linux release 7.9.2009 (Core).
Node 2: CentOS Linux release 7.9.2009 (Core).
Node 3: CentOS Linux release 7.9.2009 (Core).
1. Введение.
Для тех, кто решит изучать Ansible, данный раздел будет крайне полезен. В данном разделе соберу некоторые полезные примеры из повседневной практики, чтобы вы могли понять как работает Ansible и научиться его использовать самостоятельно.
Официальную документацию с официальными примерами всегда можно почитать на сайте разработчиков Ansible.
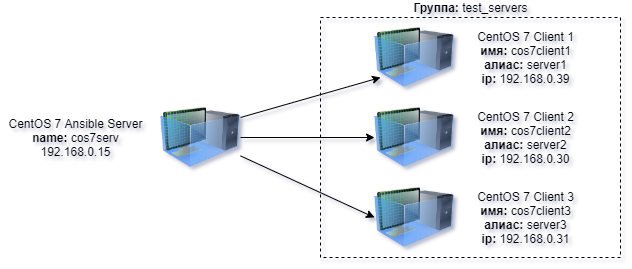
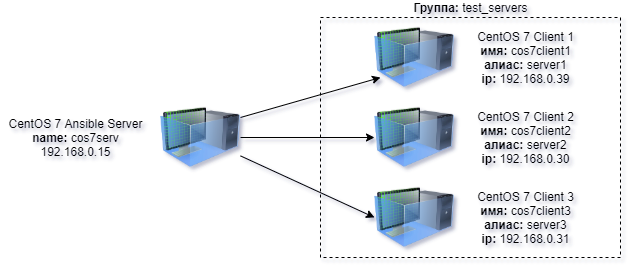
Пускай у нас будет вот такой стенд из 4х виртуальных машин под управлением CentOS 7:
Все сервера, в данном примере, имеют одинаковую операционную систему CentOS Linux release 7.9.2009 (Core), одинаковых пользователей root и одинаковые пароли на учетных записях root.
Задачи: для всех узлов.
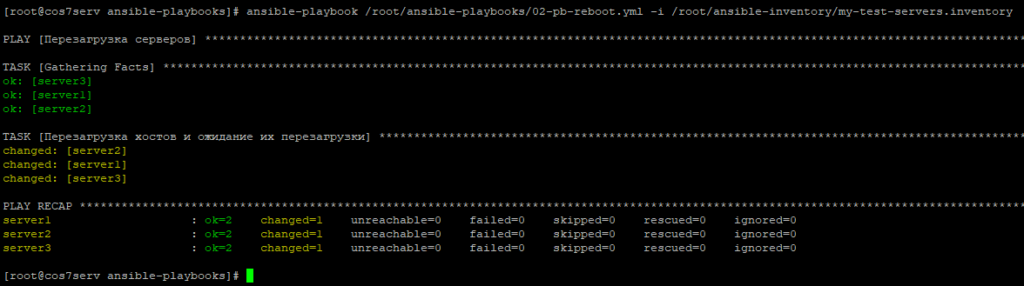
отключить SELinux и перезагрузить узлы;
обновить операционную систему;
установить на всех узлах группу полезных программ Midnight Commander, wget, tar;
настроить межсетевой экран узлов на разрешение соединяться с 80 и 443 портами;
установить web-сервер Nginx и протестировать отдачу тестовой страницы, пробросить готовую композицию HTML5 на узлы;
добавить пользователей myrzik и barsik и настроить режим sudo для них;
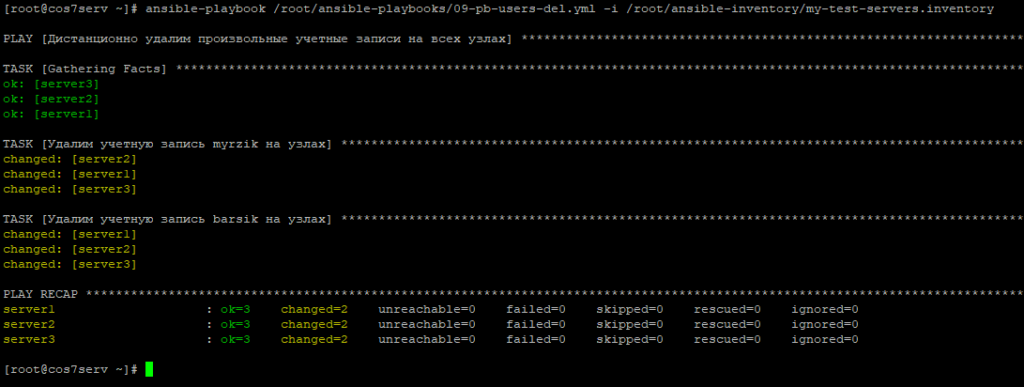
удалить пользователей myrzik и barsik;
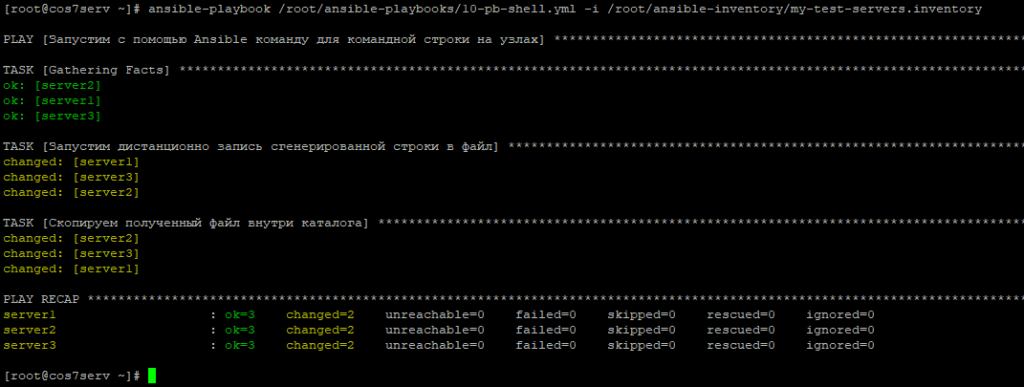
выполнить некоторые произвольные команды для консоли на всех узлах дистанционно.
Протестировать:
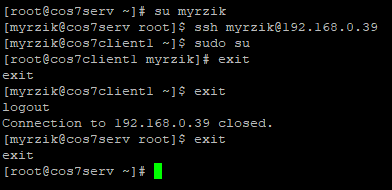
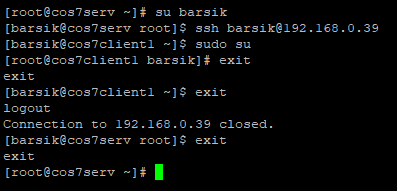
зайти на виртуальные машины под условными пользователями и переключиться в root;
зайти на каждую виртуальную машину по http и увидеть заставку Nginx.
Условие: удалённые виртуальные машины можно настраивать только системой Ansible.
Дополнительно: еще в эту инструкцию я буду добавлять разные новые и полезные примеры, но вверху в задачах, учитывать это не буду.
3. Подготовка сервера Ansible.
Первым делом отключим на Ansible Server систему SELinux. Рамках учебного стенда она нам не нужна.
Когда вы устанавливаете CentOS 7, функция SELinux включена по умолчанию, из-за этого некоторые приложения в вашей системе могут фактически не поддерживать этот механизм безопасности. Чтобы такие приложения функционировали нормально, вам необходимо отключить SELinux.
Конечно в интернете имеется много способов настройки и эксплуатации этой системы, но в данной инструкции я, пока что, настраивать SELinux не буду.
Пожалуй, это самый суровый способ, но тоже работает.
Вводим команду:
# yum -y remove selinux*
Перезапустим Ansible Server:
# shutdown -r now
3.2. Обновление системы.
Обновим полностью операционную систему сервера Ansible:
# yum -y update && yum -y upgrade
3.3. Установка Ansible.
По умолчанию Ansible нет в репозитории CentOS 7.
Подключим дополнительный репозиторий EPEL:
# yum -y install epel-release
После устанавливаем сам сервер управления Ansible:
# yum -y install ansible
Проверка версии установленной версии Ansible:
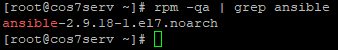
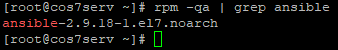
# rpm -qa | grep ansible
Ответ:
или вот так:
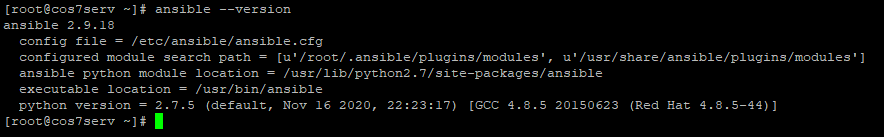
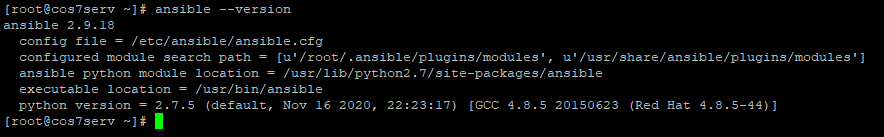
# ansible --version
Ответ:
Отлично! Теперь у нас есть сервер Ansible.
3.4. Создание файла инвентаря.
Установим файловый менеджер и текстовый редактор в одном лице — Midnight Commander:
# yum -y install mc
Файл инвентаря по умолчанию обычно находится в /etc/ansible/hosts, но вы можете использовать опцию -i для указания пользовательских файлов при запуске команд и плейбуков для Ansible.
Это удобный способ настройки индивидуального инвентаря для каждого проекта, который можно включить в системы контроля версий, такие как Git.
Создадим свой файл нашего инвентаря:
# cd ~
# mkdir -p ~/ansible-inventory
# cd ~/ansible-inventory
# touch my-test-servers.inventory
test_servers — это группа серверов, в которую добавлены три сервера с IP-адресами192.168.0.30, 192.168.0.31 и 192.168.0.39;
server 1-3 — это индивидуальные алиасы каждого из серверов группы test_servers в списке инвентаря;
ansible_ssh_host — это специальная переменная, которая содержит IP-адрес узла, к которому будет создаваться соединение;
ansible_ssh_user — это еще одна специальная переменная которая говорит Ansible‘у подключаться под указанным аккаунтом, то есть пользователем. По умолчанию Ansible использует ваш текущий аккаунт пользователя, или другое значение по умолчанию, указанное в ~/.ansible.cfg (remote_user).
3.5. Генерация ключей пользователя root.
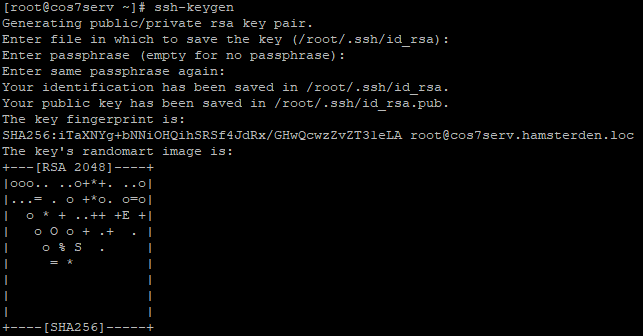
Создаём пару RSA-ключей для пользователя root на Ansible сервере:
# ssh-keygen
На все вопросы жмём Enter. Нам не нужны никакие пароли на ключи и генерируем ключи мы в каталог по умолчанию.
Ответ:
3.6. Проброс root-ключей на узлы.
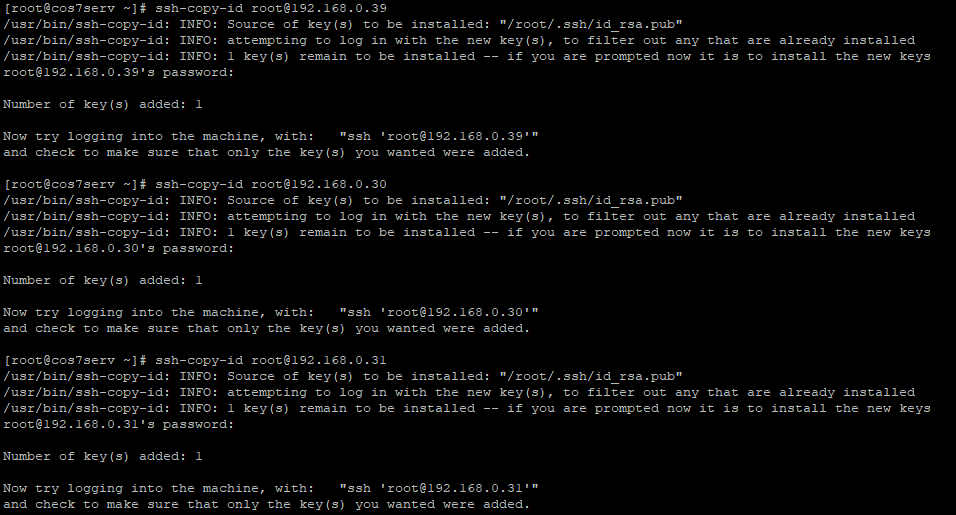
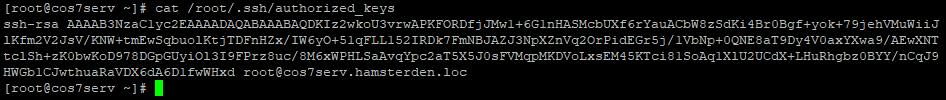
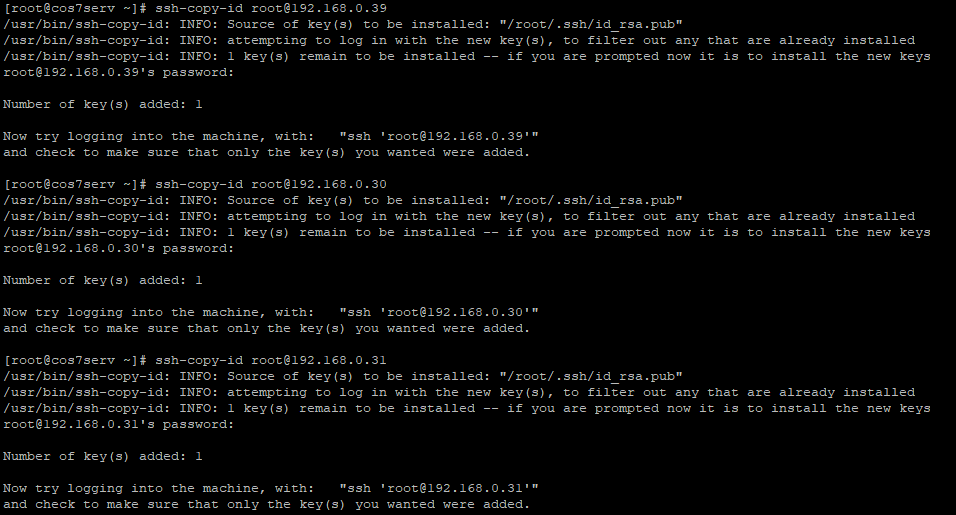
Копируем открытые ключи пользователя root на узлы, которыми планируем управлять с помощью Ansible.
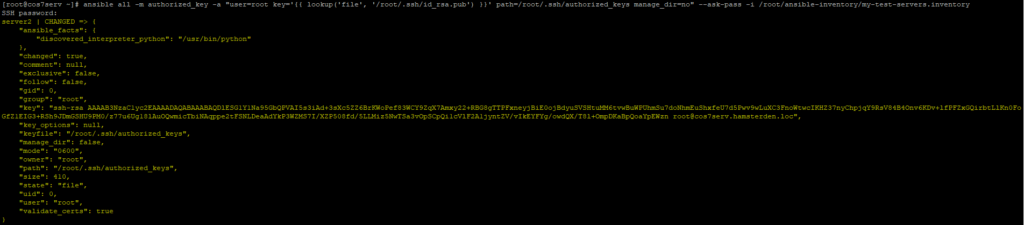
Выполним команду автоматической установки публичного ключа пользователя root на все узлы с авторизацией по паролю, до которых может дотянутся Ansible по списку инвентаря my-test-servers.inventory.
# ansible all -m authorized_key -a "user=root key='{{ lookup('file', '/root/.ssh/id_rsa.pub') }}' path=/root/.ssh/authorized_keys manage_dir=no" --ask-pass -i /root/ansible-inventory/my-test-servers.inventory
Ответ:длинный список изменений на каждом узле.
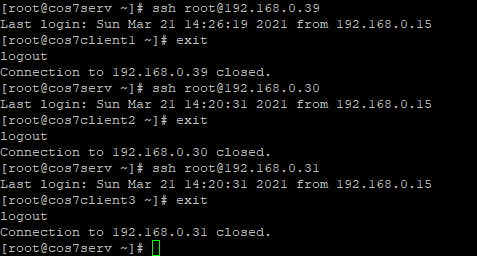
Конечно можно было и вручную всё распространить, у нас узлов 3 штуки, а представьте, если их было бы 10-20 штук:
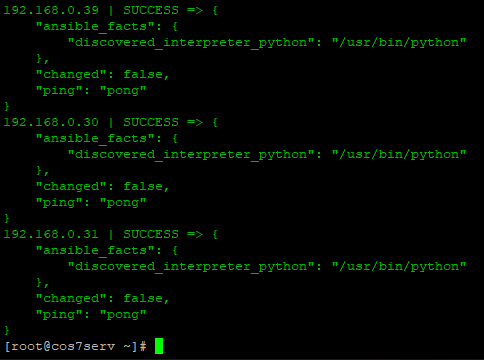
Модуль ping проверит, есть ли у вас валидные учетные данные для подключения к нодам, определенным в файле инвентаря, и может ли Ansible запускать сценарии Python на удаленном сервере от имени root пользователя.
Ответ pong означает, что Ansible готов запускать команды и плейбуки на этом узле.
Ответ:
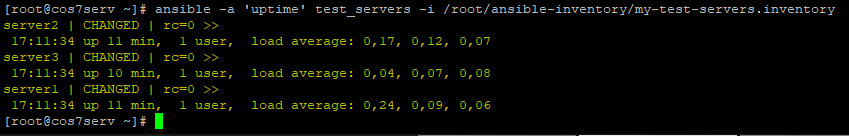
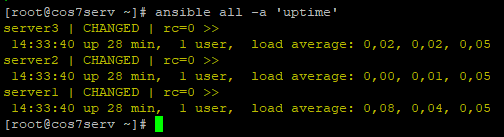
Выполним простую команду 'uptime' для проверки возможности управления узлами:
# ansible -a 'uptime' test_servers -i /root/ansible-inventory/my-test-servers.inventory
Ответ:
3.8. Настройка входа Ansible на самого себя.
Также настроим вход по ключу Ansible Server на самого себя:
Внимание! Почти все типовые действия, которые вам потребуются для работы с Ansible, имеются на официальном сайте с технической документацией по этой системе. Не тратьте на поиски в интернете готовых решений, сразу открывайте официальное руководство пользователя Ansible и ищите там.
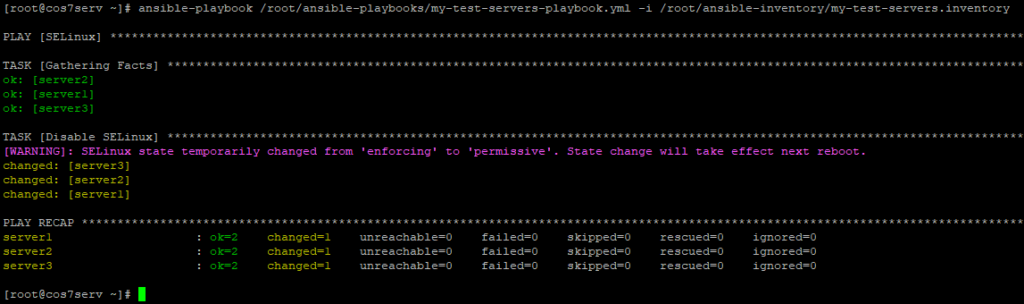
Когда вы устанавливаете CentOS 7, функция SELinux включена по умолчанию, из-за этого некоторые приложения в вашей системе могут фактически не поддерживать этот механизм безопасности. Чтобы такие приложения функционировали нормально, вам необходимо отключить SELinux. Рамках учебного стенда она нам не нужна.
Примечание! После перезагрузки узлов я проверил состояние SELinux на узлах:
# sestatus
Ответ:
Как видно SELinux отключен на всех узлах дистанционно с помощью Ansible.
Примечание! В любой команде Ansible, которая требует перезагрузки после изменения узел будет перезагружен, когда playbook завершится, а затем Ansible будет ждать, пока узел не станет доступным, и ssh будет работать, прежде чем перейти к следующему плейбуку.
Примечание! Если вам нужно перезагрузиться на полпути через playbook вы можете заставить все задачи выполниться с помощью команды:
- name: Reboot if necessary
  meta: flush_handlers
Иногда это можно сделать, чтобы что-то изменить, заставить сервер перезагрузиться, а затем проверить, что изменения вступили в силу и все в том же playbook.
4.2. Обновление операционных систем на узлах.
Перед выполнением других учебных задач, обновим операционные системы на узловых серверах с помощью Ansible.
Воспользуемся готовым решением ansible.builtin.yum от создателей Ansible по обновлению программного обеспечения на узлах.
Долго-долго ждём, особенно если это самое первое обновление после установки узловых систем и они ни разу еще не обновлялись до этого.
После некоторого всплеска активности CPU на узлах Ansible всё завершилось.
Ответ:
Все пакеты на узлах успешно обновлены до последнего актуального состояния из доступных узлам репозиториев.
4.3. Установка группы полезных программ.
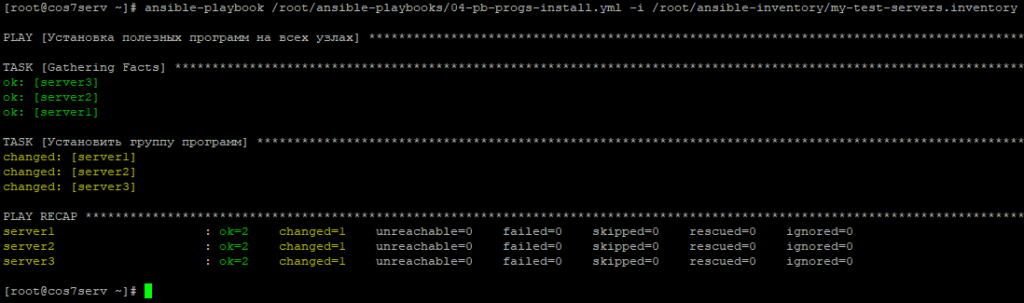
Про учебному сценарию требуется установить пакет программного обеспечения, который состоит из традиционного набора программ для многих серверов: mc, wget, tar.
Снова воспользуемся готовым решением ansible.builtin.yum от создателей Ansible по установке программного обеспечения mc, wget, tar на узлах.
---
- name: Установка полезных программ на всех узлах
  hosts: test_servers
  become_method: sudo
  become_user: root

  tasks:
  - name: Установить группу программ
    yum:
      name: "{{ package }}"
    vars:
      package:
      - mc
      - wget
      - tar
      state: latest
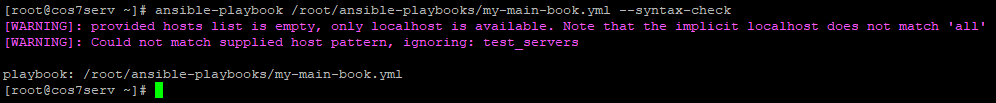
Проверим синтаксис плейбука 04-pb-progs-install.yml специальной утилитой --syntax-check от Ansible:
Все пакеты на узлах успешно установлены программы mc, wget, tar из доступных узлам репозиториев.
4.4. Настройка межсетевого экрана.
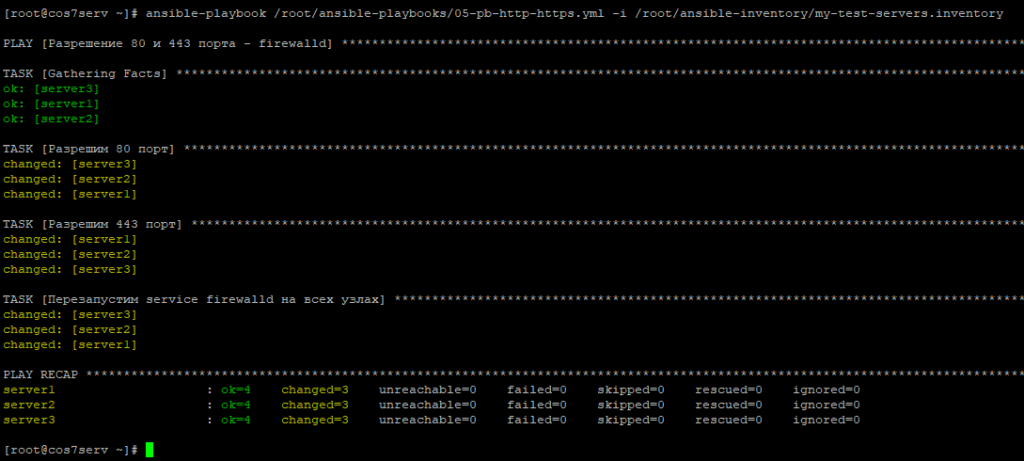
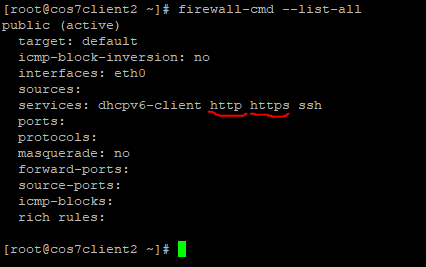
Для успешной и безопасной работы любого сервера первым делом требуется настраивать его сетевую безопасность. Настроим разрешение обращаться к узлам по 80 порту и 443 порту.
Воспользуемся готовым решением ansible.posix.firewalld от создателей Ansible по настройке межсетевого экрана firewalld на узлах.
Отдельно установим модуль ansible.posix.firewalld на Ansible сервер:
# ansible-galaxy collection install ansible.posix
Ответ:
Ansible поменяет настройки в файлах конфигурации firewalld. Для того, чтобы новые настройки были задействованы, требуется перезапустить firewalld на узлах.
В этом перезапуске службы межсетевого экрана нам поможет модуль ansible.builtin.service от создателей Ansible.
По умолчанию index.html — заставка Nginx, хранится в каталоге /usr/share/nginx/html на узлах, значит, если её принудительно заменить на что-то другое, то Nginx это будет добросовестно показывать.
В копировании содержимого Ansible каталога в другой каталог узлов, поможет модуль ansible.builtin.copy.
Заранее скачайте заставку на HTML5 и распакуйте её в каталог /root/ansible-files/nginx/ntml5/zastavka. Будем копировать содержимое этого каталога на узлы Ansible.
--
- name: Копирование каталогов Ansible в каталог узлов
  hosts: test_servers
  become_method: sudo
  become_user: root

  tasks:
# Копируйте дважды, так как иногда файлы пропускаются (в основном только один файл пропускается из папки, если папка не существует).
  - name: Копирование из каталога в каталог
    copy:
      src: "/root/ansible-files/nginx/html5/zastavka/"
      dest: "/usr/share/nginx/html/"
      owner: root
      group: root
      mode: 0644
      backup: yes
    ignore_errors: true
Примечание: Если вы передаете несколько путей с помощью переменной, тогда:
src: "/ корень / {{элемент}}"
Примечание: Если вы передаете путь, используя переменную для разных элементов, тогда:
src: "/ root / {{item.source_path}}"
Проверим синтаксис плейбука 07-pb-nginx-html5.yml специальной утилитой --syntax-check от Ansible:
Проверим доступность новой демонстрационной страницы HTML web-сервера на узлах Ansible.
Наберем в браузере адрес какого-нибудь узла:
# http://192.168.0.39
Ответ на всех узлах одинаковый:
Web-сервер получил новую заглушку HTML5 и Nginx поменял страничку приветствия, которая была по умолчанию.
4.6. Добавить пользователей с sudo.
Для обслуживания тестовых серверов создадим пару учетных записей для самых трудолюбивых сотрудников, которые будут работать не покладая лапок. Учетный записи для пользователей: Мурзик и Барсик.
Создадим на самом сервере Ansible двух пользователей: myrzik и barsik. Генерируем для них ключи. Можно и готовые ключи использовать для установки на узлах, но у меня их нет. Барсик с Мурзиком не прислали ключи.
Создание:
# adduser myrzik
# adduser barsik
Установка паролей, чтобы они могли заходить на сервер Ansible:
# passwd myrzik
# passwd barsik
Генерируем для них ключи:
# su myrzik
# ssh-keygen
На все вопросы для myrzik просто жмём Enter.
# su barsik
# ssh-keygen
На все вопросы для barsik просто жмём Enter.
Теперь у нас на сервере Ansible появилось две учетные записи для наших пушистых коллег.
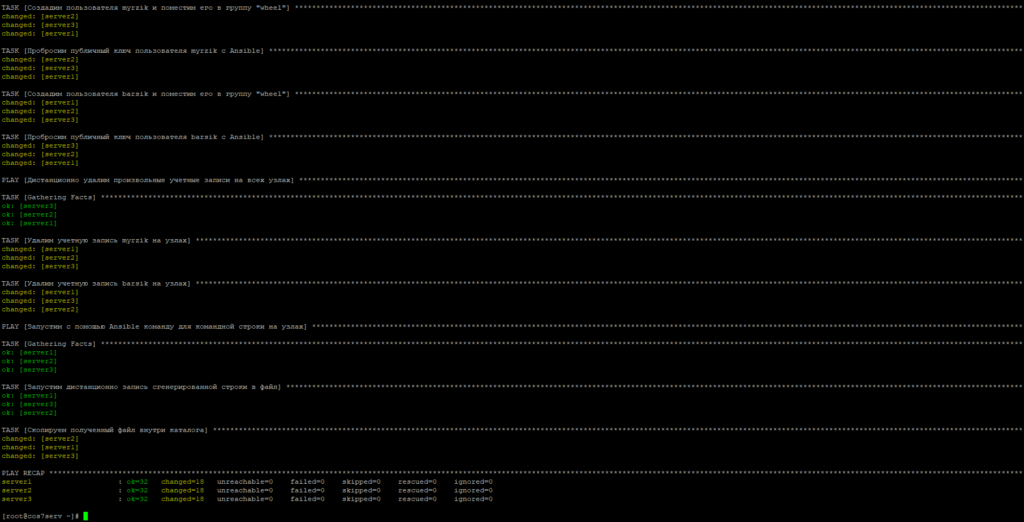
Добавим на узлы с помощью Ansible учетные записи пользователей myrzik и barsik вход по ключам, а так же режим sudo без пароля для них.
В работе Ansible с учетными записями пользователей поможет модуль ansible.builtin.user.
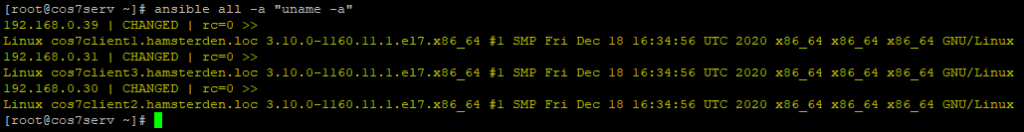
Команда для командной строки на узлах Ansible исполнена.
Есть еще способы запустить консольную команду:
---
- name: Установка zabbix-agent на узлах
  hosts:
    cos7client1
    cos7client2
    cos7client3
  become_method: sudo
  become_user: root

  tasks:
  - name: Установка репозитория docker и установка docker на узлы
    ansible.builtin.shell: "curl -fsSL https://get.docker.com/ | sh"

  - name: Поставим в автозапуск docker на узлах
    ansible.builtin.service:
      name: docker
      enabled: yes

  - name: Запустим docker на узлах
    ansible.builtin.service:
      name: docker
      state: started

  - name: Версия docker на узлах
    ansible.builtin.shell: docker info

  - name: Executing a Command Using Shell Module
    shell: docker info

  - name: Executing a command using command module
    command: docker info
Для того, что бы увидеть что выводит команда в консоль узла, введите ключ -vvv:
Если ваши плейбуки должны работать в определённом порядке и если все они являются обязательными, то создайте Основную книгу и включите файлы с задачами с помощью операторов import_playbook.
Для Ansible практически каждый YAML файл начинается со списка. Каждый элемент списка — список пар «ключ-значение», часто называемая словарем.
В начале сценария обязательно должна присутствовать последовательность символов ‘---‘ (так в YAML обозначается начало документа).
Перед каждым новым разделом списка ставится дефис ( - ):
---
- name: Операции с SELinux
  hosts: webservers
  become_method: sudo
  become_user: root

  tasks:
  - name: Отключаем SELinux
    selinux:
      state: disabled
Основными параметрами/группами простого сценария являются:
hosts — в нем указываются управляемые узлы или группы узлов, к которым нужно применить изменения;
tasks — здесь описывается состояние, в которое необходимо привести управляемый узел, альтернативой этому могут служить роли;
Также в сценарии перед непосредственным описанием задач могут быть указаны следующие параметры или группы параметров:
gather_facts — собирать или нет информацию об узлах перед выполнением задач, по умолчанию — да;
vars — в нем указываются различные переменные, которые будут использованы при выполнении сценария;
connection — можно указать метод соединения с узлами: pure ssh, paramiko, fireball, chroot, jail, local, accelerate (применимо также для выполнения отдельного модуля);
sudo — после установления соединения выполнять задачу с привилегиями другого пользователя, по умолчанию другой пользователь — root;
sudo_user — в сочетании с предыдущим параметром можно указать с привилегиями какого именно пользователя будет выполнена задача;
vars_prompt — перед выполнением плейбука Ansible в интерактивном режиме может уточнить указанные в этом разделе параметры;
remote_user (в предыдущих версиях — просто user) — имя пользователя для авторизации на удалённом узле.
Рассмотрим все эти разделы более подробно.
В разделе hosts указывается группа управляемых узлов, к которой будут применены описываемые в сценарии изменения.
Так, строка формата:
hosts: webservers
Это означает, что изменения будут применены к узлам из группы webservers.
Сценарии могут выполняться не только от имени пользователя, под именем которого установлено соединение, но и любого другого.
В следующем примере авторизация на узле будет произведена с именем yourname, но задачи будут выполняться от имени пользователя root (если, конечно, этому пользователю это разрешено):
---
- name: Операции с SELinux
  hosts: webservers
  become_method: sudo
  become_user: yourname
Если добавить параметр ‘user: postgres‘, то все действия будут выполняться с привилегиями пользователя postgres.
В разделе vars указываются переменные, которые будут использованы в сценарии, и их значения:
Ansible не просто выполняет задачи в указанном порядке, но и проверяет их состояние на наличие изменений. Если при выполнении сценария требовалось, например, добавить строку в конфигурационный файл, и в результате выполнения он изменился (необходимой строки действительно не было), то Ansible может выполнить специальную задачу, описанную как обработчик события (handler). Если при выполнении строка уже была в конфигурационном файле, то обработчик выполнен не будет. Обработчики событий описываются в конце сценария. В описании задачи они указываются через параметр notify.
Приведём пример:
---
- hosts: webservers
  vars:
    max_clients: 200

  tasks:
  # генерируем файл конфигурации на основе шаблона
  # и укажем, что требуется выполнить задачу “restart apache”
  # если файл изменился
  - name: write the apache config file
    template:
      src: /srv/httpd.j2
      dest: /etc/httpd.conf
    notify:
    - restart apache
  - name: ensure apache is running
    service:
      name: httpd
      state: started
# раздел описания обработчиков
  handlers:
    - name: restart apache
    # используем модуль service для перезапуска веб-сервера
      service:
        name: httpd
        state: restarted
4. Контроль выполнения.
Допустим, что при выполнении сценария нам нужно проверять определённые переменные или состояния и, в зависимости от них, выполнять или не выполнять какие-либо задачи.
Для этого можно использовать оператор «when»:
tasks:
    # сохраняем файл шаблона и сохраняем результат задачи
    # в переменную last_result
    - template:
        src: /templates/foo.j2
        dest: /etc/foo.conf
      register: last_result
    # проверяем переменную last_result.changed и если она имеет
    # значение true - задача будет выполнена, иначе - будет пропущена
    - command:
        echo 'the file has changed'
        when: last_result.changed
Приведём пример шаблона (часть конфигурации powerdns):
# пароль для подключения к базе данных
gpgsql-password={{ lookup('password', 'credentials/' + inventory_hostname + '/postgresql/powerdns', length=15) }}

# IPv4-адрес, который будет “слушать” powerdns
local-address={{ ansible_default_ipv4.address }}

# IPv6-адрес, который будет “слушать” powerdns
local-ipv6={{ ansible_default_ipv6.address }}

# nsid dns-сервера (EDNS option 3, rfc5001)
server-id={{ ansible_hostname }}
В приведённом примере мы подставляем в шаблон следующие значения:
из заранее собранных фактов об узле:
ansible_default_ipv4.address — основной IPv4-адрес узла;
ansible_default_ipv6.address — основной IPv6-адрес узла;
ansible_hostname — имя узла (результат выполнения команды hostname).
inventory_hostname — имя узла в инвентарном файле;
пароль пользователя powerdns из внешнего источника данных (в данном случае файл) для подключения к базе Postgresql , полученный с помощью lookup-плагинаpassword из стандартной поставке. Особенность некоторых lookup-плагинов — если данных нет, то они могут их генерировать и сохранить для последующего использования.
Обработку шаблонов и, в данном случае, генерацию конфигурационного файла выполняет модуль template; он же может задать необходимые права доступа и изменить владельца/группу:
Внимание! Файл шаблона и файл с паролем пользователя базы данных находятся на машине управления, а результатом будет файл на удалённом узле.
6. Делегирование задачи другому узлу.
Иногда требуется выполнить задачу на определённом узле, но в контексте другого узла.
Например, во время обновления узла может возникнуть необходимость отключить для него мониторинг, находящийся на отдельном сервере. Для этого используется управляющая директива delegate_to.
Приведём пример:
- name: disable nagios alerts for this host webserver service
  nagios:
    action: disable_alerts
    host: {{inventory_hostname}}
    services: dnsserver
  delegate_to: mon_host.example.com
Результатом выполнения этой задачи будет отключение сообщений для сервиса dnsserver в Nagios.
7. Роли.
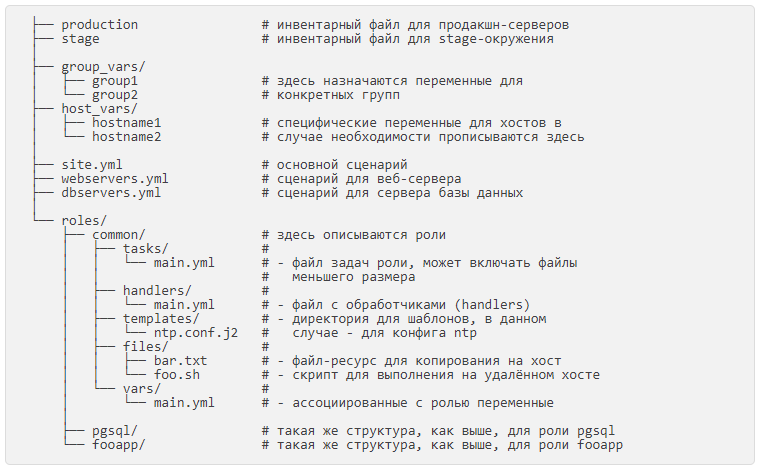
Ролью называется типовой набор переменных и задач, назначаемых для одного или нескольких серверов. Если вам нужно применить к серверу или группе серверов типовой набор операций, вам достаточно просто назначить ему роль. Предварительно в проекте каталоге проекта должна быть создана соответствующая структура.
В сценариях роли назначаются следующим образом:
---
- name: check and apply basic configuration to all hosts
   hosts: all
   roles:
     - common

- name: check and apply configuration to group1
   hosts: group1
   roles:
     - pgsql

- name: check and apply configuration to group2
   hosts: group2
   roles:
     - fooapp
8. Структура проекта.
9. Пишем первые playbook’и.
Playbook может состоять из списка обслуживаемых серверов, переменных пользователя, задач, обработчиков (хендлеров) и так далее. Большинство настроек конфигурации можно переопределить в playbook. Каждый playbook состоит из одного или более действия (игры) в списке.
Цель игры — связать группу хостов с предопределенными ролями, представленными как вызов задач Ansible.
В качестве другого примера давайте рассмотрим процесс установки nginx.
Создадим директорию, где будут хранится playbooks:
# mkdir ~/ansible/playbooks
Создадим файл setup_nginx.yml в директории playbooks со следующим содержанием:
---
- hosts: experiments
  tasks:
  - name: Install nginx package
    apt:
      name: nginx
      update_cache: yes
    sudo: yes
  - name Starting nginx service
    service:
      name: nginx
      state: started
    sudo: yes
Давайте рассмотрим содержимое:
hosts: Список узлов или группа, на которой вы запускаете задачу.
Это поле обязательное и каждый playbook должен иметь его, за исключением ролей. Если указана узловая-группа, сначала Ansible ее ищет в playbook, а затем в файле inventory.
Узнать, на каких узлах будет происходить работа, можно командой:
# ansible-playbook --list-host
где – путь к вашему playbook (playbooks/setup_nginx.yml).
tasks: Задачи. Все playbooks содержат задачи.
Задача — это список действий, которые вы хотите выполнить. Поле задачи содержит имя задачи (справочная информация о задаче для пользователя playbook), модуль, который должен быть выполнен и аргументы, требуемые для модуля. Параметр «name» может добавляться опционально, но, в целом, рекомендуемый.
10. Пример сценария.
В этом примере первое воспроизведение предназначено для web-серверов, а второе — для серверов баз данных:
Пример сценария:
---
- name: update web servers
  hosts: webservers
  remote_user: root

  tasks:
  - name: ensure apache is at the latest version
    yum:
      name: httpd
      state: latest
  - name: write the apache config file
    template:
      src: /srv/httpd.j2
      dest: /etc/httpd.conf

- name: update db servers
  hosts: databases
  remote_user: root

  tasks:
  - name: ensure postgresql is at the latest version
    yum:
      name: postgresql
      state: latest
  - name: ensure that postgresql is started
    service:
      name: postgresql
      state: started
11. Практические примеры плейбуков.
По данной ссылке я создам небольшую подборку типовых плейбуков, которые могут пригодиться вам в повседневной работе.
Чтобы запустить плейбук и выполнить все определенные в нем задачи, используйте команду ansible-playbook:
# ansible-playbook myplaybook.yml
Чтобы перезаписать в плейбуке опцию hosts по умолчанию и ограничить выполнение определенной группой или узлом, включите в команду опцию -l:
# ansible-playbook -l server1 myplaybook.yml
13. Запрос информации о play.
Опция --list-tasks используется для перечисления всех задач, которые будут выполнены в play, при этом не внося никаких изменений на удаленные серверы:
# ansible-playbook myplaybook.yml --list-tasks
Точно так же можно запросить все узлы, которые будут затронуты выполнением play, без запуска каких-либо задач на удаленных серверах:
# ansible-playbook myplaybook.yml --list-hosts
Вы можете использовать теги, чтобы ограничить выполнение play.
Чтобы вывести список всех тегов, доступных в play, используйте параметр --list-tags:
# ansible-playbook myplaybook.yml --list-tags
14. Управление выполнением плейбука.
Вы можете использовать опцию --start-at-task, чтобы определить новую точку входа вашего плейбука. Затем Ansible пропустит все, что предшествует указанной задаче, выполнив оставшуюся часть play с заданного момента.
Эта опция в качестве аргумента требует правильное имя задачи:
# ansible-playbook myplaybook.yml --start-at-task="Set Up Nginx"
Чтобы выполнять только задачи, связанные с конкретными тегами, вы можете использовать опцию --tags.
Например, если вы хотите выполнить только задачи, помеченные как nginx или mysql, вы можете использовать:
Если ваши плейбуки Ansible содержат конфиденциальные данные, такие как пароли, ключи API и учетные данные, важно обеспечить их безопасность с помощью шифрования. Ansible предоставляет ansible-vault для шифрования файлов и переменных.
Несмотря на то, что любой файл данных Ansible, а также двоичные файлы, возможно зашифровать изначально, чаще для шифрования переменных файлов, содержащих конфиденциальные данные, используется ansible-vault. После шифрования файла с помощью этого инструмента вы сможете выполнять, редактировать или просматривать его, только предоставив соответствующий пароль, указанный при первом шифровании файла.
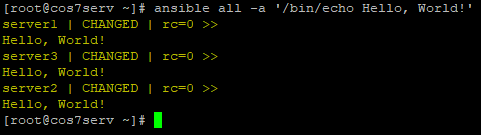
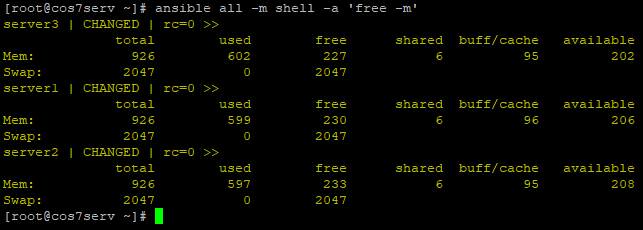
Для того, чтобы понять как работают простые команды Ansible, приведу несколько простых примеров. По аналоги вы всегда сможете придумать свои команды под ваши конкретные ситуации.
2.1. Проверка связи.
С помощью Ansible можно одновременно выполнить одну задачу на целой группе серверов.
Модуль ping проверит, есть ли у вас валидные учетные данные для подключения к нодам, определенным в файле инвентаря, и может ли Ansible запускать сценарии Python на удаленном сервере от имени root пользователя.
2.1.1. Со всеми нодами.
Чтобы убедиться, что Ansible может подключаться к нодам и запускать команды и плейбуки, вы можете использовать следующую команду:
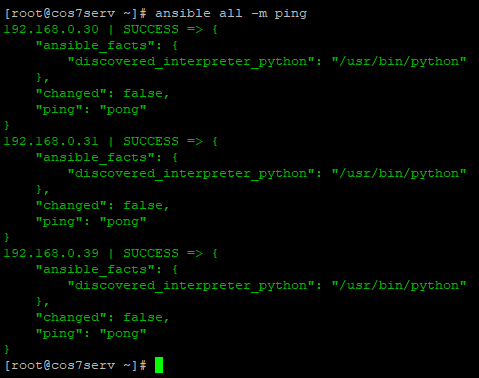
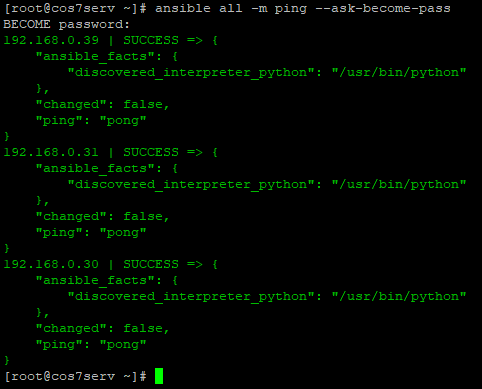
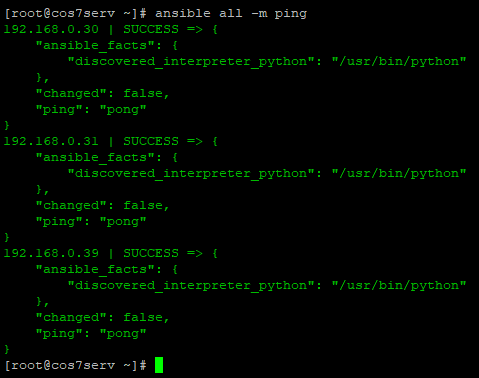
# ansible all -m ping
Ответ pong означает, что Ansible готов запускать команды и плейбуки на этой ноде.
Ответ:
2.1.2. С целевыми хостами.
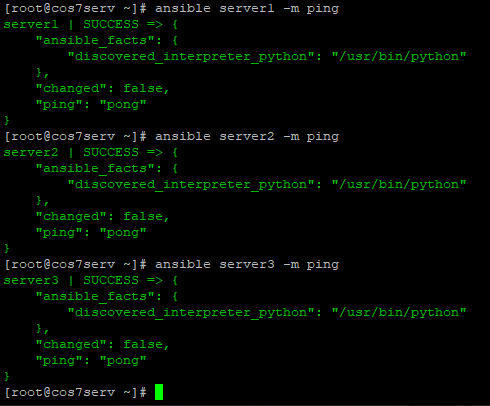
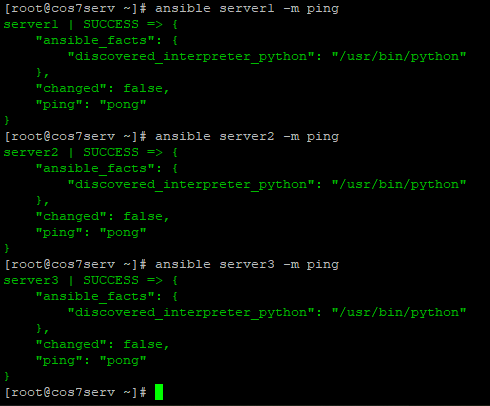
Проверять с целевыми хостами можно и поштучно через их алиасы:
Сервер Ansible: CentOS Linux release 7.9.2009 (Core).
Node 1: CentOS Linux release 7.9.2009 (Core).
Node 2: CentOS Linux release 7.9.2009 (Core).
Node 3: CentOS Linux release 7.9.2009 (Core).
1. Введение.
Представьте себе, что вам нужно управлять парком серверов, расположенных к тому же в разных географических точках. Каждый из этих серверов требует настройки, регулярного обновления и мониторинга. Конечно, для решения этих задач можно воспользоваться самым простым способом: подключиться к каждому серверу по ssh и внести необходимые изменения. При всей своей простоте этот способ сопряжен с некоторыми трудностями: он чрезвычайно трудоемок, а на выполнение однообразных операций уходит очень много времени.
Чтобы упростить процессы настройки и конфигурирования серверов, можно также писать shell-скрипты, но и этот способ вряд ли можно назвать совершенным. Скрипты нужно постоянно изменять, подстраивая их под каждую новую задачу. При их написании необходимо учитывать различие операционных систем и версий. Не будем забывать и о том, что отладка скриптов отнимает много усилий и забирает немало времени.
Оптимальным вариантом решения описанных проблем является внедрение системы удаленного управления конфигурацией. В таких системах достаточно лишь описать нужное состояние управляемого узла. Система должна сама определить, что нужно сделать для достижения этого состояния, и осуществит все необходимые действия.
Со всеми сложностями, о которых идет речь выше, вы наверняка хорошо знакомы на собственном опыте: у вас имеется несколько десятков серверов, расположенных в разных точках планеты. На них необходимо регулярно вносить различные изменения: обновлять операционную систему, устанавливать и обновлять различное программное обеспечение, изменять конфигурацию и тому подобное.
Предлагается все эти операции автоматизировать и внедрить систему удаленного управления конфигурациями.
Так как простые задачи для Ansible реально простые, в буквальном смысле слова, то я принял решение вынести их в отдельную инструкцию:
Ansible — программное решение для удаленного управления конфигурациями, разработанное Майклом Де Хаанном в 2012 году. Название продукта взято из научно-фантастической литературы: в романах американской писательницы Урсулы Ле Гуин была такая штука, как Ansible — это устройство для оперативной космической связи.
Ansible — мощное программное обеспечение автоматизации конфигурирования, с открытым исходным кодом, управления и развертывания приложений на узлах без каких-либо простоев, для работы которого потребуется только SSH. В отличие от подобных продуктов, Ansible устанавливается на единственном хосте, который может даже быть вашей локальной машиной и использует SSH для связи с каждым удаленным узлом. Это позволяет ему быть невероятно быстрым при конфигурировании новых серверов, поскольку не требуются предварительно установленные дополнительные пакеты на каждом новом сервере.
Машина управления, где установлен Ansible и Узлы, управляемая этой машиной по SSH. Местоположение узлов определяется управляющей машиной через её инструментарий. Ansible не требует установки клиентской части или приложения, что означает отсутствие необходимости какой-либо установки агента на удаленных узлах, так что это означает, что нет каких-либо фоновых демонов или программ, выполняемых для Ansible, когда он не управляет узлами.
Другими словами, Ansible — программное обеспечение для централизованного управления конфигурациями, то есть другими операционными системами и установленными на них программами. Это современный инструмент управления конфигурацией, который облегчает задачу настройки и обслуживания удаленных серверов.
Ansible берет на себя всю работу по приведению удаленных серверов в необходимое состояние. Администратору необходимо лишь описать, как достичь этого состояния с помощью так называемых сценариев — специальных файлов «playbook».
В них описывается желаемое состояние управляемой системы, например, необходимо наличие пакета Midnight Commander. Ansible проверяет, соответствует ли удаленный компьютер описанию в плейбуке, и если это не так, приводит его в должный вид. Формат для playbook — YAML. Для описания задачи задается ее имя, используемый модуль и список параметров.
Такая технология позволяет очень быстро осуществлять переконфигурирование системы, для этого достаточно всего лишь добавить несколько новых строк в сценарий.
Пример плейбука:
---
- name: Nginx web server
  hosts: web-servers
  remote_user: root
  tasks:
  - name: Installs nginx web server
    yum:
      pkg: nginx
      state: installed
      update_cache: true
  - name: Push future default virtual host configuration
    copy:
      src: files/site.conf
      dest: /etc/nginx/conf.d/
      mode: 0640
В данном примере мы задаем 2 задачи для группы серверов web-servers — сначала необходимо установить пакет nginx, затем скопировать файл site.conf с сервера на удаленную систему в каталог /etc/nginx/conf.d.
3. Почему Ansible лучше других подобных программ?
По сравнению с другими популярными инструментами автоматизации IT-инфраструктуры, Ansible не требует установки клиентских приложений на обслуживаемые сервера, что может сократить время настройки перед развертыванием инфраструктуры. Для работы Ansible подключается к обслуживаемым серверам по SSH.
Преимущества Ansible по сравнению с другими аналогичными решениями (здесь в первую очередь следует назвать такие продукты, как Puppet, Chef и Salt) заключаются в следующем:
на управляемые узлы не нужно устанавливать никакого дополнительного программного оборудования, всё работает через SSH (в случае необходимости дополнительные модули можно взять из официального репозитория);
код программы, написанный на Python, очень прост;
при необходимости написание дополнительных модулей не составляет особого труда;
язык, на котором пишутся сценарии, также предельно прост;
низкий порог вхождения: обучиться работе с Ansible можно за очень короткое время;
документация к продукту написана очень подробно и вместе с тем — просто и понятно;
документация регулярно обновляется;
Ansible работает не только в режиме push, но и pull, как это делают большинство систем управления (Puppet, Chef);
имеется возможность последовательного обновления состояния узлов (rolling update).
Самостоятельно ознакомиться с Puppet вы можете по моим инструкциям на этом же сайте:
“Из коробки” все сценарии и команды выполняются методом push: когда возникает необходимость, мы запускаем сценарий, и он последовательно выполняется на удалённых серверах. Однако разработчики также предусмотрели метод pull и даже написали специальное приложение для установки необходимой для этого части ansible на удалённые хосты.
5. Как работает Ansible.
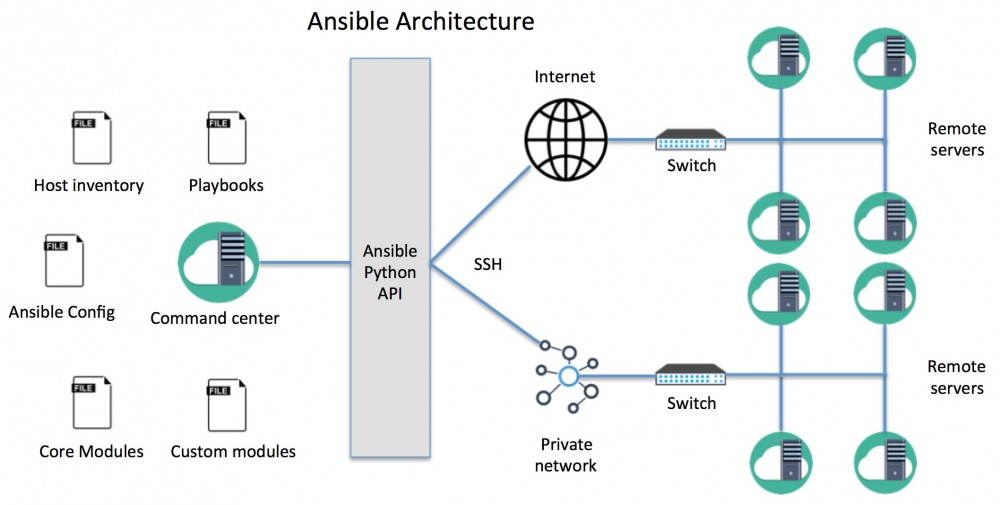
Основная идея Ansible – наличие одного или нескольких управляющих серверов, из которых вы можете отправлять команды или наборы последовательных инструкций (playbooks) на удаленные сервера, подключаясь к ним по SSH.
Файл Host inventory содержит информацию об обслуживаемых серверах, где команды будут исполнены. Файл конфигурации Ansible может быть полезен для указания настроек вашего окружения.
Наборы инструкций (playbooks) состоят из одной или более задач, которые описываются с помощью функциональность модуля ядра Ansible или сторонних модулей, которые могут потребоваться в специфических ситуациях. Сами по себе наборы инструкций — последовательные наборы команд, в которых могут быть проверки условий: если условие не выполняется, определенные команды могут пропускаться.
Также вы можете использовать Ansible API для запуска скриптов. Если скрипту-обертке (wrapper) может потребоваться запуск playbook, это можно сделать через API. Сами playbooks описываются декларативно в формате YAML. Ansible поддерживает сценарии развертывания новых облачных серверов и конфигурирования их на основании ролей. Часть работы может быть проведена в локальном режиме на управляющем сервере, а остальная — на созданном сервере после его первой загрузки.
6. Краткий словарь терминов Ansible.
В этом этой инструкции широко используются такие термины Ansible:
Control Machine или Node — ведущая система, в которой установлен Ansible и откуда он может подключаться к нодам и выполнять на них команды.
Хост — в Ansible хост — это удаленный компьютер, которому назначены отдельные переменные, и они далее группируются вместе. У каждого хоста есть выделенное имя или уникальный IP-адрес, чтобы сделать его идентификацию легкой и быстрой. Им также может быть присвоен простой номер порта, если вам не нужно обращаться к ним через соединение ssh.
Нода или Узел — сервер, управляемый Ansible.
Файл инвентаря — файл, который содержит информацию о серверах, которыми управляет Ansible, обычно находится в /etc/ansible/hosts.
Playbooks — они написаны на языке программирования YAML с минимальным синтаксисом и обычно используются для автоматизации задач при необходимости.
Роль — коллекция плейбуков и других файлов, которые имеют отношение к цели. Например, к установке web-сервера.
Play — полный набор инструкций Ansible. В play может быть несколько плейбуков и ролей, включенных в один плейбук, который служит точкой входа.
Задача — каждая инструкция, определенная в книге игр, называется задачей, которая будет выполняться в дальнейшем для выполнения действия.
Факты — они выводятся из удаленных узлов автоматически при выполнении модулей на удаленных узлах.
Группа — это комбинация хостов, которые назначены пулу, и переменные также могут совместно использоваться.
Инвентаризация — инвентаризация является важным компонентом ANSI удаленного механизма, который описывает хосты, группы и так далее. С помощью IP-адреса или номера порта и так далее. Таким образом, вы можете определить все хосты в одном файле для быстрого доступа.
API — это транспортная среда для различных облачных сервисов, как частных, так и общедоступных.
Модули — с помощью playbook модули могут быть выполнены на удаленных узлах напрямую. Кроме того, его можно использовать для управления службами, ресурсами, пакетами, файлами или командами и так далее. Модули являются основными компонентами, которые помогают устанавливать пакеты, позволяют API-интерфейсам взаимодействовать друг с другом и планировать действия для системных файлов. В Ansible есть множество модулей, которые запрограммированы для автоматизации практически всего внутри инструмента.
Плагины — это специальные части кода, которые помогают быстро писать код. Плагины автоматизируют задачи разработки и помогают максимально ускорить работу по развертыванию. Ansible оснащен различными удобными плагинами, которые можно использовать при необходимости, чтобы упростить вам задачу.
Оркестровка — это общий термин, который часто используется в техническом мире. Почему это важно и в Ansible? Для разных программных продуктов значение оркестровки может быть различным. Ansible использует его в качестве дирижера для управления оркестром.
7. Установка.
Обновим операционную систему:
# yum -y update && yum -y upgrade
По умолчанию Ansible нет в репозитории CentOS 7 — устанавливаем репозиторий EPEL:
# yum -y install epel-release
После устанавливаем сам сервер управления:
# yum -y install ansible
Где система автоматически обновит список пакетов с учетом нового репозитория и начнет установку Ansible.
Проверка версии установленной версии Ansible:
# rpm -qa | grep ansible
Ответ:
или
# ansible --version
Ответ:
8. Настройка Ansible.
Файл конфигурации описывается в INI–формате. Вы можете переопределить часть или всю конфигурацию в параметрах playbook или переменных окружения.
При исполнении команд Ansible проверяет наличие файла конфигурации в следующих расположениях:
проверяется переменная окружения ANSIBLE_CONFIG, которая может указывать на файл конфигурации;
./ansible.cfg – в текущей директории;
~/.ansible.cfg — в домашней директории;
/etc/ansible/ansible.cfg — в каталоге, сгенерированном при установке Ansible через менеджер пакетов.
9. Настройка через переменные окружения.
Большинство параметров конфигурации можно установить через переменные окружения, используя префикс ANSIBLE_ перед названием параметра конфигурации (большими буквами).
Например:
export ANSIBLE_SUDO_USER=root
После этого переменная ANSIBLE_SUDO_USER может быть использована в playbook.
10. Параметры конфигурации.
Параметров конфигурации Ansible множество.
Давайте рассмотрим некоторые из них:
hostfile: Параметр указывает на путь к inventory file, в котором содержится список адресов хостов, к которым Ansible может подключиться.
Например: hostfile = /etc/ansible/hosts
library: Путь к директории, где хранятся модули Ansible.
Например: library = /usr/share/ansible
forks: Количество процессов, которые может породить Ansible. По умолчанию установлено 5 процессов.
Например: forks = 5
sudo_user: Пользователь по умолчанию, от которого Ansible запускает команды на удаленных серверах.
Например: sudo_user = root
remote_port: Порт для соединения по SSH (по умолчанию 22).
Например: remote_port = 22
host_key_checking: Параметр позволяет отключить проверку SSH-ключа на хосте. По умолчанию проверка выполняется.
Например: host_key_checking = False
timeout: Значение таймаута попытки подключения по SSH.
Например: timeout = 60
log_path: Путь для хранения файлов логов. По умолчанию Ansible не хранит их совсем, но указав этот параметр можно активировать запись логов.
Например: log_path = /var/log/ansible.log
11. Файл конфигурации ansible.cfg.
По умолчанию список хостов/групп, к которым применяются команды содержится в файле /etc/ansible/hosts:
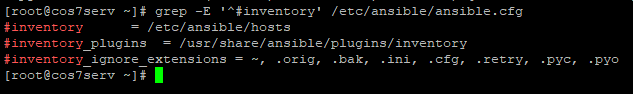
# grep -E '^#inventory' /etc/ansible/ansible.cfg
Ответ:
При необходимости его можно переопределить с помощью опции
--inventory-file(-i)
Пример создания кастомного файла конфигурации.
Подключитесь по SSH к созданному управляющему серверу с установленным Ansible.
Создайте директорию для экспериментов ‘ansible‘ в своём домашнем каталоге и перейдите в него:
# mkdir ~/ansible
# cd ~/ansible
Также создайте каталог для хранения модулей Ansible и каталог для хранения логов:
# mkdir ~/ansible/modules
# mkdir ~/ansible/logs
Создайте файл ansible.cfg со следующим содержимым:
Для экспериментов можно упомянуть, к примеру пару серверов, которые и можно настраивать.
Нужно сообщить Ansible их адреса и сгруппировать их.
Для этого создайте файл inventory в директории ~/ansible/inventory со следующим содержимым:
[experiments]
ip_первой_машины
ip_второй_машины
12. Файл hosts.
Работа с Ansible начинается с настройки его центрального файла списка хостов — так и называется файл hosts.
По умолчанию расположение файла — /etc/ansible/hosts, но оно может также быть задано параметром окружения $ANSIBLE_HOSTS или параметром -i при запуске ansible и ansible-playbook.
Содержимое этого файла может выглядеть, например, так, в квадратных скобках указаны имена групп управляемых узлов, ниже перечисляются входящие в эти группы серверы:
Помимо списка управляемых узлов, в файле hosts могут быть указаны и другие сведения, необходимые для работы: номера портов для подключения по SSH, способ подключения, пароль для подключения по SSH, имя пользователя, объединения групп и тому подобно. В некоторых случаях — в частности, при работе с большими и сложными конфигурациями, — различные параметры можно выносить в отдельные файлы и каталоги.
Более подробно о файле hosts и правилах его написания можно почитать в официальной документации.
Перед внесением изменений Ansible подключается к управляемым узлам и собирает информацию о них: о сетевых интерфейсах и их состоянии, об установленной операционной системе и тому подобное. Он может делать это как с помощью собственного модуля, так и с помощью инструментов ohai и facter, если они установлены (такая возможность специально предусмотрена для пользователей, уже имеющих опыт работы с системами удаленного управления конфигурациями: ohai и facter являются библиотеками фактов для Chef и Puppet).
14. Переменные.
Во время работы, как правило, требуется не только установить какое-либо приложение, но и настроить его в соответствии с определенными параметрами на основании принадлежности к группе серверов или индивидуально (например, IP-адресBGP-соседа и номер его AS или параметры для базы данных).
Как уже было сказано, загромождать файл hosts будет не очень красиво, поэтому разработчики Ansible пошли следующим путём:
файлы с переменными групп хранятся в каталоге ../group_vars/имя_группы;
файлы с переменными хостов в каталоге ../hosts_vars/имя_хоста;
файлы с переменными роли (о них речь пойдет ниже) в директории ../имя_роли/vars/имя_задачи.yml.
Помимо пользовательских переменных можно и даже нужно использовать факты, собранные Ansible перед выполнением сценариев и отдельных задач.
15. Модули Ansible.
В состав Ansible входит огромное количество модулей для развёртывания, контроля и управления различными компонентами, которые можно условно разделить на следующие группы (в скобках приведены названия некоторых продуктов и сервисов):
облачные ресурсы и виртуализация (Openstack, libvirt);
базы данных (MySQL, Postgresql, Redis, Riak);
файлы (шаблонизация, регулярные выражения, права доступа);
мониторинг (Nagios, monit);
оповещения о ходе выполнения сценария (Jabber, Irc, почта, MQTT, Hipchat);
сеть и сетевая инфраструктура (Openstack, Arista);
управление пакетами (apt, yum, rhn-channel, npm, pacman, pip, gem);
система (LVM, Selinux, ZFS, cron, файловые системы, сервисы, модули ядра);
работа с различными утилитами (git, hg).
О том, с чем умеет работать Ansible, можно прочитать в официальной документации. Список действительно впечатляет.
test_servers — это группа серверов, в которую добавлены три сервера с IP-адресами192.168.0.30, 192.168.0.31 и 192.168.0.39;
server 1-3 — это индивидуальные алиасы каждого из серверов группыtest_servers в списке инвентаря;
ansible_ssh_host — это специальная переменная, которая содержит IP-адрес узла, к которому будет создаваться соединение;
ansible_ssh_user — это еще одна специальная переменная которая говорит Ansible‘у подключаться под указанным аккаунтом, то есть пользователем. По умолчанию Ansible использует ваш текущий аккаунт пользователя, или другое значение по умолчанию, указанное в ~/.ansible.cfg (remote_user).
Все сервера, в данном примере, имеют одинаковую операционную систему CentOS Linux release 7.9.2009 (Core), одинаковых пользователей root и одинаковые пароли на учетных записях root.
Открываем конфигурационный файл Ansible (выше по тексту был способ изменить место хранения файла конфигурации):
# mcedit /etc/ansible/ansible.cfg
Снимаем комментарий с опции host_key_checking, приведя ее к виду:
host_key_checking = False
Данная настройка позволит нашему серверу управления автоматически принимать ssh fingerprint, избавляя нас от необходимости постоянно вводить yes, когда мы впервые конфигурируем новый сервер.
Теперь выполним проверку доступности добавленных серверов:
# ansible -m ping test_servers -u root -kK
Данная команда проверит доступность по сети двух серверов из группы test_servers от учетной записи root.
Будет запрошен пароль от учетной записи (в нашем случае, root).
После будет запрошен пароль суперпользователя на серверах.
16.1. Если всё заработало.
На экране должно появиться, примерно, следующее:
Наш сервер управления готов к работе.
16.2. Если не заработало.
Если на экране появится ошибка, введите с сервера Ansible следующую команду:
# ssh root@192.168.0.39
В данном случае, мы пытаемся подключиться к серверу 192.168.0.39 по SSH от пользователя root.
Если подключиться к серверу 192.168.0.39 вышеописанной командой не удалось, возможно введен неправильный пароль или доступ по SSH от root запрещен. В этом случае, создайте служебную учетную запись на сервере 192.168.0.39 и используйте ее для подключения по SSH.
Например, на удаленном сервере вводим:
# useradd ansible-user

# passwd ansible-user
В этом примере мы создали учетную запись ansible-user и задали ей пароль.
Внимание! Обратите внимание, что мы выполняем теперь запрос от пользователя ansible-user.
17. Организация RSA-ключей между серверами.
Для того, что бы Ansible хозяйничал на хостах, требуется включить на целевых для управления хостах разрешение пользоваться аутентификацией по ключам, создать пару RSA-ключей на Ansible Control Machine и копировать открытые ключи на целевые сервера, которыми планируется управлять.
Чтобы убедиться, что Ansible может подключаться к узлам и запускать команды и плейбуки, вы можете использовать следующую команду:
# ansible all -m 'ping'
или, встроенной в Ansible, одноименной утилитой:
# ansible all -m ping
Модуль ping проверит, есть ли у вас учетные данные для подключения к узлам, определенным в файле инвентаря, и может ли Ansible запускать сценарии Python на удаленном сервере от имени root пользователя.
Ответ pong означает, что Ansible готов запускать команды и плейбуки на этом узле.
Ответ:
Проверять с целевыми узлами можно и поштучно через их алиасы:
Если ваши плейбуки Ansible содержат конфиденциальные данные, такие как пароли, ключи API и учетные данные, важно обеспечить их безопасность с помощью шифрования. Ansible предоставляет ansible-vault для шифрования файлов и переменных.
Несмотря на то, что любой файл данных Ansible, а также двоичные файлы, возможно зашифровать изначально, чаще для шифрования переменных файлов, содержащих конфиденциальные данные, используется ansible-vault. После шифрования файла с помощью этого инструмента вы сможете выполнять, редактировать или просматривать его, только предоставив соответствующий пароль, указанный при первом шифровании файла.
Файл инвентаря по умолчанию обычно находится в /etc/ansible/hosts, но вы можете использовать опцию -i для указания пользовательских файлов при запуске команд и плейбуковAnsible.
Это удобный способ настройки индивидуального инвентаря для каждого проекта, который можно включить в системы контроля версий, такие как Git:
Ansible поддерживает сценарии инвентаризации для создания динамических файлов. Это полезно, если ваш инвентарь часто меняется, когда серверы создаются и уничтожаются.
Вы можете найти ряд скриптов с открытым исходным кодом в официальном репозитории Ansible GitHub. После загрузки требуемого сценария на Ansible Control Machine и настройки необходимых параметров (например, учетных данных API) вы можете запустить исполняемый файл в качестве пользовательского инвентаря с любой командой Ansible, которая поддерживает эту опцию.
Следующая команда использует скрипт инвентаря my_inventory.py с командой ping для проверки подключения ко всем текущим активным серверам:
# ansible all -m ping -i my_inventory.py
За более подробной информацией о том, как использовать динамические файлы инвентаризации, пожалуйста, обратитесь к официальной документации Ansible.
Если вы сталкиваетесь с ошибками при выполнении команд и плейбуков, рекомендуется увеличить детализацию вывода, чтобы получить больше информации о проблеме.
Вы можете сделать это, включив в команду параметр -v:
# ansible-playbook myplaybook.yml -v
Если вам нужно больше деталей, вы можете использовать -vvv, и это увеличит детализацию вывода.
Если вы не можете подключиться к удаленным нодам через Ansible, используйте -vvvv для получения информации об отладке соединения:
# ansible-playbook myplaybook.yml -vvvv
24. Возможные ошибки.
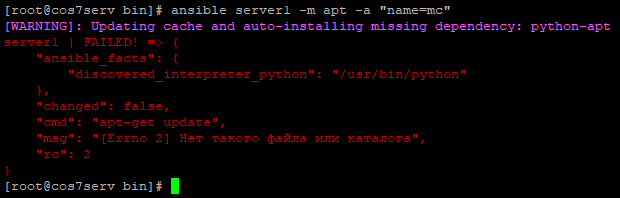
24.1. Ошибка «[WARNING]: Updating cache and auto-installing missing dependency: python-apt».
Данная ошибка возникает во время попытки установит пакет с программным обеспечением на целевые хосты с CentOS 7:
# ansible server1 -m apt -a "name=vim"
Ответ с ошибкой:
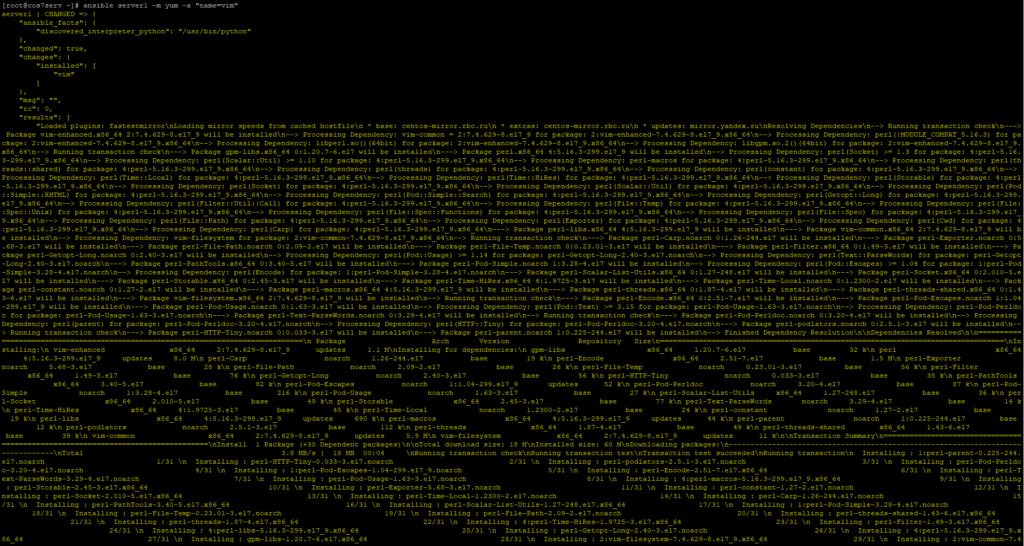
Устранение ошибки: воспользуйтесь установщиком yum c CentOS 7 совместимых операционных систем, а не apt с Debian совместимых систем.
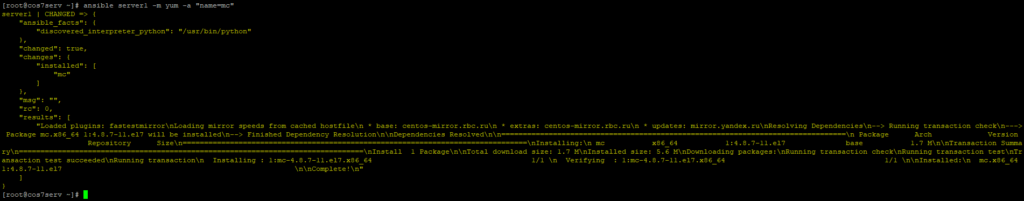
# ansible server1 -m yum -a "name=vim"
Вариант ответа без ошибки:
Программное обеспечение успешно установилось.
25. Оригиналы источников информации.
selectel.ru «Система управления конфигурацией Ansible».
dmosk.ru «Инструкция по установке и запуску Ansible на CentOS».
Решил написать несколько статей о установке, настройке и роботе с mysql базой данных. В качестве mysql-сервера будем использовать Percona Server 5.6 под управлением операционной системой Ubuntu 12.04. Данная серия статей будет полезной для людей, которые впервые сталкиваются с базами данных(БД) mysql, и хотят немного изучить установку, базовые команды(запросы), научиться делать backup и restore данных, настройку и тестирование репликации БД percona mysql. В этой части пойдет речь о базовой установке и добавлении тестовой БД, репликация которой будет настроена далее.
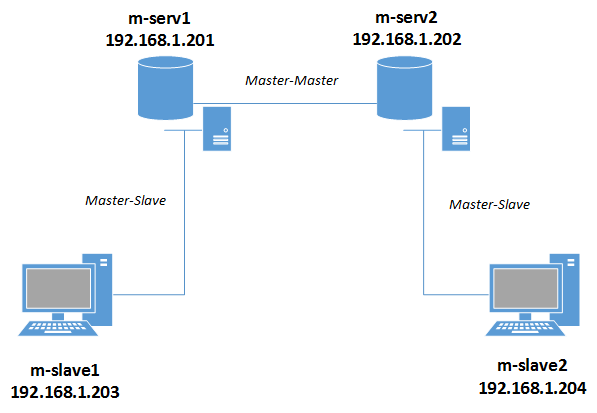
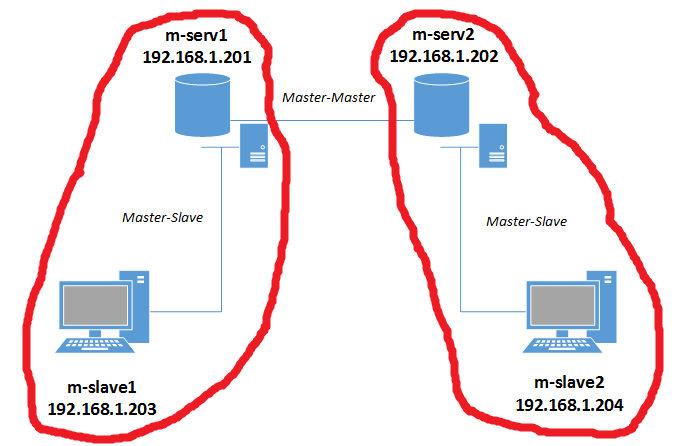
Поскольку статьи будут взаимосвязаны, наведем схему репликации (рис. 1) и базовую конфигурацию серверов.
Роль хоста
Имя хоста (hostname)
IP хоста
Master server 1
m-serv1
192.168.1.201
Master server 2
m-serv2
192.168.1.202
Slave server 1
m-slave1
192.168.1.203
Slave server 2
m-slave2
192.168.1.204
Рисунок 1 — Схема репликации
1 Установка
Для начала нам нужно установить Percona Server 5.6. Mysql нужно установить на всех серверах, в нашем случаи на 4-х (2 мастера, 2 слейва). Начинаем установку.
root@m-serv1:~# apt-key adv --keyserver keys.gnupg.net --recv-keys 1C4CBDCDCD2EFD2A
Executing: gpg --ignore-time-conflict --no-options --no-default-keyring --secret-keyring /tmp/tmp.igWqa1jBp0 --trustdb-name /etc/apt/trustdb.gpg --keyring /etc/apt/trusted.gpg --primary-keyring /etc/apt/trusted.gpg --keyserver keys.gnupg.net --recv-keys 1C4CBDCDCD2EFD2A
gpg: requesting key CD2EFD2A from hkp server keys.gnupg.net
gpg: key CD2EFD2A: public key "Percona MySQL Development Team <mysql-dev@percona.com>" imported
gpg: Total number processed: 1
gpg:               imported: 1

root@m-serv1:~# cat >> /etc/apt/sources.list.d/percona-mysql.list
deb http://repo.percona.com/apt precise main
deb-src http://repo.percona.com/apt precise main
root@m-serv1:~# apt-get update
root@m-serv1:~# apt-get install percona-server-server
При установке, у Вас спросят пароль root-a, который будет использоваться для подключения к mysql серверу – не забудьте его. Далее можно запустить mysql_secure_installation для обновления пароля, удаления ненужных БД и пользователей.
root@m-serv1:~# mysql_secure_installation
Enter current password for root (enter for none):
OK, successfully used password, moving on...

You already have a root password set, so you can safely answer 'n'.
Change the root password? [Y/n] Y
New password:
Re-enter new password:
Password updated successfully!
Reloading privilege tables..
 ... Success!

Remove anonymous users? [Y/n] Y
 ... Success!

Disallow root login remotely? [Y/n] Y
 ... Success!

Remove test database and access to it? [Y/n] Y
 - Dropping test database...
 ... Success!
 - Removing privileges on test database...
 ... Success!

Reload privilege tables now? [Y/n] Y
 ... Success!
Все эти действия нужно проделать на m-serv2, m-slave1 и m-slave2. Теперь можно создать тестовую БД.
2 Добавление данных
2.1 Создание тестовой БД
Можно создать БД (testdb) на одном сервере, сделать ее дамп и развернуть на всех остальных. Что мы и сделаем. Подключаемся на m-serv1 к mysql консоли и создаем тестовую БД.
root@m-serv1:~# mysql -u root -p
mysql> CREATE DATABASE testdb;
Далее добавим таблицу в новую БД.
mysql> CREATE TABLE IF NOT EXISTS testdb.users (id INT UNSIGNED NOT NULL PRIMARY KEY AUTO_INCREMENT,
name VARCHAR(20));
Теперь добавим одну строку в таблицу users.
mysql> INSERT INTO users(name) VALUES ("Alex");
Далее проверим что у нас получилось.
mysql> show databases;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| mysql              |
| performance_schema |
| testdb             |
+--------------------+
5 rows in set (0.02 sec)

mysql> use testdb; show tables;
Database changed
+------------------+
| Tables_in_testdb |
+------------------+
| users            |
+------------------+
1 row in set (0.00 sec)

mysql> use testdb; select * from users;
Database changed
+----+------+
| id | name |
+----+------+
|  1 | Alex |
+----+------+
1 row in set (0.00 sec)

mysql> use testdb; describe users;
Database changed
+-------+------------------+------+-----+---------+----------------+
| Field | Type             | Null | Key | Default | Extra          |
+-------+------------------+------+-----+---------+----------------+
| id    | int(10) unsigned | NO   | PRI | NULL    | auto_increment |
| name  | varchar(20)      | YES  |     | NULL    |                |
+-------+------------------+------+-----+---------+----------------+
2 rows in set (0.03 sec)
Как видим, мы успешно создали БД testdb и в ней создали таблицу users, в которую добавили новую запись.
2.2 Дамп и деплой БД на всех серверах
Снимаем дамп нашей новой БД и копируем его на второй мастер m-serv2.
Теперь логинимся на второй сервер и разворачиваем дамп.
root@m-serv2:~# mysql -u root -p -e 'create database testdb;'
root@m-serv2:~# mysql -uroot -p testdb < testdb.sql
root@m-serv2:~# mysql -u root -p -e 'use testdb; select * from users;'
+----+------+
| id | name |
+----+------+
|  1 | Alex |
+----+------+
Те же действия нужно проделать со слейвами(m-slave1 и m-slave2), т.е. синкануть БД на оба слейва и развернуть таким же макаром.
2.3 Создание юзера для репликации
Теперь нужно создать юзера, который будет заниматься репликацией. Для этого переходим в mysql консоль и создаем юзера replica с правами “replication slave”.
mysql> CREATE USER 'replica'@'%' IDENTIFIED BY '%repl2015';
Query OK, 0 rows affected (0.22 sec)

mysql> GRANT replication slave ON *.* TO 'replica'@'%';
Query OK, 0 rows affected (0.10 sec)
Как вы поняли, эти действия нужно проделать на всех 4-х серверах.
3 Настройка репликации
В mysql существует два типа репликации данных:
Master-Slave
Master-Master
Master-Slave репликация. На Master сервере данные добавляются, удаляются и изменяются. Slave сервер стягивает эти обновления себе и постепенно выполняет все полученные запросы. Если на Slave сервере будет добавлена новая таблица или БД, то данные не попадут на Master. При Master-Master репликации данные попавшие на оба сервера будут среплицированы между собой.
3.1 Master-Master репликация
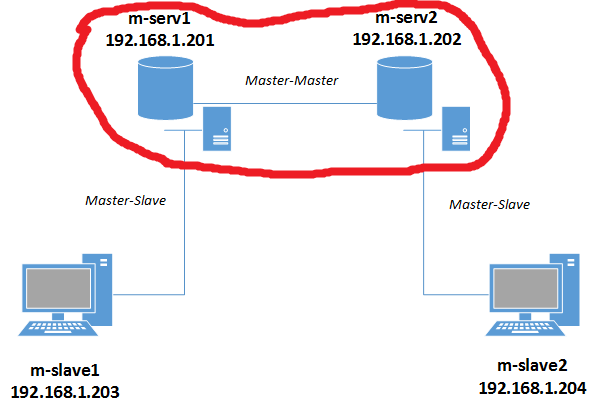
Сначала настроим Мастер-Мастер репликацию (рис. 2).
Рисунок 2 — Схема Master-Master репликации
Теперь переходим к настройке репликации. Для этого нам нужно добавить конфигурационный файл /etc/mysql/my.cnf для каждого mysql-сервера, который входит в репликацию. Здесь нужно прописать уникальный идентификатор сервера и БД, которые нужно и не нужно реплицировать. Также здесь прописывается множество дополнительных настроек mysql сервера, о которых можно узнать на официальном сайте. Я же наведу самую нужную малость.
3.1.1 Настройка m-serv1 мастера
Сначала настроим первый мастер-сервер.
root@m-serv1:~# cat /etc/mysql/my.cnf
[mysqld]
#Уникальный идентификатор сервера
server-id = 1

#Логи ошибок
log_error = /var/log/mysql/mysql.err

#Путь к bin-логам сервера(бинлог, который ведет мастер)
log-bin = /var/lib/mysql/server-mysql-bin
log-bin-index = /var/lib/mysql/server-mysql-bin.index

#Путь к relay-логам слейва (бинлог, скачанный с мастера)
relay-log = /var/lib/mysql/slave-mysql-relay-bin
relay-log-index = /var/lib/mysql/slave-mysql-relay-bin.index

#БД, которые нужно/не нужно реплицировать
replicate-do-db = testdb
replicate-ignore-db=information_schema
replicate-ignore-db=mysql
replicate-ignore-db=performance_schema

#Не вести журнал бин-лога для БД
binlog-ignore-db = information_schema
binlog-ignore-db = mysql
binlog-ignore-db = performance_schema

#Чтобы не было конфликтов автоинкремента, говорим серверу,
#чтобы id генерировались начиная с 3-го прибавляя по 10,
# например 13, 23, 33, 43...
auto_increment_increment = 10
auto_increment_offset = 3

#Сохранять логи с мастера в своий бин-лог, чтобы передать слейву
log-slave-updates
Как видим, здесь мы добавили для репликации только testdb БД. Теперь рестартуем mysql.
root@m-serv1:~# /etc/init.d/mysql restart
 * Stopping MySQL (Percona Server) mysqld                                                                                                                       [ OK ]
 * Starting MySQL (Percona Server) database server mysqld                                                                                                       [ OK ]
 * Checking for corrupt, not cleanly closed and upgrade needing tables.
3.1.2 Настройка m-serv2 мастера
Настройка второго мастера аналогична первому, только меняется id и offset
root@m-serv2:~# cat /etc/mysql/my.cnf
[mysqld]
#Уникальный идентификатор сервера
server-id = 2

#Логи ошибок
log_error = /var/log/mysql/mysql.err

#Путь к bin-логам сервера(бинлог, который ведет мастер)
log-bin = /var/lib/mysql/server-mysql-bin
log-bin-index = /var/lib/mysql/server-mysql-bin.index

#Путь к relay-логам слейва (бинлог, скачанный с мастера)
relay-log = /var/lib/mysql/slave-mysql-relay-bin
relay-log-index = /var/lib/mysql/slave-mysql-relay-bin.index

#БД, которые нужно/не нужно реплицировать
replicate-do-db = testdb
replicate-ignore-db=information_schema
replicate-ignore-db=mysql
replicate-ignore-db=performance_schema

#Не вести журнал бин-лога для БД
binlog-ignore-db = information_schema
binlog-ignore-db = mysql
binlog-ignore-db = performance_schema

#Чтобы не было конфликтов автоинкремента, говорим серверу,
#чтобы id генерировались начиная с 4-го прибавляя по 10,
# например 14, 24, 34, 44...
auto_increment_increment = 10
auto_increment_offset = 4

#Сохранять логи с мастера в своий бин-лог, чтобы передать слейву
log-slave-updates
Рестартуем mysql.
root@m-serv2:~# /etc/init.d/mysql restart
 * Stopping MySQL (Percona Server) mysqld                                                                                                                       [ OK ]
 * Starting MySQL (Percona Server) database server mysqld                                                                                                       [ OK ]
 * Checking for corrupt, not cleanly closed and upgrade needing tables.
3.1.3 Запуск репликации
Сначала запустим репликацию на первом мастере m-serv1. Для этого нам нужно знать MASTER_LOG_FILE и MASTER_LOG_POSm-serv2 сервера, т.е. нашего второго мастера. Логинимся на m-serv2 и смотрим master status.
Все интуитивно понятно. Теперь стартуем слейв и смотрим статус.
root@m-serv1:~# mysql -u root -p -e 'start slave;'
root@m-serv1:~# mysql -u root -p -e 'show slave status G;'
*************************** 1. row ***************************
               Slave_IO_State: Waiting for master to send event
                  Master_Host: 192.168.1.202
                  Master_User: replica
                  Master_Port: 3306
                Connect_Retry: 60
              Master_Log_File: server-mysql-bin.000001
          Read_Master_Log_Pos: 120
               Relay_Log_File: slave-mysql-relay-bin.000002
                Relay_Log_Pos: 290
        Relay_Master_Log_File: server-mysql-bin.000001
             Slave_IO_Running: Yes
            Slave_SQL_Running: Yes
              Replicate_Do_DB: testdb
          Replicate_Ignore_DB: information_schema,mysql,performance_schema
           Replicate_Do_Table:
       Replicate_Ignore_Table:
      Replicate_Wild_Do_Table:
  Replicate_Wild_Ignore_Table:
                   Last_Errno: 0
                   Last_Error:
                 Skip_Counter: 0
          Exec_Master_Log_Pos: 120
              Relay_Log_Space: 469
              Until_Condition: None
               Until_Log_File:
                Until_Log_Pos: 0
           Master_SSL_Allowed: No
           Master_SSL_CA_File:
           Master_SSL_CA_Path:
              Master_SSL_Cert:
            Master_SSL_Cipher:
               Master_SSL_Key:
        Seconds_Behind_Master: 0
Master_SSL_Verify_Server_Cert: No
                Last_IO_Errno: 0
                Last_IO_Error:
               Last_SQL_Errno: 0
               Last_SQL_Error:
  Replicate_Ignore_Server_Ids:
             Master_Server_Id: 2
                  Master_UUID: 25f9f3ac-fd3b-11e4-bb77-080027ead940
             Master_Info_File: /var/lib/mysql/master.info
                    SQL_Delay: 0
          SQL_Remaining_Delay: NULL
      Slave_SQL_Running_State: Slave has read all relay log; waiting for the slave I/O thread to update it
           Master_Retry_Count: 86400
                  Master_Bind:
      Last_IO_Error_Timestamp:
     Last_SQL_Error_Timestamp:
               Master_SSL_Crl:
           Master_SSL_Crlpath:
           Retrieved_Gtid_Set:
            Executed_Gtid_Set:
                Auto_Position: 0
Со всего этого вывода нас интересуют Seconds_Behind_Master (время отставания реплики от мастера), Slave_IO_State (должно писать, что ждет новостей от мастера), Slave_IO_Running (Yes) и Slave_SQL_Running (Yes). Если репликация идет нормально, реплика будет следовать за мастером (номер лога в Master_Log_File и позиция Exec_Master_Log_Pos будут расти). Отставания реплики от мастера (Seconds_Behind_Master), должно быть нулевым, но может расти. Если же значение Slave_IO_State пусто, а Seconds_Behind_Master равно NULL, репликация не началась. У нас все гуд. Поэтому узнаем master статус на m-serv1 и беремся за m-serv2.
Все прошло успешно. О парочке возможных ошибок и их исправлении будет написано в следующей статье.
3.1.4 Тестируем репликацию
Теперь можно немножко и протестировать. Перейдем на m-serv1 и добавим в testdb.users новую строку.
root@m-serv1:~# mysql -u root -p -e 'USE testdb; INSERT INTO users(name) VALUES ("Vova");'
root@m-serv1:~# mysql -u root -p -e 'USE testdb; SELECT * FROM users;'
+----+------+
| id | name |
+----+------+
|  1 | Alex |
|  3 | Vova |
+----+------+
Теперь проверим среплицировалась ли запись на второй сервер.
root@m-serv2:~# mysql -u root -p -e 'USE testdb;SELECT * FROM users;'
+----+------+
| id | name |
+----+------+
|  1 | Alex |
|  3 | Vova |
+----+------+
Все в порядке, запись попала на второй сервер. Теперь добавим запись на втором сервере и посмотрим попадет ли она на первый мастер.
root@m-serv2:~# mysql -u root -p -e 'USE testdb; INSERT INTO users(name) VALUES ("Pasha");'
root@m-serv2:~# mysql -u root -p -e 'USE testdb; SELECT * FROM users;'
+----+-------+
| id | name  |
+----+-------+
|  1 | Alex  |
|  3 | Vova  |
|  4 | Pasha |
+----+-------+
Смотрим на первом мастере.
root@m-serv1:~# mysql -u root -p -e 'USE testdb; SELECT * FROM users;'
+----+-------+
| id | name  |
+----+-------+
|  1 | Alex  |
|  3 | Vova  |
|  4 | Pasha |
+----+-------+
Как видим, все ок. Добавим еще по одной записи.
root@m-serv1:~# mysql -u root -p -e 'USE testdb;INSERT INTO users(name) VALUES ("Frodo");'
root@m-serv1:~# mysql -u root -p -e 'USE testdb; SELECT * FROM users;'
+----+-------+
| id | name  |
+----+-------+
|  1 | Alex  |
|  3 | Vova  |
|  4 | Pasha |
| 13 | Frodo |
+----+-------+

root@m-serv2:~# mysql -u root -p -e 'USE testdb; INSERT INTO users(name) VALUES ("Misha");'
root@m-serv2:~# mysql -u root -p -e 'USE testdb; SELECT * FROM users;'
+----+-------+
| id | name  |
+----+-------+
|  1 | Alex  |
|  3 | Vova  |
|  4 | Pasha |
| 13 | Frodo |
| 14 | Misha |
+----+-------+
Как видим, если запись добавлена с сервера m-serv1, то поле auto_increment(id) имеет значения 3, 13, а при добавлении записей с m-serv2, эти значения равны 4, 14. Это нужно чтобы избежать ошибок типа Duplicate entry.
Продолжим знакомство с Percona mysql репликацией и перейдем к настройке и тестированию Master-Slave репликации. Как и в предыдущих статьях, наведу рисунок нашей схемы репликации, которую мы затеяли (рис. 3).
Рисунок 3 — Схема Master-Slave репликации
3.2 Master-Slave репликация
Мастер-Мастер репликация была настроена, теперь можно добавлять слейвы (рис. 3). Для этого нам нужно добавить конфигурационный файл /etc/mysql/my.cnf для каждого mysql-слейва, который входит в репликацию.
3.2.1 Настройка m-slave1 слейва
Сначала настроим первый слейв-сервер.
root@m-slave1:~# cat /etc/mysql/my.cnf
[mysqld]
#Уникальный идентификатор сервера
server-id = 3

#Логи ошибок
log_error = /var/log/mysql/mysql.err

#Путь к relay-логам слейва (бинлог, скачанный с мастера)
relay-log = /var/lib/mysql/slave-mysql-relay-bin
relay-log-index = /var/lib/mysql/slave-mysql-relay-bin.index

#БД, которые нужно/не нужно реплицировать
replicate-do-db = testdb
replicate-ignore-db=information_schema
replicate-ignore-db=mysql
replicate-ignore-db=performance_schema

#Чтобы не было конфликтов автоинкремента, говорим серверу,
#чтобы id генерировались начиная с 4-го прибавляя по 10,
# например 11, 21, 31, 41...
auto_increment_increment = 10
auto_increment_offset = 1
Теперь рестартуем mysql
root@m-slave1:~# /etc/init.d/mysql restart
 * Stopping MySQL (Percona Server) mysqld                                                                                                                       [ OK ]
 * Starting MySQL (Percona Server) database server mysqld                                                                                                       [ OK ]
 * Checking for corrupt, not cleanly closed and upgrade needing tables.
3.2.2 Настройка m-slave2 слейва
Переходим к настройке второго слейва.
root@m-slave2:~# cat /etc/mysql/my.cnf
[mysqld]
#Уникальный идентификатор сервера
server-id = 4

#Логи ошибок
log_error = /var/log/mysql/mysql.err

#Путь к relay-логам слейва (бинлог, скачанный с мастера)
relay-log = /var/lib/mysql/slave-mysql-relay-bin
relay-log-index = /var/lib/mysql/slave-mysql-relay-bin.index

#БД, которые нужно/не нужно реплицировать
replicate-do-db = testdb
replicate-ignore-db=information_schema
replicate-ignore-db=mysql
replicate-ignore-db=performance_schema

#Чтобы не было конфликтов автоинкремента, говорим серверу,
#чтобы id генерировались начиная с 4-го прибавляя по 10,
# например 12, 22, 32, 42...
auto_increment_increment = 10
auto_increment_offset = 2
Теперь рестартуем mysql
root@m-slave2:~# /etc/init.d/mysql restart
 * Stopping MySQL (Percona Server) mysqld                                                                                                                       [ OK ]
 * Starting MySQL (Percona Server) database server mysqld                                                                                                       [ OK ]
 * Checking for corrupt, not cleanly closed and upgrade needing tables.
3.2.3 Запуск репликации
Если вы следовали пункту 3.1.4 (Тестирование мастер репликации) после настройки Мастер – Мастер репликации, то на обоих слейвах нужно разворачивать новый дамп testdb, так как в эту БД добавлялись данные. Т.е. для слейва m-slave1 нужно снять дамп с мастера m-serv1 и развернуть (описано в пункте 2.2 Дамп и деплой), для m-slave2 дамп нужно снять с m-serv2 и развернуть. После того, как дамп будет развернут, у нас будут следующие данные в БД testdb.
root@m-slave1:~# mysql -u root -p -e 'use testdb;select * from users;'
Enter password:
+----+-------+
| id | name  |
+----+-------+
|  1 | Alex  |
|  3 | Vova  |
|  4 | Pasha |
| 13 | Frodo |
| 14 | Misha |
+----+-------+
Т.е. те же данные, что остались на мастер-серверах после тестирования Масте-Мастер репликации. Теперь осталось запустить репилкацию. В случаи с m-slave1 мастер сервер должен быть m-serv1, поэтому переходим на первый мастер сервер и смотрим MASTER_LOG_FILE и MASTER_LOG_POS.
Все интуитивно понятно. Теперь стартуем слейв и смотрим статус.
root@m-slave2:~# mysql -u root -p -e 'start slave;'
root@m-slave2:~# mysql -u root -p -e 'show slave status G;'
*************************** 1. row ***************************
               Slave_IO_State: Waiting for master to send event
                  Master_Host: 192.168.1.202
                  Master_User: replica
                  Master_Port: 3306
                Connect_Retry: 60
              Master_Log_File: server-mysql-bin.000002
          Read_Master_Log_Pos: 120
               Relay_Log_File: slave-mysql-relay-bin.000002
                Relay_Log_Pos: 290
        Relay_Master_Log_File: server-mysql-bin.000002
             Slave_IO_Running: Yes
            Slave_SQL_Running: Yes
              Replicate_Do_DB: testdb
          Replicate_Ignore_DB: information_schema,mysql,performance_schema
           Replicate_Do_Table:
       Replicate_Ignore_Table:
      Replicate_Wild_Do_Table:
  Replicate_Wild_Ignore_Table:
                   Last_Errno: 0
                   Last_Error:
                 Skip_Counter: 0
          Exec_Master_Log_Pos: 120
              Relay_Log_Space: 469
              Until_Condition: None
               Until_Log_File:
                Until_Log_Pos: 0
           Master_SSL_Allowed: No
           Master_SSL_CA_File:
           Master_SSL_CA_Path:
              Master_SSL_Cert:
            Master_SSL_Cipher:
               Master_SSL_Key:
        Seconds_Behind_Master: 0
Master_SSL_Verify_Server_Cert: No
                Last_IO_Errno: 0
                Last_IO_Error:
               Last_SQL_Errno: 0
               Last_SQL_Error:
  Replicate_Ignore_Server_Ids:
             Master_Server_Id: 2
                  Master_UUID: 25f9f3ac-fd3b-11e4-bb77-080027ead940
             Master_Info_File: /var/lib/mysql/master.info
                    SQL_Delay: 0
          SQL_Remaining_Delay: NULL
      Slave_SQL_Running_State: Slave has read all relay log; waiting for the slave I/O thread to update it
           Master_Retry_Count: 86400
                  Master_Bind:
      Last_IO_Error_Timestamp:
     Last_SQL_Error_Timestamp:
               Master_SSL_Crl:
           Master_SSL_Crlpath:
           Retrieved_Gtid_Set:
            Executed_Gtid_Set:
                Auto_Position: 0
3.2.4 Тестируем репликацию
Тестируем всю нашу цепочку репликации (рис. 1). Перейдем на первый мастер сервер и добавим новую запись в testdb.users.
root@m-serv1:~# mysql -u root -p -e 'USE testdb; INSERT INTO users(name) VALUES ("Server1 record");'
root@m-serv1:~# mysql -u root -p -e 'select * from testdb.users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
+----+----------------+
Теперь проверяем добавилась ли запись на все слейвы и на второй мастер
root@m-slave1:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
+----+----------------+

root@m-slave2:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
+----+----------------+

root@m-serv2:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
+----+----------------+
Как видим, все в порядке. Теперь добавим запись на втором мастере.
root@m-serv2:~# mysql -u root -p -e 'USE testdb; INSERT INTO users(name) VALUES ("Server2 record");'
root@m-serv2:~# mysql -u root -p -e 'select * from testdb.users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
| 24 | Server2 record |
+----+----------------+
Теперь проверяем добавилась ли запись на все слейвы и на первый мастер
root@m-slave1:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
| 24 | Server2 record |
+----+----------------+

root@m-slave2:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
| 24 | Server2 record |
+----+----------------+

root@m-serv1:~# mysql -u root -p -e 'use testdb;select * from users;'
+----+----------------+
| id | name           |
+----+----------------+
|  1 | Alex           |
|  3 | Vova           |
|  4 | Pasha          |
| 13 | Frodo          |
| 14 | Misha          |
| 23 | Server1 record |
| 24 | Server2 record |
+----+----------------+
Как видим, репликация работает как и предполагалось.
4. Распространенные ошибки
========================================================================== Ошибка: ERROR 1872 (HY000): Slave failed to initialize relay log info structure from the repository Решение:
Error_code: 1032; handler error HA_ERR_KEY_NOT_FOUND for deleting row
Can’t drop database ‘********’: database doesn’t exist’
Error ‘Duplicate entry’
Could not execute Write_rows event on table ***********: Duplicate entry ‘XXXXXXXX’ for key ‘ххххххх’, Error_code: 1062
Решение: Эти ошибки можно просто скипнуть, но посмотреть их причины сначала.
mysql -uroot -p -e 'STOP SLAVE; SET GLOBAL SQL_SLAVE_SKIP_COUNTER = 1; START SLAVE;'
========================================================================== Ошибка: Relay log read failure (#1594): Could not parse relay log event entry. Решение:
#Подключаемся к серверу, где возникла проблема и смотрим статус репликации
root@server:~# mysql -uroot -p -e 'show slave status G;' | grep -E 'Relay_Master_Log_File|Exec_Master_Log_Pos'
        Relay_Master_Log_File: mysql-bin.008189
      Exec_Master_Log_Pos: 71687831

# Останавливаем репликацию и обновляем бин-лог и позицию
#master_log_file = Relay_Master_Log_File = mysql-bin.008189
#master_log_pos = Exec_Master_Log_Pos = 71687831
root@server:~# mysql -uroot -p -e "STOP SLAVE;"
root@server:~# mysql -uroot -p -e "CHANGE MASTER TO master_log_file='mysql-bin.008189', master_log_pos=71687831;"

#Стартуем слейв
root@server:~# mysql -uroot -p218e5ccb4a834382%FBF87B604F1FE14B -e "START SLAVE;"
mysqladmin -u root -p'old_pass' password 'new_pass'
или
mysql> use mysql;
mysql> update user set password=PASSWORD("newpass") where User='ENTER-USER-NAME-HERE';
mysql> create user 'user1'@'localhost' identified by 'user1pass';
Добавить все права на все базы и все таблицы.
#GRANT [тип прав] ON [название БД].[название таблицы] TO '[имя пользователя]'@'localhost';
mysql> grant ALL PRIVILEGES ON *.* to 'user1'@'localhost';
mysql> flush privileges;
Удаление прав для пользователя.
#REVOKE [тип прав] ON [название БД].[название таблицы] FROM '[имя пользователя]'@'localhost';
mysql> revoke ALL on *.* from 'user1'@'localhost';
Удалить пользователя.
mysql> drop user 'user1'@'localhost';
5.4.1 Сброс пароля root, если забыли.
1. Остановка сервера
# /etc/init.d/mysql stop
2. Запуск mysql со скипом привилегий
mysqld --skip-grant-tables --user=mysql &
или
mysqld_safe --skip-grant-tables &
3. Логинимся в БД без пароля. Пароль хэшируется с помощью функции PASSWORD(str). Это специальная функция, которая возвращает строку 16-byte и используется системой аутентификации исключительно mysql сервером. Поэтому, используйте MD5 или SHA1 для хранения паролей приложений, которые юзают mysql, но не PASSWORD.
6. Теперь останавливаем mysqld, который запускали вручную и запускаем init-скрипт.
kill `pgrep mysql`
/etc/init.d/mysql start
 * Starting MySQL (Percona Server) database server mysqld
Установка и настройка Percona XtraDB Cluster
Поднять mysql кластер можно в несколько раз быстрее используя такую вещь, как Percona XtraDB Cluster, о чем и пойдет речь в данной статье.
Создадим Percona XtraDB Cluster с трех серверов под управлением операционной системы Ubuntu 12.04. Установка будет произведена из репозитория. Для начала, логинимся на первый сервер, добавляем ключик и репозитории.
root@pxc1:~#apt-key adv --keyserver keys.gnupg.net --recv-keys 1C4CBDCDCD2EFD2A
root@pxc1:~#vim /etc/apt/sources.list.d/pxe.list
…
deb http://repo.percona.com/apt precise main
deb-src http://repo.percona.com/apt precise main
...
root@pxc1:~#apt-get update
Теперь ставим непосредственно Percona XtraDB Cluster пакет.
Во время установки нужно будет ввести пароль для доступа к mysql БД. Перед добавлением ноды в кластер, нужно стопнуть mysql.
root@pxc1:~#/etc/init.d/mysql stop
Добавляем главный конфигурационных файл для первого mysql PXC1 сервера.
root@pxc1:~#cat /etc/mysql/my.cnf
…
[mysqld]

# Логи
log_error = /var/log/mysql/mysql.err
# Директория с БД
datadir=/var/lib/mysql
# Пользователь
user=mysql
# Путь к Galera модуля
wsrep_provider=/usr/lib/libgalera_smm.so
# URL с IP адресами серверов, которые входят в кластер
wsrep_cluster_address=gcomm://192.168.1.150,192.168.1.151,192.168.1.152
# Формат бинлогов
binlog_format=ROW
# Дефолтный механизм хранения данных
default_storage_engine=InnoDB
# Режим лока при работе с автоинкремент значениями
innodb_autoinc_lock_mode=2

# Адрес первой ноды в кластере
wsrep_node_address=192.168.1.150

# Метод передачи снепшотов БД
wsrep_sst_method=xtrabackup-v2

# Имя кластера
wsrep_cluster_name=test_mysql_cluster

# Аутентификация для SST
wsrep_sst_auth="sstuser:DOGUQpj0Se8Q9oy7"
…
Теперь можно стартовать mysql сервер в режиме bootstrap.
root@pxc1:~#/etc/init.d/mysql bootstrap-pxc
После этого у нас добавиться первая нода в кластер. Для проверки, можно запустить команду.
root@pxc1:~# mysql -u root -p -e "show status like 'wsrep%';" | grep -E 'local_state|cluster|ready|connected'

wsrep_local_state_uuid  b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_local_state       4
wsrep_local_state_comment       Synced
wsrep_cluster_conf_id   1
wsrep_cluster_size      1
wsrep_cluster_state_uuid        b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_cluster_status    Primary
wsrep_connected ON
wsrep_ready     ON
Этот вывод означает, что все ок. Теперь нужно добавить юзера с привилегиями для SST операций, которого мы добавили в конце my.cnf файла.
root@pxc1:~# mysql -u root -p

mysql> CREATE USER 'sstuser'@'localhost' IDENTIFIED BY 'DOGUQpj0Se8Q9oy7';
Query OK, 0 rows affected (1.27 sec)

mysql> GRANT RELOAD, LOCK TABLES, REPLICATION CLIENT ON *.* TO 'sstuser'@'localhost';
Query OK, 0 rows affected (0.62 sec)

mysql> FLUSH PRIVILEGES;
Query OK, 0 rows affected (0.48 sec)
Далее переходим к настройке второго сервера. Устанавливаем mysql Percona XtraDB Cluster таким же образом и переходим к редактированию my.cnf файла.
root@pxc2:~#cat /etc/mysql/my.cnf
…
[mysqld]

# Логи
log_error = /var/log/mysql/mysql.err
# Директория с БД
datadir=/var/lib/mysql
# Пользователь
user=mysql
# Путь к Galera модуля
wsrep_provider=/usr/lib/libgalera_smm.so
# URL с IP адресами серверов, которые входят в кластер
wsrep_cluster_address=gcomm://192.168.1.150,192.168.1.151,192.168.1.152
# Формат бинлогов
binlog_format=ROW
# Дефолтный механизм хранения данных
default_storage_engine=InnoDB
# Режим лока при работе с автоинкремент значениями
innodb_autoinc_lock_mode=2

# Адрес первой ноды в кластере
wsrep_node_address=192.168.1.151

# Метод передачи снепшотов БД
wsrep_sst_method=xtrabackup-v2

# Имя кластера
wsrep_cluster_name=test_mysql_cluster

# Аутентификация для SST
wsrep_sst_auth="sstuser:DOGUQpj0Se8Q9oy7"
…
И стартуем mysql в нормально режиме.
root@pxc2:~#/etc/init.d/mysql start
После этого, второй сервер добавиться в кластер. Проверяем.
root@pxc2:~# mysql -u root -p -e "show status like 'wsrep%';" | grep -E 'local_state|cluster|ready|connected'

wsrep_local_state_uuid  b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_local_state       4
wsrep_local_state_comment       Synced
wsrep_cluster_conf_id   4
wsrep_cluster_size      2
wsrep_cluster_state_uuid        b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_cluster_status    Primary
wsrep_connected ON
wsrep_ready     ON
Ну и добавляем последнюю ноду. Устанавливаем Percona XtraDB Cluster и создаем my.cnf.
root@pxc3:~#cat /etc/mysql/my.cnf
…
[mysqld]

# Логи
log_error = /var/log/mysql/mysql.err
# Директория с БД
datadir=/var/lib/mysql
# Пользователь
user=mysql
# Путь к Galera модуля
wsrep_provider=/usr/lib/libgalera_smm.so
# URL с IP адресами серверов, которые входят в кластер
wsrep_cluster_address=gcomm://192.168.1.150,192.168.1.151,192.168.1.152
# Формат бинлогов
binlog_format=ROW
# Дефолтный механизм хранения данных
default_storage_engine=InnoDB
# Режим лока при работе с автоинкремент значениями
innodb_autoinc_lock_mode=2

# Адрес первой ноды в кластере
wsrep_node_address=192.168.1.152

# Метод передачи снепшотов БД
wsrep_sst_method=xtrabackup-v2

# Имя кластера
wsrep_cluster_name=test_mysql_cluster

# Аутентификация для SST
wsrep_sst_auth="sstuser:DOGUQpj0Se8Q9oy7"
…
И стартуем mysql.
root@pxc3:~#/etc/init.d/mysql start
Проверяем статус кластера.
root@pxc3:~# mysql -u root -p -e "show status like 'wsrep%';" | grep -E 'local_state|cluster|ready|connected'

wsrep_local_state_uuid  b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_local_state       4
wsrep_local_state_comment       Synced
wsrep_cluster_conf_id   7
wsrep_cluster_size      3
wsrep_cluster_state_uuid        b2cf979d-54ca-11e5-9bb4-628c43a251a6
wsrep_cluster_status    Primary
wsrep_connected ON
wsrep_ready     ON
Как видим, у нас все 3 ноды успешно добавлены в кластер. Теперь можно протестировать работу. Переходим на первую ноду, создаем тестовую БД, таблицу и добавляем запись в неё.
root@pxc1:~# mysql -u root –p

mysql> CREATE DATABASE firstDB;
Query OK, 1 row affected (0.01 sec)

mysql> USE firstDB;
Database changed

mysql> CREATE TABLE records (rec VARCHAR(50));
Query OK, 0 rows affected (0.08 sec)

mysql> INSERT INTO records VALUE ("pxc1 record");
Query OK, 1 row affected (0.12 sec)

mysql> SELECT * FROM records;
+-------------+
| rec         |
+-------------+
| pxc1 record |
+-------------+
1 row in set (0.00 sec)
Теперь идем на второй сервер и проверяем работает ли репликация.
root@pxc2:~# mysql -uroot -p

mysql> SHOW DATABASES;
+--------------------+
| Database           |
+--------------------+
| information_schema |
| firstDB            |
| mysql              |
| performance_schema |
| test               |
+--------------------+
Как видим, БД среплицировалась. Теперь добавив еще одну запись в таблицу.
mysql> INSERT INTO records VALUE ("pxc2 record");
Query OK, 1 row affected (0.04 sec)

mysql> SELECT * FROM records;
+-------------+
| rec         |
+-------------+
| pxc1 record |
| pxc2 record |
+-------------+
2 rows in set (0.00 sec)
Первая запись среплицировалась и теперь у нас есть две записи. Проверяем последний сервер.
root@pxc3:~# mysql -u root -p

mysql> USE firstDB;
Database changed

mysql> SELECT * FROM records;
+-------------+
| rec         |
+-------------+
| pxc1 record |
| pxc2 record |
+-------------+
2 rows in set (0.00 sec)
Кластер работает как положено. Для тестов, еще можно выключить одну машину и через некоторое время включить обратно. В этом случаи в кластере будет только две машины, а после включения третей – все данные, которые были добавлены в период колапса будут среплицированы на поднявшуюся ноду.