Архив метки: Программирование

Метод Mutator в Java

В английском словаре Mutator означает иметь новую форму. Итак, Mutator, хотя и не найден в английском словаре, означает нечто, вызывающее изменение в новую форму. Частная переменная — это поле или свойство класса в Java. В Java нет предопределенного метода, называемого Mutator. Вместо этого Mutator — это метод в классе, и этот метод предназначен для изменения значения частной переменной класса. По соглашению программист должен начинать имя метода с «set». Таким образом, метод может быть чем-то вроде setAge(), setPrice(), setName() и т. д.


Разница между частной и общедоступной переменной

Закрытая переменная видна только членам (свойствам и методам) внутри определения класса. Его нельзя увидеть кодом вне определения класса. С другой стороны, общедоступная переменная может быть видна кодом вне определения класса. Код вне класса может просто изменить общедоступную переменную класса, присвоив новое значение, используя имя класса, если метод является статическим, или используя имя объекта, если метод не является статическим. С общедоступной переменной смысла мутации на самом деле нет. Но когда класс изменяет свое собственное значение, которое не может быть изменено извне, это называется трансформацией, в которой лучше понимается мутация.


Иллюстрация Mutator

Не каждому классу нужен Mutator. Однако, когда Mutator необходим для частной переменной (свойства), метод Mutatorа, который является членом класса, должен начинаться с «set». Затем программист определяет метод Mutatorа.

Любой объект в магазине может быть определен классом. Например, хорошая чашка в магазине может быть определена классом. Как минимум, класс будет иметь свойство, которое является ценой чашки, метод Mutatorа и метод доступа. Метод доступа — это метод чтения значения свойства. По соглашению метод доступа должен начинаться с «get». В данном случае это будет getPrice(). Пусть свойство с названием price будет частным. Если цена является общедоступной, то нет необходимости в Mutatorе и аксессоре, так как значение может быть установлено или получено (прочитано) публично.

Следующее определение класса предназначено для чашки (добавлено дополнительное свойство (поле) для валюты):

    class Cup {

        private double price = 2.0;

        private Character currency = '$';

        public void setPrice(Double dbl) {

            price = dbl;

        }

        public double getPrice() {

            return price;

        }

    }


Mutator setPrice() является общедоступным, поэтому к нему можно получить доступ из кода вне класса. Сделать Mutator общедоступным не означает сделать общедоступным соответствующее свойство. Соответствующее свойство должно быть частным. У Mutatorа здесь есть аргумент dbl, который является новой ценой. При изменении рыночных условий меняется и цена в магазине. Если бы цена была общедоступной, не было бы необходимости в Mutatorе setPrice(), поскольку код вне класса мог бы изменить цену. Поскольку setPrice является членом класса, он может видеть значение цены частного свойства. Однако код вне класса не может видеть это свойство. Это по дизайну.

Аксессор getPrice() является общедоступным, поэтому к нему можно получить доступ из кода вне класса. У него нет аргументов. Если бы цена была общедоступной, не было бы необходимости в методе доступа getPrice(), поскольку код вне класса мог бы прочитать цену. Поскольку getPrice является членом класса, он может видеть значение цены частной собственности. Однако код вне класса не может видеть это свойство. Это по дизайну.

Mutator setCurrency() и метод доступа getCurrency() могут быть аналогичным образом написаны для закрытой переменной currency.

Следующий основной класс и основной метод получают доступ к частной переменной price, изменяют переменную, а затем снова обращаются к переменной; все это после создания экземпляра класса:

    public class TheClass {

        public static void main(String[] args) {

            Cup cup1 = new Cup();

            double firstPrice = cup1.getPrice();

            System.out.print(firstPrice); System.out.print(", ");


            cup1.setPrice(3.0);


            double secondPrice = cup1.getPrice();

            System.out.print(secondPrice);

            System.out.println();

        }

    }


Результат:

   2.0, 3.0


Первый сегмент кода в основном методе создает экземпляр объекта Cup (cup1) и получает доступ к цене частного свойства через методы доступа getPrice() и cup1. Затем он распечатывает эту первую цену с запятой и пробелом.

Второй сегмент кода представляет собой сегмент кода из одной строки. Он изменяет цену частной собственности с помощью Mutatorа setPrice() и cup1. Третий сегмент кода считывает и печатает новую цену.


Проверка

Пользователь программы должен установить новую цену как двойную. Но что, если он введет какой-то другой тип данных? Новая цена должна быть подтверждена, если она действительно двойная. Код строки для этого случая должен выглядеть следующим образом:

            boolean bl = dbl instanceof Double;


Оператор instance of возвращает true, если его левый операнд является экземпляром правого операнда; ложно в противном случае.

При проверке определение метода Mutatorа должно быть:

        public void setPrice(Double dbl) {

            if (dbl instanceof Double)

                price = dbl;

            else

                System.out.println("New Price could not be set!");

        }


То есть, если входной dbl имеет тип Double, то цена меняется. Если это не так, выдается сообщение об ошибке, и программа продолжает работу. Обратите внимание, что «d» для double в этом сегменте кода — это «D», а не «d».

Аналогичный код для проверки того, является ли валюта символом, можно записать следующим образом:

        public void setCurrency(Character ch) {

            if (ch instanceof Character)

                currency = '€';

            else

                System.out.println("New currency is not a character!");

        }


То есть, если ввод ch имеет тип Character, то валюта изменяется с $ на ‘€’. Если это не так, выдается сообщение об ошибке, и программа продолжает работу. Обратите внимание, что «c» для символа в этом сегменте кода — это «C», а не «c».


Заключение

В Java нет предопределенного метода в качестве Mutatorа. Mutator кодируется программистом. Mutator — это просто закодированный (общедоступный) метод, который изменяет приватное значение поля (свойства) класса. С другой стороны, метод доступа — это просто закодированный (общедоступный) метод, который считывает частное значение поля (свойства) класса.

Спасибо, что прочитали нашу статью. Оставьте комментарий о своих мыслях и прочитайте другие статьи, которые лучше всего соответствуют идеям, которые вы ищете.
2022-04-01T16:00:06
Java

Алгоритм топологической сортировки

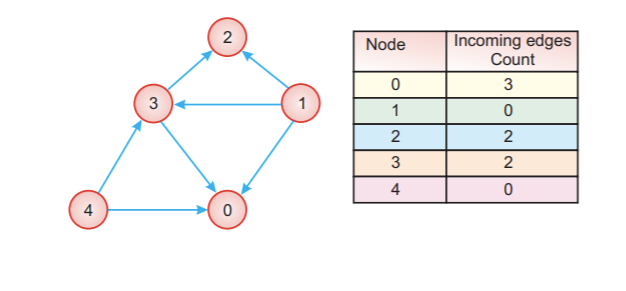
Алгоритм топологической сортировки работает с DAG (прямой ациклический граф). Смысл топологической сортировки в том, что если какой-либо узел указывает на другой узел, то после него будет идти узел, указывающий на другой узел. Таким образом, в этом случае, если у нас есть циклический граф, мы не можем предсказать, какой узел после какого узла. Вот почему алгоритм топологической сортировки работает только с ациклическим графом, а не с циклическим графом.

Каждый граф имеет более одной топологической последовательности сортировки, поскольку она зависит от степени вхождения ребер узлов. Первый начальный узел, который мы выбираем с числом узлов в степени, равен 0.

Давайте разберемся с алгоритмом топологической сортировки на примере.

Алгоритм топологической сортировки


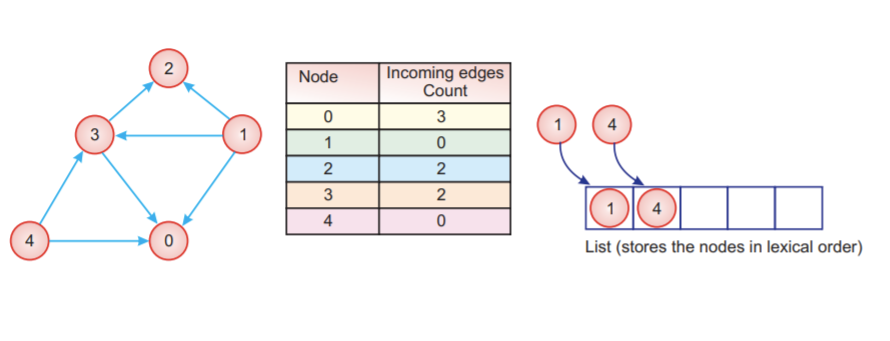
Шаг 1: мы вставляем те узлы, количество входящих ребер которых равно 0. Таким образом, эти узлы являются узлами 1 и 4.

Алгоритм топологической сортировки


Шаг 2:

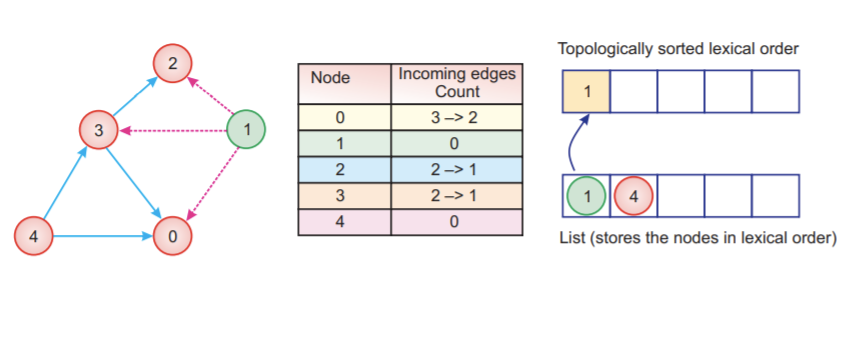
а. Начнем с узла 1. Мы можем выбрать любой узел между узлами 1 и 4.

б. Мы уменьшаем каждое ребро узла на 1, которое связано с узлом 1. Мы уменьшаем ребро узлов (0, 2 и 3).

в. Мы перемещаем узел 1 из списка в топологически отсортированный список, как показано ниже.

Алгоритм топологической сортировки


Шаг 3:

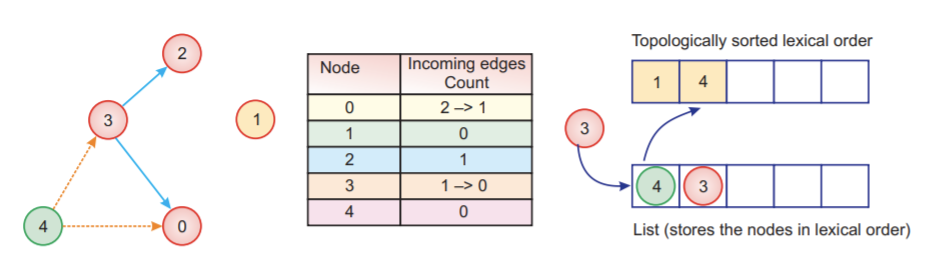
а. Теперь мы исходим из списка, который является Node 4.

б. Мы уменьшаем все исходящие ребра узлов, соединенных с узлом 4, которые являются узлами (0 и 3).

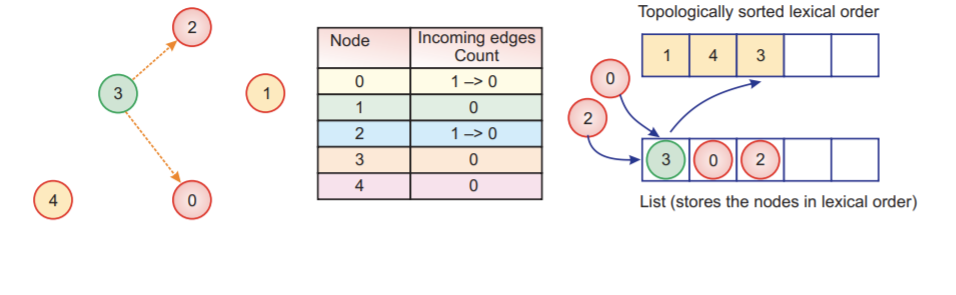
в. Теперь узел 3 не имеет входящих ребер, поэтому мы помещаем его в список, а узел 4 переходит в топологически отсортированный список.

Алгоритм топологической сортировки


Шаг 4:

а. Теперь мы исходим из списка, который является узлом 3.

б. Мы уменьшаем все исходящие ребра узлов, соединенных с узлом 3, которые являются узлами (0 и 2).

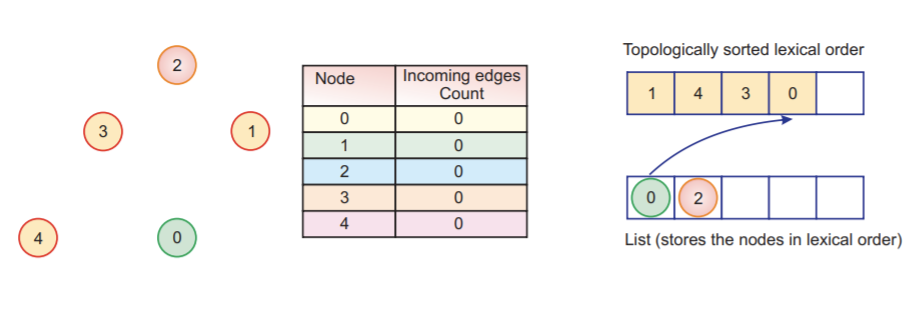
в. Теперь узлы 0 и 2 не имеют входящих ребер, поэтому мы помещаем их в список, а узел 3 переходит в топологически отсортированный список.

Алгоритм топологической сортировки


Шаг 5:

а. Теперь мы исходим из списка, который является Node 0.

б. Поскольку исходящих ребер из Node 0 нет, мы просто добавляем их в список топологической сортировки.

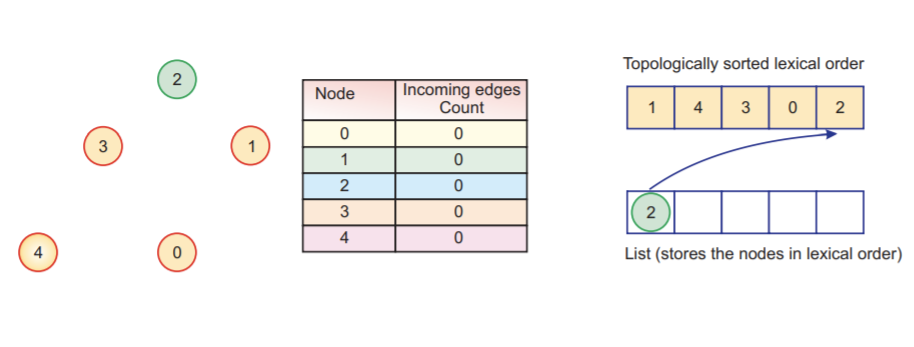
Алгоритм топологической сортировки


Шаг 6:

а. Теперь мы исходим из списка, который является узлом 2.

б. Поскольку исходящих ребер из узла 2 нет, мы просто добавляем их в список топологической сортировки.

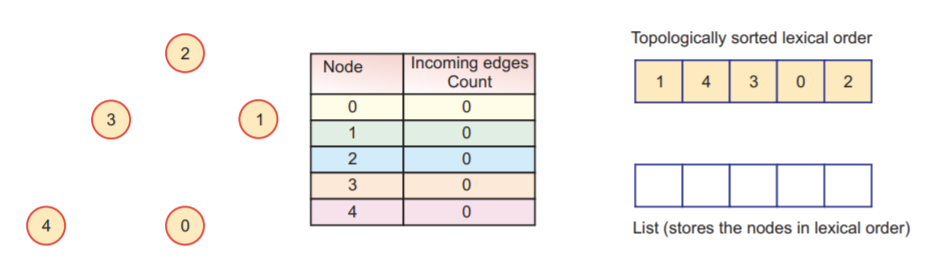
Алгоритм топологической сортировки


Шаг 7:

Наконец, мы отсортировали список здесь.

Алгоритм топологической сортировки


Алгоритм топологической сортировки

Ниже приведены шаги алгоритма топологической сортировки, которым мы должны следовать.

Шаг 0: Рассчитайте степень вхождения каждого узла графа.

Шаг 1: Сначала нам нужно найти узел, у которого входящие ребра равны нулю.

Шаг 2: мы удаляем этот узел из графа и добавляем его в список топологических порядков сортировки.

Шаг 3: Удалите те узлы, у которых есть исходящие ребра.

Шаг 4: Уменьшите степень вхождения на количество связанных ребер, которые были удалены.

Шаг 5: Повторяйте шаги 1–4, пока не останется узлов с нулевой степенью вхождения.

Шаг 6: Убедитесь, что все элементы расположены в правильной последовательности.

Шаг 7: Теперь мы отсортировали заказ из шага 6.

Шаг 8: Положите конец алгоритму.


Код Python : ниже приведена реализация приведенного выше примера на Python.


fromcollectionsimportdefaultdict


classbuildGraph :


def__init__(self, nodes : int) :

self.nodes= nodes


# Теперь мы сохраняем граф в формате смежного списка

self.adjListDetails=defaultdict(list)


# Он будет хранить информацию о входящих

ребрах определенного узла 


# в самом

self.count_numbers_of_incoming_edge_of_a_node= []


# Мы сохраняем отсортированные узлы в топологическом порядке

self.topological_sorted_order= []


# Мы храним информацию обо всех тех узлах, которые

# не имеют входящих ребер в графе

self.nodes_have_zero_incoming_edges= []


# Теперь мы создаем смежный список всех графов для сортировки

defAddGraphEdge (self, source :int, destination : int) :

self.adjListDetails[source].append(destination)

self.count_numbers_of_incoming_edge_of_a_node[destination] +=1


defTopologicalSortAlgorithm (self) :


for node inrange(self.nodes) :

ifself.count_numbers_of_incoming_edge_of_a_node[node] ==0 :

self.nodes_have_zero_incoming_edges.append(node)


whileself.nodes_have_zero_incoming_edges :

self.nodes_have_zero_incoming_edges.sort()

            source =self.nodes_have_zero_incoming_edges.pop(0)


# итерация по соседнему списку

if source inself.adjListDetails :

for node inself.adjListDetails[source] :

self.count_numbers_of_incoming_edge_of_a_node[node] -=1

ifself.count_numbers_of_incoming_edge_of_a_node[node] ==0 :

self.nodes_have_zero_incoming_edges.append(node)


self.topological_sorted_order.append(source)


print("Топологический порядок сортировки: "+str(self.topological_sorted_order))


defmain() :


number_of_nodes=7

    graph =buildGraph(number_of_nodes)

graph.count_numbers_of_incoming_edge_of_a_node= [0] *number_of_nodes


graph.AddGraphEdge(0,2)

graph.AddGraphEdge(0,5)

graph.AddGraphEdge(1,3)

graph.AddGraphEdge(1,6)

graph.AddGraphEdge(2,4)

graph.AddGraphEdge(3,5)

graph.AddGraphEdge(5,2)

graph.AddGraphEdge(5,4)

graph.AddGraphEdge(6,2)


graph.TopologicalSortAlgorithm()


if __name__ =="__main__" :

main()


Выход:

Топологический порядок сортировки: [0, 1, 3, 5, 6, 2, 4]


Временная сложность алгоритма топологической сортировки:

Общее время обработки алгоритма равно O (E + N), где E представляет количество ребер, а N представляет количество узлов в графе. Затем, на следующем шаге, мы должны вычислить степень входа каждого узла, что обычно занимает O(E) раз, а затем поместить все эти узлы в отсортированный список, где их степень входа равна нулю, что занимает O(N) раз. раз. Таким образом, общая временная сложность алгоритма топологической сортировки составляет O (E+N).

Но пространственная сложность алгоритма топологической сортировки составляет O (N), что равно общему количеству узлов в графе.


Применение:

  1. Топологическая сортировка очень полезна для нахождения цикла графа.
  2. Алгоритм топологической сортировки используется для определения условий взаимоблокировки в операционной системе.
  3. Алгоритм топологической сортировки используется для поиска кратчайшего пути во взвешенном ациклическом графе.


Вывод :

В этой статье мы узнали еще об одном важном алгоритме — топологической сортировке. Мы видели, что этот алгоритм работает только с ациклическими графами. Алгоритм топологической сортировки также помогает определить порядок составления задачи. Алгоритм топологической сортировки имеет много преимуществ в реальном времени, например поиск кратчайшего пути. Поскольку топологическая сортировка чрезвычайно полезна, каждый программист и студент должен хорошо понимать этот алгоритм.


2022-03-19T18:03:01
Программирование

Алгоритм Прима

Минимальное связующее дерево:

Граф, не имеющий направлений, называется неориентированным графом. Каждый граф должен иметь путь от одного узла к другому узлу. Остовное дерево также является неориентированным связным графом, в котором присутствуют все узлы графа с минимальным количеством ребер. Если остовное дерево не имеет всех узлов графа, то мы не можем сказать, что это остовное дерево. Суммарные веса остовного дерева будут меньше исходного веса графа, так как мы соединили его через ребра минимального веса. Покрывающее дерево также не имеет цикла. Любой граф имеет более одного остовного дерева, но только одно из них будет уникальным. Мы называем это минимальным остовным деревом, поскольку пытаемся создать полный граф со всеми узлами, сохраняя при этом низкий вес.

Мы можем нарисовать остовное дерево с помощью следующих двух методов:

  1. Алгоритм Крускала
  2. Алгоритм Прима


В этой статье мы собираемся обсудить алгоритм Прима. Алгоритм Крускала будет рассмотрен в следующей статье.


Алгоритм Прима:

Алгоритм Прима используется для нахождения минимального остовного дерева графа. Алгоритм примитива начинается с любого узла, а затем добавляет любой соседний узел с минимальным весом, и этот процесс продолжается до тех пор, пока не будут посещены все узлы в графах. При создании минимального остовного дерева графа мы также не должны создавать циклы, потому что циклов не должно быть в минимальном остовном дереве.


Шаги алгоритма Прима:

Алгоритм прима использует жадный подход для минимального остовного дерева. Мы должны выбрать любую вершину графа, а затем выбрать следующую вершину смежности, чей вес меньше, и мы продолжаем этот процесс до тех пор, пока не соединим все узлы графа.

  • Шаг 1: Выберите любую исходную вершину в графе.
  • Шаг 2: Найдите ребро минимального веса, которое примыкает к источнику, а затем соедините его с остовным деревом.
  • Шаг 3: Повторяйте шаг 2, пока все узлы не будут добавлены в минимальное остовное дерево.


Пример :

Ниже приведен пример поиска минимального остовного дерева с использованием алгоритма Прима.

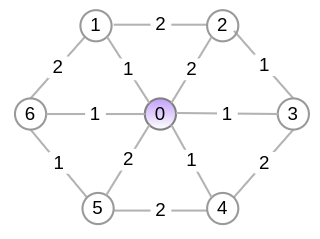
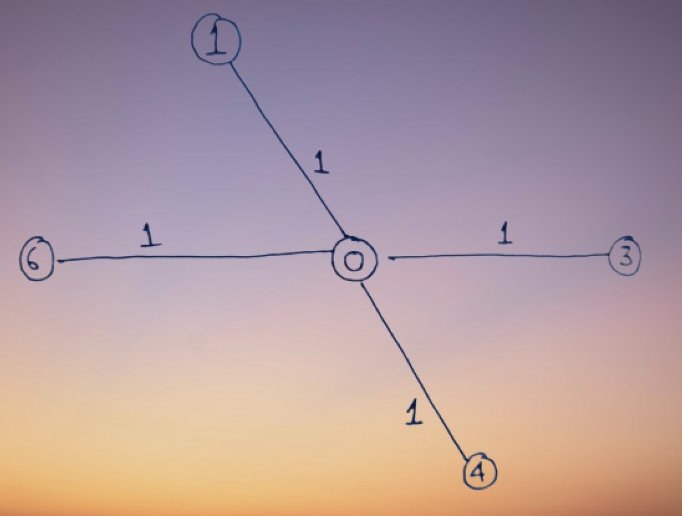
1. Выбираем любой случайный узел из графа G и добавляем его в MST (минимальное остовное дерево). Мы выбираем здесь узел 0.

Алгоритм Прима


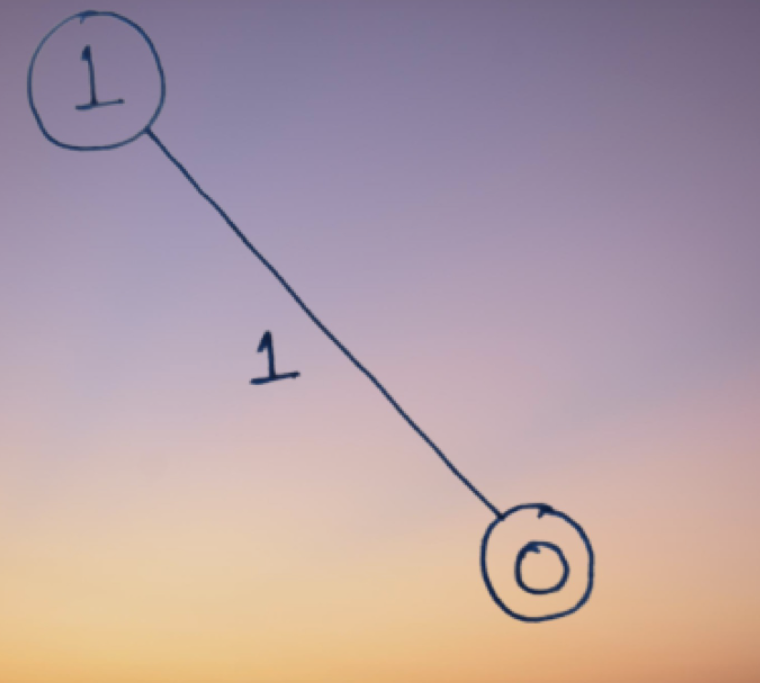
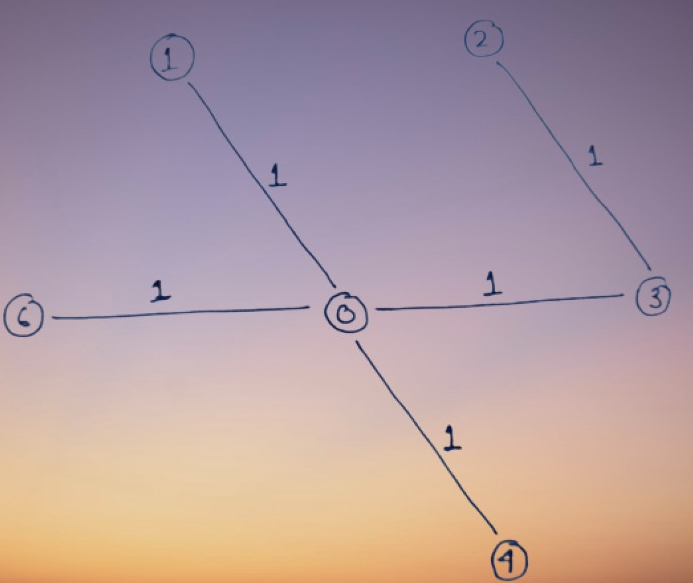
2. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


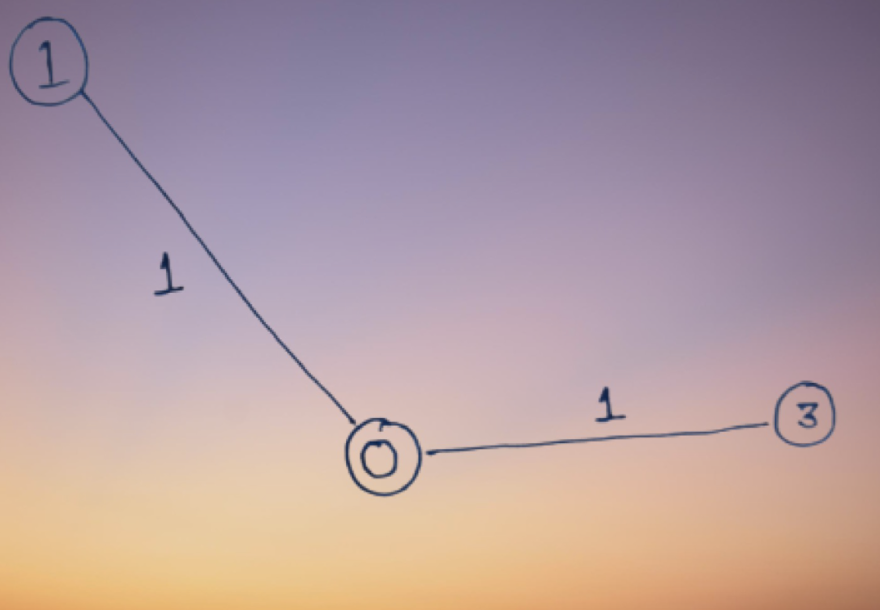
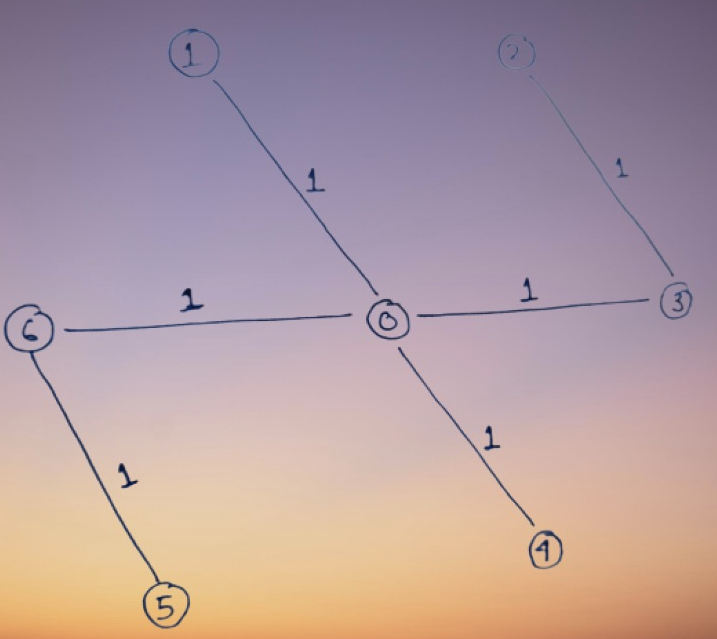
3. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0 или 1), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


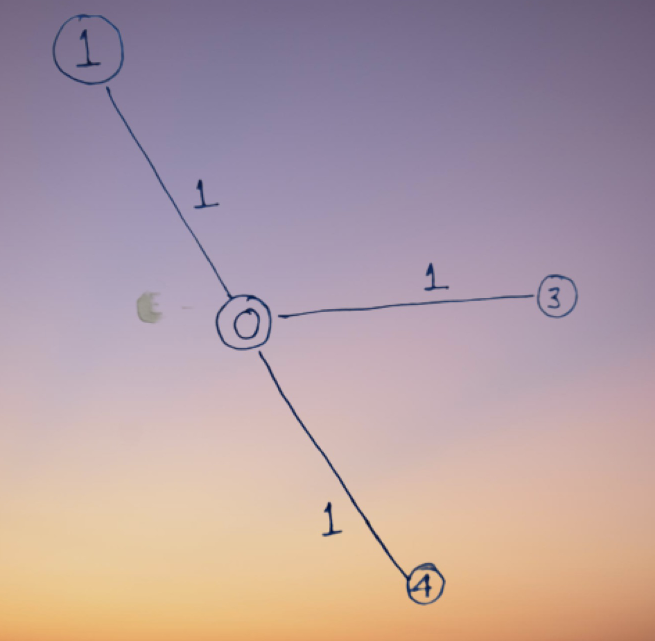
4. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1 или 3), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


5. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3 или 4), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


6. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3, 4 или 6), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


7. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3, 4, 6 или 2), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.

Алгоритм Прима


Выше наш окончательный MST (минимальное остовное дерево), а общая стоимость равна 6.


Программа C++ Prim MST (минимальное связующее дерево):

#include<iostream>


#include<vector>


#include<queue>


#include<algorithm>


#include<cstring>


typedef std :: pair<int,int> SII;


typedef std :: vector<SII> SSII;


int PrimsMST (int sourceNode, std :: vector<SSII> & graph){


    // В этой очереди будут храниться сведения о каждом узле

    // вместе с их весовой ценностью.


    std :: priority_queue<SII, std :: vector<SII>, std :: greater<SII>> k;


    k.push(std :: make_pair(0, sourceNode));


    bool nodesAdded[graph.size()];


    memset(nodesAdded, false, sizeof(bool)*graph.size());


    int mst_tree_cost = 0;


    while (!k.empty()) {


        // We are selecting here the node which has minimum cost


        SII itemNode;


        itemNode = k.top();


        k.pop();


        int Node = itemNode.second;


        int Cost = itemNode.first;


        // Здесь мы проверяем, не был ли какой-либо узел добавлен в MST,


        // затем добавляем этот узел.


        if (!nodesAdded[Node]) {


            mst_tree_cost += Cost;


            nodesAdded[Node] = true;


            // Выполните итерацию по узлам negibour, которые недавно были удалены


            // из очереди приоритетов.


            // и добавлен в MST, который еще не добавлен


            for (auto & pair_node_cost : graph[Node]) {


                int adjency_node = pair_node_cost.second;


                if (nodesAdded[adjency_node] == false) {


                    k.push(pair_node_cost);


                }


            }


        }


    }


    return mst_tree_cost;


}


    int main(){


    // Подробная информация о графике со стоимостью и узлом смежности.


    SSII fromNode_0_in_graph_1  = { {1,1}, {2,2}, {1,3},


    {1,4}, {2,5}, {1,6} };


    SSII fromNode_1_in_graph_1   = { {1,0}, {2,2}, {2,6} };


    SSII fromNode_2_in_graph_1   = { {2,0}, {2,1}, {1,3} };


    SSII fromNode_3_in_graph_1 = { {1,0}, {1,2}, {2,4} };


    SSII fromNode_4_in_graph_1  = { {1,0}, {2,3}, {2,5} };


    SSII fromNode_5_in_graph_1  = { {2,0}, {2,4}, {1,6} };


    SSII fromNode_6_in_graph_1   = { {1,0}, {2,2}, {1,5} };


    int num_of_nodes = 7; // Total Nodes (0 to 6)


    std :: vector<SSII> primsgraph;


    primsgraph.resize(num_of_nodes);


    primsgraph[0] = fromNode_0_in_graph_1;


    primsgraph[1] = fromNode_1_in_graph_1;


    primsgraph[2] = fromNode_2_in_graph_1;


    primsgraph[3] = fromNode_3_in_graph_1;


    primsgraph[4] = fromNode_4_in_graph_1;


    primsgraph[5] = fromNode_5_in_graph_1;


    primsgraph[6] = fromNode_6_in_graph_1;


    // Как мы уже знаем, мы должны выбрать исходную вершину,


    // поэтому мы начинаем с узла вершины 0.


    std :: cout << "Общая стоимость минимального связующего дерева после алгоритма Прима : "


                "" << PrimsMST(0, primsgraph) << std :: endl;


    return 0;


}

Выход:

Общая стоимость минимального связующего дерева после алгоритма Прима : 6


Process finished with exit code 0

Временная сложность алгоритма MST Prim:

  1. Общее время, необходимое для обработки и выбора определенного узла очереди с приоритетом, который еще не добавлен в MST, составляет logV. Но поскольку это работает для каждой вершины, общая временная сложность составляет V (logV).
  2. Граф неориентированный, и общее количество ребер будет 2E. Поскольку мы должны поместить узлы в приоритетную очередь, это займет журнал общего времени (V). Однако, поскольку у нас есть в общей сложности 2E ребра, наша общая операция отправки будет 2E (log (V)).
  3. Общая сложность после операции 1 и 2 составляет O( (E + V ) log (V )).


Заключение:

Мы изучили минимальное остовное дерево Prim, которое большинство людей предпочитает в первую очередь, когда им нужно найти граф MST из графа. Алгоритм Prim прост для понимания и реализации в реальном приложении. Алгоритм Prim очень полезен в реальных приложениях, например, при соединении железнодорожных путей с целыми городами. Так что это всего лишь один пример, но его применение огромно, поэтому мы должны понять этот алгоритм.


2022-03-10T18:08:39
Программирование

Приоритетная очередь в Java

Предположим, что вы предлагаете услуги трем разным людям, стоящим перед вами. Третий человек оказывается вашим другом. Услуга должна быть обслужена в порядке очереди. При использовании принципа «первым пришел — первым обслужен» первый человек имеет наибольший приоритет; второй человек имеет больший приоритет; третье лицо, меньший приоритет и так далее. Вас не накажут, если вы не соблюдаете принцип «первым пришел — первым обслужен». Вы решили сначала обслужить своего друга, затем первого человека, а затем второго человека. Это означает, что вы отдали своему другу наивысший приоритет. Если смотреть на сценарий с точки зрения робота, то третья позиция имела наибольший приоритет.

На следующий день пришли те же трое. На этот раз ваш друг находится посередине. Вы решили служить ему первым, впереди того, кто пришел первым, затем третьего лица и, наконец, первого лица. Итак, на этот раз, по мнению робота, позиция 2 имеет наибольший приоритет, за ней следует позиция 3.

На третий день ваш друг становится первым, и вы действуете по принципу «первым пришел — первым обслужен». Вывод любого и робота состоит в том, что приоритет зависит от того, кого это касается, и от позиции каждого человека. Примечание: в реальной жизни приоритет не всегда зависит от принципа «первым пришел — первым обслужен».

В программировании очередь с двоичным приоритетом — это очередь, в которой первый элемент имеет наибольший приоритет. Третий элемент может иметь больший приоритет, а второй элемент — третий приоритет. Очереди приоритетов имеют бинарную природу. Примечание: первый элемент всегда имеет наивысший приоритет в очереди приоритетов. Также может случиться так, что второй элемент имеет больший приоритет, а третий элемент имеет третий приоритет. В определении очереди приоритетов приоритеты второго и третьего элементов могут быть не в порядке убывания. Эта разница продолжается вниз по очереди до последнего элемента, который не может быть элементом с наименьшим приоритетом. Однако он будет одним из наименее приоритетных. Эта частичная сортировка также известна как частичная сортировка. Итак, очередь с приоритетом — это очередь с частичным порядком, где приоритет не «первым пришел — первым обслужен»,

При работе с массивом «первым пришел — первым обслужен» является «первым поступил — первым обслужен», записывается как FIFO. В вычислениях очередь — это FIFO, а очередь с приоритетом — частичная FIFO, потому что по мере убывания очереди некоторые элементы имеют более высокие приоритеты, чем их ближайшие предшественники. По мере дальнейшего опускания очереди приоритетов расстояние между такими ближайшими предшественниками и более высокими приоритетами увеличивается.

Очередь с приоритетом реализована в виде структуры данных кучи. Следующий вопрос: что такое куча? Есть максимальная куча и минимальная куча, которые будут подробно рассмотрены ниже.


Структура данных кучи

Есть максимальная куча и есть минимальная куча. С max-heap первый элемент является самым большим значением. По мере спуска очереди значения продолжают уменьшаться, увеличиваться и вообще уменьшаться. В min-heap первый элемент является наименьшим значением. По мере опускания очереди значения продолжают увеличиваться, уменьшаться и в целом увеличиваться. Значения кучи можно хранить в массиве.

Двоичная куча — это место, где узел (элемент) имеет двух дочерних элементов. Первый ребенок — левый ребенок, а второй ребенок — правый ребенок. Значение любого узла называется ключом.


Max-Heap

Следующий список представляет собой максимальную кучу, которая уже частично упорядочена и не нуждается в дальнейшем упорядочении:

89, 85, 87, 84, 82, 79, 73, 80, 81, , , 65, 69


89 — первое значение с индексом 0. Это корневой узел (корневой родитель). Это самая большая ценность среди всех ценностей. Его первый потомок (85) имеет индекс 1, индекс которого равен 2(0) + 1, где 0 — индекс родителя. Его второй потомок (87) имеет индекс 2, что равно 2(0) + 2, где 0 — индекс родителя.

85 находится в индексе 1. Это родитель. Его первый потомок (84) имеет индекс 3, что равно 2(1) + 1, где 1 — индекс родителя. Его второй потомок (82) имеет индекс 4, что равно 2(1) + 2, где 1 — индекс родителя.

87 находится в индексе 2. Это родитель. Его первый потомок (79) имеет индекс 5, что равно 2(2) + 1, где 2 — индекс родителя. Его второй потомок (73) имеет индекс 6, что равно 2(2) + 2, где 2 — индекс родителя.

В общем, поскольку подсчет индексов начинается с 0, пусть i представляет индекс родителя массива; и, таким образом, левый (первый) потомок родителя с индексом i имеет индекс 2i + 1; а его правый (второй) дочерний элемент имеет индекс 2i + 2. Некоторые ячейки ближе к концу массива могут быть пустыми; они не должны иметь значений.

Предыдущий список — хороший пример содержимого приоритетной очереди после завершения включения всех элементов. Если первый элемент удаляется, остальные перестраиваются для установки значений, образуя новую очередь приоритетов. Таким образом, удаление всех элементов сверху будет выглядеть так, как будто все элементы отсортированы правильно. Элементы по-прежнему можно получить как есть, в частичном порядке, без удаления какого-либо элемента.


Min-Heap

Min-heap — это обратная сторона max-heap.


Приоритетная очередь в Java

В Java есть класс PriorityQueue для Priority-Queue. Он имеет множество конструкторов и методов. Ниже описаны только три конструктора и более подходящие методы:


Создание очереди приоритетов в Java

Public PriorityQueue()

Это создает приоритетную очередь без какого-либо элемента. Класс PriorityQueue находится в пакете java.util.*, который необходимо импортировать. Следующий сегмент кода создает пустую PriorityQueue, а затем добавляет в очередь несортированные (даже частично не отсортированные) значения:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>();


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85);


Все эти числа целые. Они взяты из частично отсортированного списка, приведенного выше, но в настоящее время они полностью не отсортированы по мере ввода. Элементы в pq теперь частично отсортированы в соответствии с определением приоритетной очереди в Java.


Public PriorityQueue(PriorityQueue<? extends E> c)

Это создает приоритетную очередь из другой приоритетной очереди. Следующий сегмент кода иллюстрирует это:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>();


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85);


PriorityQueue<Integer> pq1 = new PriorityQueue<Integer>(pq);


pq1 был создан из pq. В настоящее время он имеет тот же частичный порядок и pq.

Третий метод конструктора показан ниже.


Java-методы приоритетной очереди

Public Int Size()

Это возвращает размер списка и не включает пустые ячейки, как показано в следующем коде:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>();


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85);


int sz = pq.size();


System.out.println(sz);


Вывод 11.


Public Void forEach(Consumer<? super E> action)

Этот метод нужно использовать особым образом, чтобы скопировать все значения в приоритетной очереди в частично отсортированном виде. Следующая программа иллюстрирует это:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>();


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85);


pq.forEach (item -> System.out.print(item + " "));


System.out.println();


Обратите внимание на то, как сделан код в скобках метода forEach. Элемент — это фиктивная переменная, которая представляет каждый элемент в очереди. Обратите внимание на использование оператора стрелки. Результат:

65 69 84 79 73 87 89 80 81 82 85


Вывод правильный, в частичном порядке, но в порядке возрастания. Это не обязательно обратный порядок, указанный выше, из-за способа включения значений в список. То есть метод forEach возвращает список в виде минимальной кучи. Чтобы вернуть список в порядке убывания, используйте следующий конструктор:


Public PriorityQueue(Comparator<? super E> comparator)

Это конструктор. Следующий код показывает, как его использовать:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>((x, y) -> Integer.compare(y, x));


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85);


pq.forEach (item -> System.out.print(item + " "));


X, y — фиктивные переменные, представляющие меньшее и меньшее значения. Обратите внимание, что в первых скобках для x и y x стоит перед y. Во вторых скобках y стоит перед x. Результат:

89 85 87 80 82 69 84 65 79 73 81

Public Boolean Add(E e)

Количество элементов в приоритетной очереди можно увеличивать по одному. Этот метод возвращает true, если изменение произошло; и ложно в противном случае. Следующий код добавляет в очередь двенадцатое практическое значение:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>((x, y) -> Integer.compare(y, x));


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85); pq.add(70);


pq.forEach (item -> System.out.print(item + " "));


Добавленное значение будет перемещаться вверх по очереди, чтобы занять соответствующую позицию, что приведет к некоторой корректировке позиций элементов. Результат:

89 85 87 80 82 70 84 65 79 73 81 69

Public E Poll()

Этот метод извлекает и удаляет голову очереди; или возвращает null, если эта очередь пуста. Каждый раз, когда голова удаляется, приоритетная очередь перестраивается, чтобы иметь новую законную голову. Если головка продолжает удаляться, возвращаемые значения будут полностью отсортированы. Следующий код иллюстрирует это:

PriorityQueue<Integer> pq = new PriorityQueue<Integer>((x, y) -> Integer.compare(y, x));


pq.add(69); pq.add(65); pq.add(87); pq.add(79);


pq.add(73); pq.add(84); pq.add(89); pq.add(80);


pq.add(81); pq.add(82); pq.add(85); pq.add(70);


pq.forEach (item -> System.out.print(pq.poll() + " "));


Вывод:

89 87 85 84 82 81 80 79 73 70 69 65 Exception in thread "main" java.util.ConcurrentModificationException


at java.base/java.util.PriorityQueue.forEach(PriorityQueue.java:984)


at TheClass.main(TheClass.java:11)


Обратите внимание, что вывод имеет полный отсортированный порядок. Этот конкретный код не смог перехватить выброшенное исключение. Этот вопрос оставлен читателю в качестве исследовательского упражнения.


Заключение

Очередь с приоритетом в Java — это очередь, в которой элементы имеют приоритет, отличный от FIFO. Очередь с приоритетом обычно представляет собой кучу, которая может быть максимальной или минимальной. Значения должны быть одного типа. Они хранятся в очереди в формате кучи (частичный порядок). Мы надеемся, что вы нашли эту статью полезной. Ознакомьтесь с другими статьями Linux Hint, чтобы получить советы и руководства.


2022-02-19T10:06:28
Java

Английский для программистов: учим вместе с Антишколой

Все программисты четко осознают необходимость в англоязычных знаниях. Ведь большинство заказчиков обращаются зарубежных. Для более качественного и профессионального сотрудничества необходимы english знания, специализированную терминологию и умение хорошо коммуницировать на иностранном языке.

Большинство учебных центров предлагают свои услуги в этой отрасли. Антишкола не исключение. Мы приглашаем всех желающих изучить английский для программистов и получить 100% гарантию на получение крутого результата.

Чем же мы отличаемся от других похожих предложений? Наши методы обучения не похожи ни на кого. Наша задача идти в ногу со временем и давать знания согласно современным методам образования. Все мы привыкли к старомодным и всем известным способам преподавания, которые заключались лишь в:

  • постоянной зубрежке грамматических и лексических правил;
  • написании диктантов;
  • вечных проверках знаний, контрольных работах;
  • прохождении большого количества упражнений и заданий;
  • пересказах;
  • стоянии у доски.

Методы обучения

В нашем учебном центре вы не найдете таких подходов в обучении. У нас вы можете увидеть лишь дружественную атмосферу, постоянное общение на различные специализированные темы, разговоры о жизни, просмотры фильмов и посиделки за чаем и вкусняшками. В нашем случае будет самое минимальное время на домашнее задание, а большую часть мы отводим на практику ваших коммуникативных способностей на английском языке.

В начале нашего пути все студенты проходят маленькое и несложное тестирование. Этот тест помогает нам узнавать каждого ученика поближе и понять все его мотивы, задачи, цели и его уровень знаний на данный момент. С такой информацией нам легче расформировать вас к вашим же единомышленникам, чтобы обучение проходило с легкостью и интересом для вас.

Мы проводим курсы английского в таких комфортных форматах, как: онлайн и оффлайн. Онлайн формат имеет главное преимущество в том, что на занятиях можно появляться из любой удобной для вас локации. Для этого вам пригодится любое мультимедийное устройство и приложение скайп.

Оффлайн формат же помогает больше практиковать свои навыки коммуникации, получить больше живого общения и приобрести новые знакомства. Занятия могут проходить в индивидуальном формате, групповом и парном. Весь свой опыт может передать вам и носитель языка. Для особо срочных случаев, в нашем запасе имеются интенсивные курсы.

Английский для программистов учим вместе с Антишколой


Если вы хотите иметь возможность работать не только на отечественном рынке и получать заработную плату намного выше, чем получаете сейчас, то скорее записывайтесь на курсы английского. Antischool поможет исправить все это с легкостью!


2022-02-18T18:25:33
Программирование

Как читать из локального файла в Java

Локальный файл находится на жестком диске или флешке, подключенной к порту USB. Файлы можно разделить на две категории: текстовые файлы и байтовые файлы. Типичные текстовые файлы — это файлы, созданные текстовым редактором. Файл изображения является примером байтового файла, состоящего в основном из необработанных байтов.

В этой статье дается базовое объяснение того, как читать локальные текстовые и байтовые файлы в Java. Чтобы прочитать текстовый файл, используйте класс FileReader. Чтобы прочитать байтовый файл, используйте класс FileInputStream. Оба класса находятся в пакете java.io.*, который необходимо импортировать. Первая половина этой статьи посвящена чтению текстовых файлов, а вторая половина — чтению байтовых файлов.


Чтение текстовых файлов

Создание объекта FileReader

Прежде чем научиться создавать объект FileReader, создайте следующий текстовый файл с помощью текстового редактора и нажмите клавишу Enter в конце первых двух строк:

A text 1 A text 1 A text 1 A text 1 A text 1


B text 2 B text 2 B text 2 B text 2 B text 2


C text 3 C text 3 C text 3 C text 3 C text 3


Если клавиша Enter не нажата в конце последней строки, текстовый редактор может добавить новую строку при сохранении файла. После создания предыдущего текста сохраните содержимое с именем temp.txt, используя меню текстового редактора, user@host :~/dir1$, в каталог. Это означает, что должен быть создан каталог dir1.


Создание программы чтения файлов

Класс FileReader имеет пять конструкторов. В этой статье проиллюстрирован только один (чтобы статья была короткой). Синтаксис конструктора следующий:

public FileReader(String fileName) throws FileNotFoundException


При этом создается в памяти поток (копия) файла, путь и имя которого представляет собой строку fileName. Выдает исключение FileNotFoundException, если файл не найден в указанном каталоге. После копирования содержимого файла открытый файловый объект необходимо закрыть, чтобы освободить любые системные ресурсы, связанные с открытым файлом.


Важные методы FileReader

Если конструктор успешно создан, то файл считается открытым. После использования файл должен быть закрыт. Синтаксис для закрытия файла:

public void close() throws IOException


После того, как файл только что был открыт, эффективное чтение файла еще не произошло. Чтобы читать по одному символу за раз (один, затем следующий), используйте синтаксис метода FileReader:

public int read() throws IOException


Это возвращает прочитанный символ (в виде целого числа) или -1, если достигнут конец потока (потока копирования файла в памяти).

Чтобы прочитать следующую последовательность символов файла в массив, используйте синтаксис метода FileReader:

public int read(char[] cbuf, int off, int len) throws IOException


Он возвращает количество прочитанных символов или -1, если был достигнут конец потока. Off в синтаксисе означает смещение. Это индекс в файле, с которого должно начаться чтение следующей последовательности символов. Len — количество символов для чтения. Это должна быть длина массива, а cbuf — это массив, в который считывается последовательность символов.

Помните, что объект FileReader должен быть закрыт с помощью его метода close после эффективного чтения.

Синтаксис метода, чтобы узнать, не вернет ли следующее чтение -1, таков:

public boolean ready() throws IOException


Он возвращает true, если есть что-то для чтения, и false в противном случае.


Чтение в строку

Следующий код считывает предыдущий файл посимвольно в строку StringBuilder:

            StringBuilder sb = new StringBuilder();

try{

FileReaderfr = new FileReader("dir1/temp.txt");


                while (fr.ready()) {          

                    char ch = (char)fr.read();

sb.append(ch);

                }

            }

catch(Exception e) {

e.getMessage();

            }

System.out.println(sb);


Код начинается с создания экземпляра объекта StringBuilder, sb. Далее идет конструкция try-catch. Блок try начинается с создания экземпляра FileReader, фр. И есть цикл while, который повторяется до тех пор, пока ready() не вернет false. Первый оператор цикла while считывает и возвращает следующий символ в виде целого числа. Его нужно перевести в char. Следующий оператор в цикле while добавляет к строке следующий символ, sb. Результат:

A text 1 A text 1 A text 1 A text 1 A text 1


B text 2 B text 2 B text 2 B text 2 B text 2


C text 3 C text 3 C text 3 C text 3 C text 3


Это в точности содержимое файла, но добавлена ​​лишняя строка на компьютере автора.


Чтение в массив

При чтении в массив содержимое массива должно быть освобождено для чтения следующей последовательности символов. Следующий код иллюстрирует это:

            StringBuilder sb = new StringBuilder();

try{

FileReaderfr = new FileReader("dir1/temp.txt");


                while (fr.ready()) {    

char[] arr = new char[5];

                    int offset = 0;

fr.read(arr, offset, 5);

                    offset = offset + 5;

System.out.print(arr);

                }

            }

catch(Exception e) {

e.getMessage();

            }

System.out.println();


Значение смещения должно увеличиваться для каждой итерации на длину массива. Результат:

A text 1 A text 1 A text 1 A text 1 A text 1


B text 2 B text 2 B text 2 B text 2 B text 2


C text 3 C text 3 C text 3 C text 3 C text 3


Это точно так же, как содержимое файла, но с добавлением дополнительной строки на компьютере автора.


Чтение байтовых файлов

Создание объекта FileInputStream

Следующий файл изображения называется bars.png. Он находится в каталоге user@host :~/dir1$, который совпадает с каталогом temp.txt. Он состоит всего из трех цветных полос:

Создание объекта FileInputStream


Создание FileInputStream

Конструктор для объекта FileInputStream:

public FileInputStream(String name) throws FileNotFoundException


Поскольку он выдает исключение, он должен быть в конструкции try-catch. Помните, что этот класс предназначен для чтения байтов.


Важные методы FileInputStream

Если конструктор успешно создан, то файл считается открытым. После чтения байтов файл необходимо закрыть, используя следующий синтаксис:

public void close() throws IOException


После того, как файл только что был открыт, эффективное чтение файла еще не произошло. Чтобы читать по одному байту за раз (один, затем другой), используйте синтаксис метода FileInputStream:

public int read() throws IOException


Это возвращает прочитанный байт (как целое число) или -1, если достигнут конец потока (потока копирования файла в памяти).

Помните, что после этого эффективного чтения объект FileInputStream должен быть закрыт с помощью его метода close.

Чтобы получить оценку количества байтов, оставшихся для чтения, используйте синтаксис метода:

public int available() throws IOException


Поскольку этот метод возвращает оценку, при использовании в сочетании с read() нельзя быть уверенным, что все байты файла были прочитаны. И следует отдать предпочтение следующему методу, который считывает все байты:

public byte[] readAllBytes() throws IOException


Этот метод возвращает все оставшиеся байты, но все равно будет читать весь файл.


Чтение в ArrayList

ArrayList должен быть импортирован из пакета java.util.*. Следующий код считывает оценку всех байтов в объект ArrayList:

ArrayList al = new ArrayList();

try{

FileInputStream fir = new FileInputStream("dir1/bars.png");


                while (fir.available() > 0) {          

                    byte bt = (byte)fir.read();

al.add(bt);

                }

            }

catch(Exception e) {

e.getMessage();

            }

System.out.println(al);


Код начинается с создания экземпляра объекта ArrayList, например. Далее идет конструкция try-catch. Блок try начинается с создания экземпляра FileInputStream, fir. И есть цикл while, который повторяется, пока не будет доступен(), и предполагает, что не осталось ни одного байта для чтения. Первый оператор цикла while считывает и возвращает следующий байт в виде целого числа. Его нужно преобразовать в байт. Следующий оператор в цикле while добавляет (добавляет) следующий символ в список, т.е. Результат:

[-119, 80, 78, 71, 13, 10, 26, 10, 0, 0, 0, 13, 73, 72, 68, 82, 0, 0, 0, -7, 0, 0, 0, -10, 8, 6, 0, 0, 0, 20, 25, 33, 69, 0, 0, 0, 6, 98, 75, 71, 68, 0, -1, 0, -1, 0, -1, -96, -67, -89, -109, 0, 0, 3, 48, 73, 68, 65, 84, 120, -100, -19, -42, 49, 74, 67, 81, 0, 68, -47, -81, -68, 52, 105, 83, -120, 85, 42, 65, -112, -12, 41, 44, 92, 64, -74, -26, 34, 92, -110, -115, -107, 32, -23, -19, 44, 4, 9, -60, 85, 60, 62, 92, -50, 89, -63, 52, 23, -26, -26, -70, 44, -41, 5, 104, 58, -99 - - - and continues - - - ]


Байты — это целые числа. Будем надеяться, что изображение трех предыдущих баров состоит из всех этих байтов. Идея состоит в том, чтобы программист изменил некоторые байты, изменил изображение, а затем сохранил результат; затем повторно отобразите его с помощью средства просмотра изображений, представляя измененное изображение. Однако это дополнительное расписание не рассматривается в этой статье.


Чтение в массив

Метод readAllBytes() возвращает массив байтов. Итак, просто получите возвращаемые значения с массивом байтов, как показано в следующем коде:

byte[] arr = new byte[1000];

try{

FileInputStream fir = new FileInputStream("dir1/bars.png");


arr = fir.readAllBytes();

            }

catch(Exception e) {

e.getMessage();

            }


            for (int i=0; i<arr.length; i++)

System.out.print(arr[i] + ", ");

System.out.println();


Код начинается с объявления массива, который получит байты. Размер (длина) здесь должен быть выше предполагаемого размера. Предполагаемый размер можно получить с помощью метода available(). Основной код находится в блоке try. Результат:

-119, 80, 78, 71, 13, 10, 26, 10, 0, 0, 0, 13, 73, 72, 68, 82, 0, 0, 0, -7, 0, 0, 0, -10, 8, 6, 0, 0, 0, 20, 25, 33, 69, 0, 0, 0, 6, 98, 75, 71, 68, 0, -1, 0, -1, 0, -1, -96, -67, -89, -109, 0, 0, 3, 48, 73, 68, 65, 84, 120, -100, -19, -42, 49, 74, 67, 81, 0, 68, -47, -81, -68, 52, 105, 83, -120, 85, 42, 65, -112, -12, 41, 44, 92, 64, -74, -26, 34, 92, -110, -115, -107, 32, -23, -19, 44, 4, 9, -60, 85, 60, 62, 92, -50, 89, -63, 52, 23, -26, -26, -70, 44, -41, 5, 104, 58, -99, - - - and continues - - -


Этот вывод и предыдущий совпадают на компьютере автора.


Вывод

Локальные текстовые и байтовые файлы могут быть прочитаны. Чтобы прочитать текстовый файл, используйте класс потока FileReader. Чтобы прочитать байтовый файл, используйте класс потока FileInputStream. Оба класса находятся в пакете java.io.*, который необходимо импортировать. Эти два класса имеют конструкторы и методы, обеспечивающие чтение. Мы надеемся, что эта статья была вам полезна. Дополнительные советы и руководства см. в других статьях Linux Hint.


2022-02-15T12:15:57
Java