Архив метки: PostgreSQL

Резервное копирование PostgreSQL

В данной инструкции рассмотрены варианты и примеры создания резервных копий и восстановления баз СУБД PostgreSQL.


Все команды, которые приводятся ниже, должны выполняться из командной строки. В Linux — это окно терминала, в Windows — командная строка (cmd.exe) с переходом в папку установки PostgreSQL.


Создание резервных копий


Базовая команда


Синтаксис:


pg_dump <параметры> <имя базы> > <файл, куда сохранить дамп>


Пример:


pg_dump users > /tmp/users.dump


Пользователь и пароль


Если резервная копия выполняется не от учетной записи postgres, необходимо добавить опцию -U с указанием пользователя:


pg_dump -U dmosk -W users > /tmp/users.dump


* где dmosk — имя учетной записи; опция W потребует ввода пароля.


Сжатие данных


Для экономии дискового пространства или более быстрой передачи по сети можно сжать наш архив:


pg_dump users | gzip > users.dump.gz


Скрипт для автоматического резервного копирования


Рассмотрим 2 варианта написания скрипта для резервирования баз PostgreSQL. Первый вариант — запуск скрипта от пользователя root для резервирования одной базы. Второй — запуск от пользователя postgres для резервирования всех баз, созданных в СУБД.


Для начала, создадим каталог, в котором разместим скрипт, например:


mkdir /scripts


И сам скрипт: 


vi /scripts/postgresql_dump.sh


Вариант 1. Запуск от пользователя root; одна база.


#!/bin/sh
PATH=/etc:/bin:/sbin:/usr/bin:/usr/sbin:/usr/local/bin:/usr/local/sbin

PGPASSWORD=password
export PGPASSWORD
pathB=/backup
dbUser=dbuser
database=db

find $pathB ( -name "*-1[^5].*" -o -name "*-[023]?.*" ) -ctime +61 -delete
pg_dump -U $dbUser $database | gzip > $pathB/pgsql_$(date "+%Y-%m-%d").sql.gz

unset PGPASSWORD


* где password — пароль для подключения к postgresql; /backup — каталог, в котором будут храниться резервные копии; dbuser — имя учетной записи для подключения к БУБД; pathB — путь до каталога, где будут храниться резервные копии.
* данный скрипт сначала удалит все резервные копии, старше 61 дня, но оставит от 15-о числа как длительный архив. После при помощи утилиты pg_dump будет выполнено подключение и резервирование базы db. Пароль экспортируется в системную переменную на момент выполнения задачи.


Для запуска резервного копирования по расписанию, сохраняем скрипт в файл, например, /scripts/postgresql_dump.sh и создаем задание в планировщике:


crontab -e
3 0 * * * /scripts/postgresql_dump.sh


* наш скрипт будет запускаться каждый день в 03:00.


Вариант 2. Запуск от пользователя postgres; все базы.


#!/bin/bash

PATH=/etc:/bin:/sbin:/usr/bin:/usr/sbin:/usr/local/bin:/usr/local/sbin


pathB=/backup/postgres


find $pathB ( -name "*-1[^5].*" -o -name "*-[023]?.*" ) -ctime +61 -delete


for dbname in `echo "SELECT datname FROM pg_database;" | psql | tail -n +3 | head -n -2 | egrep -v 'template0|template1|postgres'`; do

    pg_dump $dbname | gzip > $pathB/$dbname-$(date "+%Y-%m-%d").sql.gz

done;


* где /backup — каталог, в котором будут храниться резервные копии; pathB — путь до каталога, где будут храниться резервные копии.
* данный скрипт сначала удалит все резервные копии, старше 61 дня, но оставит от 15-о числа как длительный архив. После найдет все созданные в СУБД базы, кроме служебных и при помощи утилиты pg_dump будет выполнено резервирование каждой найденной базы. Пароль нам не нужен, так как по умолчанию, пользователь postgres имеет возможность подключаться к базе без пароля.


Необходимо убедиться, что у пользователя postgre будет разрешение на запись в каталог назначения, в нашем примере, /backup/postgres.


Зададим в качестве владельца файла, пользователя postgres:


chown postgres:postgres /scripts/postgresql_dump.sh


Для запуска резервного копирования по расписанию, сохраняем скрипт в файл, например, /scripts/postgresql_dump.sh и создаем задание в планировщике:


crontab -e -u postgres


* мы откроем на редактирование cron для пользователя postgres.


3 0 * * * /scripts/postgresql_dump.sh


* наш скрипт будет запускаться каждый день в 03:00.


Права и запуск


Разрешаем запуск скрипта, как исполняемого файла:


chmod +x /scripts/postgresql_dump.sh


Единоразово можно запустить задание на выполнение резервной копии:


/scripts/postgresql_dump.sh


… или от пользователя postgres:


su - postgres -c "/scripts/postgresql_dump.sh"


На удаленном сервере


Если сервер баз данных находится на другом сервере, просто добавляем опцию -h:


pg_dump -h 192.168.0.15 users > /tmp/users.dump


* необходимо убедиться, что сама СУБД разрешает удаленное подключение. Подробнее читайте инструкцию Как настроить удаленное подключение к PostgreSQL.


Дамп определенной таблицы


Запускается с опцией -t <table> или —table=<table>:


pg_dump -t students users > /tmp/students.dump


* где students — таблица; users — база данных.


Если наша таблица находится в определенной схеме, то она указывается вместе с ней, например:


pg_dump -t public.students users > /tmp/students.dump


* где public — схема; students — таблица; users — база данных.


Размещение каждой таблицы в отдельный файл


Также называется резервированием в каталог. Данный способ удобен при больших размерах базы или необходимости восстанавливать отдельные таблицы. Выполняется с ипользованием ключа -d:


pg_dump -d customers > /tmp/folder


* где /tmp/folder — путь до каталога, в котором разместяться файлы дампа для каждой таблицы.


Для определенной схемы


В нашей базе может быть несколько схем. Если мы хотим сделать дамп только для определенной схемы, то используем опцию -n, например:


pg_dump -n public peoples > /tmp/peoples.public.sql


* в данном примере мы заархивируем схему public базы данных peoples.


Только схемы (структуры)


Для резервного копирования без данных (только таблицы и их структуры):


pg_dump --schema-only users > /tmp/users.schema.dump


Также, внутри каждой базы могут быть свои схемы с данными. Если нам нужно сделать дамп именно той схемы, которая внутри базы, используем ключ -n:


pg_dump --schema-only users -n production > /tmp/users.schema_production.dump


* в данном примере мы создадим дамп структуры базы данных users только для схемы production.


Или полный дамп с данными для схемы внутри базы данных:


pg_dump users -n production > /tmp/users.production.dump


Только данные


pg_dump --data-only users > /tmp/users.data.dump


Использование pgAdmin


Данный метод хорошо подойдет для компьютеров с Windows и для быстрого создания резервных копий из графического интерфейса.


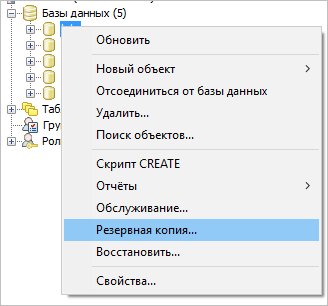
Запускаем pgAdmin — подключаемся к серверу — кликаем правой кнопкой мыши по базе, для которой хотим сделать дамп — выбираем Резервная копия:


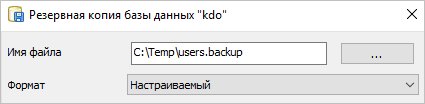
В открывшемся окне выбираем путь для сохранения данных и настраиваемый формат:


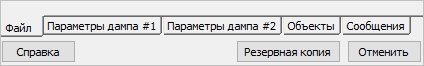
При желании, можно изучить дополнительные параметры для резервного копирования:


После нажимаем Резервная копия — ждем окончания процесса и кликаем по Завершено.


Не текстовые форматы дампа


Другие форматы позволяют делать частичное восстановление, работать в несколько потоков и сжимать данные.


Бинарный с компрессией:


pg_dump -Fc users > users.bak


Тарбол:


pg_dump -Ft users > users.tar


Directory-формат:


pg_dump -Fd users > users.dir


Использование pg_basebackup


pg_basebackup позволяет создать резервную копию для кластера PostgreSQL.


pg_basebackup -h node1 -D /backup


* в данном примере создается резервная копия для сервера node1 с сохранением в каталог /backup.


pg_dumpall


Данная утилита делает выгрузку всех баз данных, в том числе системных. На выходе получаем файл для восстановления в формате скрипта.


pg_dumpall > cluster.bak


Утилиту удобно использовать с ключом -g (—globals-only) — выгрузка только глобальных объектов (ролей и табличных пространств).


Для создание резервного копирования со сжатием:


pg_dumpall | gzip > cluster.tar.gz


Восстановление


Может понадобиться создать базу данных. Это можно сделать SQL-запросом:


=# CREATE DATABASE users WITH ENCODING='UTF-8';


* где users — имя базы; UTF-8 — используемая кодировка.


Если мы получим ошибку:


ERROR:  encoding "UTF8" does not match locale "en_US"
DETAIL:  The chosen LC_CTYPE setting requires encoding "LATIN1".


Указываем больше параметров при создании базы:


CREATE DATABASE users WITH OWNER 'postgres' ENCODING 'UTF8' LC_COLLATE = 'ru_RU.UTF-8' LC_CTYPE = 'ru_RU.UTF-8' TEMPLATE = template0;


Базовая команда


Синтаксис:


psql <имя базы> < <файл с дампом>


Пример:


psql users < /tmp/users.dump


С авторизацией


При необходимости авторизоваться при подключении к базе вводим:


psql -U dmosk -W users < /tmp/users.dump


* где dmosk — имя учетной записи; опция W потребует ввода пароля.


Из файла gz


Сначала распаковываем файл, затем запускаем восстановление:


gunzip users.dump.gz


psql users < users.dump


Или одной командой:


zcat users.dump.gz | psql users


Определенную базу


Если резервная копия делалась для определенной базы, запускаем восстановление:


psql users < /tmp/database.dump


Если делался полный дамп (всех баз), восстановить определенную можно при помощи утилиты pg_restore с параметром -d:


pg_restore -d users cluster.bak


Определенную таблицу


Если резервная копия делалась для определенной таблицы, можно просто запустить восстановление:


psql users < /tmp/students.dump


Если делался полный дамп, восстановить определенную таблицу можно при помощи утилиты pg_restore с параметром -t:


pg_restore -a -t students users.dump


С помощью pgAdmin


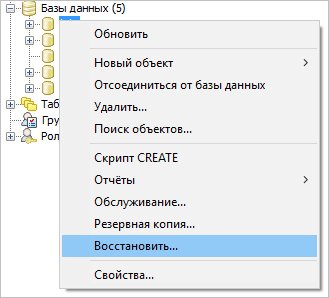
Запускаем pgAdmin — подключаемся к серверу — кликаем правой кнопкой мыши по базе, для которой хотим восстановить данные — выбираем Восстановить:


Выбираем наш файл с дампом:
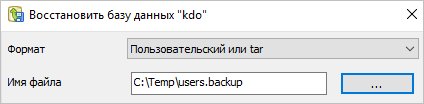


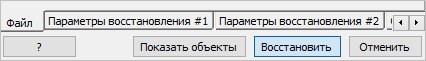
И кликаем по Восстановить:


Использование pg_restore


Данная утилита предназначена для восстановления данных не текстового формата (в одном из примеров создания копий мы тоже делали резервную копию не текстового формата).


Из бинарника:


pg_restore -Fc users.bak


Из тарбола:


pg_restore -Ft users.tar


С созданием новой базы:


pg_restore -Ft -C users.tar


Мы можем использовать опцию d для указания подключения к конкретному серверу и базе, например:


pg_restore -d "postgresql://dmosk_user:dmosk_pass@localhost/dmosk_base" -Fc users.bak


* в данном примере мы подключимся к локальной базе (localhost) с названием dmosk_base от пользователя dmosk_user с паролем dmosk_pass.


Работа с CSV


Мы можем переносить данные с использованием файлов csv. Это нельзя назвать напрямую резервным копированием, но в рамках данной инструкции материал будет интересен.


Создание файла CSV (экспорт)


Пример запроса (выполняется в командной оболочке SQL):


> COPY (SELECT * FROM public.users WHERE name LIKE 'А%') TO '/tmp/users.csv' WITH CSV DELIMITER ';' HEADER;


* в данном примере мы выгрузим все данные для таблицы users в схеме public, где значение поля name начинается с буквы А. Результат будет сохранен в файл /tmp/users.csv. Также мы указываем, что в качестве разделителя данных нужно использовать точку с запятой и первой строкой сделать заголовок.


Также мы можем сделать выгрузку, но сделать вывод в оболочку и перенаправить его в файл:


psql -d "postgresql://pg_user:pg_pass@localhost:5432/pg_databasename" -c "COPY (SELECT * FROM public.users WHERE name LIKE 'А%') TO STDIN WITH CSV DELIMITER ';' HEADER;" > /tmp/users.csv


Импорт данных из файла CSV


Также можно выполнить запрос в оболочке SQL:


> COPY public.users FROM '/tmp/test.csv' DELIMITER ';' CSV HEADER;


Или перенаправить запрос через STDOUT из файла:


psql -d "postgresql://pg_user:pg_pass@localhost:5432/pg_databasename" -c "COPY public.users FROM STDOUT DELIMITER ';' CSV HEADER;" < /tmp/users.csv


* в нашем примере мы выполним импорт данных из ранее созданного файла /tmp/users.csv в таблицу users.


Возможные ошибки


Рассмотрим некоторые проблемы, с которыми можно столкнуться при работе с дампами PostgreSQL.


Input file appears to be a text format dump. please use psql.


Причина: дамп сделан в текстовом формате, поэтому нельзя использовать утилиту pg_restore.


Решение: восстановить данные можно командой psql <имя базы> < <файл с дампом> или выполнив SQL, открыв файл, скопировав его содержимое и вставив в SQL-редактор.


No matching tables were found


Причина: Таблица, для которой создается дамп не существует. Утилита pg_dump чувствительна к лишним пробелам, порядку ключей и регистру.


Решение: проверьте, что правильно написано название таблицы и нет лишних пробелов.


Too many command-line arguments


Причина: Утилита pg_dump чувствительна к лишним пробелам.


Решение: проверьте, что нет лишних пробелов.


Aborting because of server version mismatch


Причина: несовместимая версия сервера и утилиты pg_dump. Может возникнуть после обновления или при выполнении резервного копирования с удаленной консоли.


Решение: нужная версия утилиты хранится в каталоге /usr/lib/postgresql/<version>/bin/. Необходимо найти нужный каталог, если их несколько и запускать нужную версию. При отсутствии последней, установить.


No password supplied


Причина: нет системной переменной PGPASSWORD или она пустая.


Решение: либо настройте сервер для предоставление доступа без пароля в файле pg_hba.conf либо экспортируйте переменную PGPASSWORD (export PGPASSWORD или set PGPASSWORD).


Неверная команда


Причина: при выполнении восстановления возникла ошибка, которую СУБД не показывает при стандартных параметрах восстановления.


Решение: запускаем восстановление с опцией -v ON_ERROR_STOP=1, например:


psql -v ON_ERROR_STOP=1 users < /tmp/users.dump


Теперь, когда возникнет ошибка, система прекратит выполнять операцию и выведет сообщение на экран.


Источник: https://www.dmosk.ru/miniinstruktions.php?mini=postgresql-dump


Как обновить PostgreSQL с 13 до 14

Выпущена новая версия PostgreSQL 14 . Есть несколько способов обновить старую версию 13, и самый простой из них — использовать инструмент pg_upgrade . Вот краткое руководство для систем Ubuntu (или Debian). И, пожалуйста, не забудьте сделать резервную копию ваших данных!


Обновите пакеты и установите новый PostgreSQL 14.


sudo apt-get update
sudo apt-get install postgresql-14 postgresql-server-dev-14


Проверьте, нет ли различий в файлах конфигурации.


diff /etc/postgresql/13/main/postgresql.conf /etc/postgresql/14/main/postgresql.conf
diff /etc/postgresql/13/main/pg_hba.conf /etc/postgresql/14/main/pg_hba.conf


Остановите службу PostgreSQL.


sudo systemctl stop postgresql.service


Войдите как postgresпользователь.


sudo su - postgres


Проверьте кластеры (обратите внимание на --checkаргумент, это не изменит никаких данных).


/usr/lib/postgresql/14/bin/pg_upgrade 
  --old-datadir=/var/lib/postgresql/13/main 
  --new-datadir=/var/lib/postgresql/14/main 
  --old-bindir=/usr/lib/postgresql/13/bin 
  --new-bindir=/usr/lib/postgresql/14/bin 
  --old-options '-c config_file=/etc/postgresql/13/main/postgresql.conf' 
  --new-options '-c config_file=/etc/postgresql/14/main/postgresql.conf' 
  --check


Перенесите данные (без --checkаргумента).


/usr/lib/postgresql/14/bin/pg_upgrade 
  --old-datadir=/var/lib/postgresql/13/main 
  --new-datadir=/var/lib/postgresql/14/main 
  --old-bindir=/usr/lib/postgresql/13/bin 
  --new-bindir=/usr/lib/postgresql/14/bin 
  --old-options '-c config_file=/etc/postgresql/13/main/postgresql.conf' 
  --new-options '-c config_file=/etc/postgresql/14/main/postgresql.conf'


Вернитесь к обычному пользователю.


exit


Поменяйте местами порты для старой и новой версий PostgreSQL.


sudo vim /etc/postgresql/14/main/postgresql.conf
# ...and change "port = 5433" to "port = 5432"

sudo vim /etc/postgresql/13/main/postgresql.conf
# ...and change "port = 5432" to "port = 5433"


Запустите службу PostgreSQL.


sudo systemctl start postgresql.service


Войдите postgresснова как пользователь.


sudo su - postgres


Проверьте новую версию PostgreSQL.


psql -c "SELECT version();"


Запустите рекомендуемую vacuumdbкоманду:


/usr/lib/postgresql/14/bin/vacuumdb --all --analyze-in-stages


В настройках по умолчанию в PostgreSQL 14 есть одно важное изменение. Собственно, вы могли заметить его, проверяя различия в конфигурационных файлах: шифрование паролей. Раньше это был MD5, теперь SHA256. Таким образом, если вы использовали конфигурацию по умолчанию, ваши клиенты не смогут подключиться к новой базе данных. А так как PostgreSQL не знает исходных паролей в открытом виде, вам придется установить их снова для всех пользователей вашей базы данных.


Для этого подключитесь к новой базе данных:


psql


Вы можете перечислить всех существующих пользователей базы данных:


du


Чтобы изменить (или установить заново) пароль пользователя, вы можете использовать следующую команду (повторить для каждого пользователя):


password user_name


Теперь вы можете выйти из psql.


q


И вернуться к обычному пользователю.


exit


Проверьте, какие старые пакеты PostgreSQL установлены.


apt list --installed | grep postgresql


Удалите старые пакеты PostgreSQL (из списка выше).


sudo apt-get remove postgresql-13 postgresql-server-dev-13


Удалите старую конфигурацию.


sudo rm -rf /etc/postgresql/13/


Войдите как postgresпользователь еще раз.


sudo su - postgres


Наконец, удалите старые данные кластера.


./delete_old_cluster.sh


Готово!


PS: Если вы хотите перейти на Postgres 13 или более раннюю версию, ознакомьтесь с более ранним руководством , в этом процессе есть некоторые важные изменения.


Источник: https://www.kostolansky.sk/posts/upgrading-to-postgresql-14/


2022-04-15T16:50:02
Software

Обновление PostgreSQL с 11 до 12 версии

PostgreSQL 12 вышел 03.10.2019. Обновится со старой версии можно через pg_dumpall и pg_upgrade. Ниже описан вариант обновления через pg_upgrade.


Установите PostgreSQL 12:


sudo apt-get update
sudo apt-get install postgresql-12 postgresql-server-dev-12


Перенесите ваши кастомные настройки из старых конфигов в новые. Различия конфигов разных версий удобно посмотреть командами:


diff /etc/postgresql/11/main/postgresql.conf /etc/postgresql/12/main/postgresql.conf
diff /etc/postgresql/11/main/pg_hba.conf /etc/postgresql/12/main/pg_hba.conf


Остановите запущенный PostgreSQL:


sudo systemctl stop postgresql.service


Перейдите в каталог с временными файлами. Туда будут записаны логи и добавлены некоторые скрипты:


cd /tmp


Запускаем работу в командной строке от пользователя postgres:


sudo su postgres


Безопасно проверяем кластеры, без изменения каких-либо данных:


/usr/lib/postgresql/12/bin/pg_upgrade
— old-datadir=/var/lib/postgresql/11/main
— new-datadir=/var/lib/postgresql/12/main
— old-bindir=/usr/lib/postgresql/11/bin
— new-bindir=/usr/lib/postgresql/12/bin
— old-options ‘-c config_file=/etc/postgresql/11/main/postgresql.conf’
— new-options ‘-c config_file=/etc/postgresql/12/main/postgresql.conf’
— check


Если ошибок нет, проводим миграцию данных (если у Вас нет необходимости в копировании файлов в новый кластер, то используйте параметр — link. Будут использованы жесткие ссылки на старый кластер, без копирования):


/usr/lib/postgresql/12/bin/pg_upgrade 
— old-datadir=/var/lib/postgresql/11/main
— new-datadir=/var/lib/postgresql/12/main
— old-bindir=/usr/lib/postgresql/11/bin
— new-bindir=/usr/lib/postgresql/12/bin
— old-options ‘-c config_file=/etc/postgresql/11/main/postgresql.conf’
— new-options ‘-c config_file=/etc/postgresql/12/main/postgresql.conf’


Возвращаемся к обычному пользователю


exit


Ваш старый PostgreSQL, скорее всего, использовал порт 5432, а для нового, по-умолчанию, используется 5433. Меняем друг на друга.


sudo vim /etc/postgresql/12/main/postgresql.conf
# меняем "port = 5433" на "port = 5432"

sudo vim /etc/postgresql/11/main/postgresql.conf
# меняем "port = 5432" на "port = 5433"


Запускаем PostgreSQL


sudo systemctl start postgresql.service


Работаем от пользователя postgres


sudo su postgres


Проверяем версию запущенного PostgreSQL


psql -c "SELECT version();"


На новом кластере нет никакой статистики. Нужно запустить ANALYZE по кластеру. Для этого pg_upgrade создал скрипт analyze_new_cluster.sh. Запускаем.


./analyze_new_cluster.sh


Возвращаемся к обычному пользователю


exit


Смотрим, какие старые версии PostgreSQL остались в системе.


apt list --installed | grep postgresql


Удаляем старые версии PostgreSQL, например:


sudo apt-get remove postgresql-11


Удаляем старую конфигурацию:


sudo rm -rf /etc/postgresql/11/


В последний раз заходим под пользователем postgres


sudo su postgres


Удаляем данные старого кластера


./delete_old_cluster.sh


Обновление завершено!


Источник: https://dmitry-naumenko.medium.com/%D0%BE%D0%B1%D0%BD%D0%BE%D0%B2%D0%BB%D0%B5%D0%BD%D0%B8%D0%B5-postgresql-%D1%81-11-%D0%B4%D0%BE-12-%D0%B2%D0%B5%D1%80%D1%81%D0%B8%D0%B8-b35fa87a0c35


2022-04-15T16:48:23
Software

 Резервное копирование и восстановление баз данных PostgreSQL

Создание резервной копии базы PostgreSQL


Идея, стоящая за методом дампа, заключается в генерации текстового файла с командами SQL, которые при выполнении на сервере, пересоздадут базу данных в том же самом состоянии, в котором она была на момент создания дампа. PostgreSQL предоставляет для этой цели программную утилиту pg_dump. Базовый форма команды выглядит так:


pg_dump имя_БД > файл_дампа


то-есть, pg_dump записывает результаты своей работы на стандартный вывод. Далее будет рассмотрено как из этого можно извлечь пользу.


pg_dump является для PostgreSQL обычным клиентским приложением. Процедура резервного копирования может выполняться с любого удалённого компьютера, который имеет доступ к нужной базе данных. Эта утилита должна иметь доступ на чтение всех таблиц базы данных, резервную копию которых вы хотите сделать, так что на практике её почти всегда нужно запускать с правами суперпользователя СУБД.


Чтобы указать, к какому серверу должен подключаться pg_dump, необходимо использовать опцию командной строки -h сервер и -p порт. По умолчанию, в качестве сервера выбирается localhost или тот сервер, что указан в переменной окружения PGHOST. Похожим образом, по умолчанию используется порт, указанный в переменной окружения PGPORT или, если переменная не заданна, то порт, указанный по умолчанию при компиляции.


Как и любое другое клиентское приложение PostgreSQL, pg_dump по умолчанию будет подключаться к базе данных, под пользователем, имя которого совпадает с именем текущего пользователя в операционной системе. Чтобы изменить пользователя необходимо использовать опцию -U, либо установить нужное значение переменной окружения PGUSER.


Важное преимущество pg_dump над другими методами резервного копирования состоит в том, что базы данных, сохраненные при помощи pg_dump, могут быть залиты в более новые версии PostgreSQL, в то время как резервная копия на уровне файловой системы (простое копирование файлов баз данных) являются жёстко зависимыми от версии сервера.


Также, только pg_dump является методом, который будет работать при переносе базы данных на другую машинную архитектуру, например, при переносе с 32-битной на 64-битную версию сервера.


Дампы, создаваемые pg_dump являются внутренне целостными, что означает, что дамп представляет собой снимок базы данных на момент начала запуска pg_dump. pg_dump не блокирует другие операции с базой данных во время своей работы.


Если  схема базы данных полагается на OID (например, как внешние ключи), вы должны сказать pg_dump, чтобы в дамп были также включены OID. Чтобы сделать это, используйте опцию командной строки -o.


Команда pg_dump может сохранять резервную копию базы в двух форматах: в формате текстовых файлов, содержащих набор команд SQL и специальный формат дампа. Если PostgreSQL была скомпилирована в системе с установленной библиотекой zlib, то специальный формат дампа будет сжимать данные, которые выдаются в файл вывода. Это приведёт к созданию файла дампа, который по размеру будет похож на дамп, сжатый gzip, но такой формат будет иметь преимущество, потому что позволяет выборочное восстановление таблиц. Следующая команда делает дамп базы данных, используя специальный формат дампа:


pg_dump -Fc имя_БД > имя_файла


В принципе можно сжать и текстовый формат резервной копии используя стандартные инструменты Linux — ипользовать программу сжатия, например gzip:


pg_dump имя_БД | gzip > имя_файла.gz


распаковывая впоследствии сжатый дамп командой:


gunzip -c имя_файла.gz | psql имя_БД


или:


cat имя_файла.gz | gunzip | psql имя_БД


При больших базах данных и нежелании использовать сжатие можно использовать команду split. Команда split позволяет разбивать текстовые файлы на файлы меньшего размера, которые не попадают под ограничения на максимальный размер файла в файловой системе. Например, чтобы нарезать дамп на кусочки по 1 мегабайту:


pg_dump имя_БД | split -b 1m - имя_файла


Загружая впоследствии полученные файлы командой:


cat имя_файла* | psql имя_БД


Восстановление резервных копий баз PostgreSQL


Текстовые файлы резервных копий баз данных PostgreSQL, содержащие команды sql, предназначаются для последующего чтения программой psql, то-есть выполнения сгенерированной последовательности скриптов. Общий вид команды для восстановления дампа:


psql имя_БД < файл_дампа


где файл_дампа — это файл, содержащий вывод команды pg_dump. База данных, заданная параметром имя_БД не будет создана данной командой, так что ее необходимо предварительно создать из шаблона базы template0 перед запуском psql, например, с помощью команды:


createdb -T template0 имя_БД


psql поддерживает опции для указания сервера, к которому осуществляется подключение и имени пользователя, похожие на pg_dump.


Перед восстановлением SQL дампа, все пользователи, которые владеют объектами или имеют права на объекты в базе данных, выгруженной в дамп, должны уже существовать. Если их нет, при восстановлении будут ошибки пересоздания объектов с оригинальными владельцами и/или правами.


По умолчанию, если произойдёт ошибка SQL, программа psql продолжит своё выполнение. Можно запустить psql с установленной переменной ON_ERROR_STOP, чтобы  заставить psql в случае возникновения ошибки SQL завершить работу с кодом 3:


psql --set ON_ERROR_STOP=on имя_БД < файл_дампа


В любом случае база данных будет только частично восстановлена. В качестве альтернативы можно задать, что-бы весь дамп должен быть восстановлен в одной транзации, так что восстановление или будет полностью выполненно или полностью не выполнено. Данный режим может быть задан, с помощью опций командной строки -1 или —single-transaction для psql.


Возможность pg_dump и psql писать и читать из конвееров, делают возможным создание дампа базы данных напрямую с одного сервера на другой, например:


pg_dump -h сервер1 имя_БД | psql -h сервер2 имя_БД


Дампы, которые делает pg_dump являются относительными template0. Это означает, что любые языки, процедуры и т.д. добавленные через template1, также попадут в дамп при выполнении pg_dump. В итоге, при восстановлении, если вы использовали специально изменённый template1, вы должны создать пустую базу данных из template0, как показано в примере выше.


После восстановления резервной копии, очень рекомендуется запустить ANALYZE на каждую базу данных для того, чтобы оптимизатор запросов получил нужную статистику.


Специальный формат дампа не является скриптом для psql и должен восстанавливаться с помощью команды pg_restore, например:


pg_restore -d имя_БД имя_файла


Для очень больших баз данных, вам может понадобиться сочетать split с одним из двух других методов.


Резервное копирование всего кластера баз данных PostgreSQL


pg_dump делает дамп только одной базы данных и не включает в дамп информацию о ролях или табличных пространствах (потому что эти данные относятся скорее к уровню кластера, чем к самой базе данных). Для создания резервной копии всего содержимого кластера баз данных, существует программа pg_dumpall. pg_dumpall делает резервную копию каждой базы данных кластера, а также служебные данные уровня кластера, такие как роли и определения табличных пространств. Базовая форма использования этой команды:


pg_dumpall > файл_дампа


Результирующий дамп может быть восстановлен с помощью psql:


psql -f файл_дампа postgres


При восстановлении дампа, сделанного pg_dumpall, всегда необходимо, выполнять восстановление с правами суперпользователя баз данных, потому что они требуются для восстановления ролей и информации о табличных пространствах.


Источник: https://www.oslogic.ru/knowledge/718/rezervnoe-kopirovanie-i-vosstanovlenie-baz-dannyh-postgresql/


2022-04-15T16:44:17
Software

PostgreSQL. Как создать базу данных в Windows 10?

Когда мы говорим о PostgreSQL, мы всегда думаем о базах данных, потому что это система управления базами данных. Вы можете создать на своем сервере PostgreSQL столько баз данных, сколько захотите. После создания базы данных по вашему выбору вы можете создать в ней несколько таблиц для хранения ваших данных, а затем вы можете выполнять различные вычисления с этими данными. Однако иногда мы хотим выполнить запрос к существующей базе данных, но для этого наличие такой базы данных обязательно.

Мы хотим сказать, что нам нужен механизм для проверки, существует ли база данных на нашем сервере PostgreSQL или нет. Более того, бывают ситуации, когда мы хотим, чтобы база данных создавалась после выполнения запроса, если она еще не существует на нашем сервере базы данных. В этом случае в игру вступает нотация «Создать базу данных, если не существует». Это руководство призвано познакомить вас с использованием этой нотации с кратким обсуждением того, поддерживает ли PostgreSQL эту нотацию или нет. После этого мы поделимся с вами альтернативой этой нотации, поддерживаемой PostgreSQL.


Можем ли мы использовать нотацию «Создать базу данных, если не существует» в PostgreSQL в Windows 10?

Обозначение «Создать базу данных, если не существует» поддерживается некоторыми языками программирования. С помощью этой нотации вы можете проверить, существует ли указанная база данных на вашем сервере баз данных или нет, и если она не существует, то эта нотация просто создаст эту базу данных на вашем сервере. Однако поговорим конкретно о PostgreSQL. PostgreSQL не поддерживает эту нотацию, или, другими словами, вы можете сказать, что мы не можем использовать эту нотацию непосредственно в PostgreSQL в Windows 10.

Тем не менее, есть еще несколько способов, которые позволят вам достичь той же функциональности, которую вы можете достичь с помощью этой конкретной нотации. Чтобы узнать больше об этих обходных путях, вам придется продолжить чтение этой статьи.


Если нет, то какое обходное решение мы можем использовать для достижения той же цели?

Поскольку нотация «Создать базу данных, если не существует» не может использоваться в среде PostgreSQL, поэтому мы решили поделиться с вами обходным путем, с помощью которого вы можете достичь той же функциональности. Для этого обходного пути вам нужно будет выполнить несколько иной вариант этой нотации в форме запроса PostgreSQL в Windows 10. Чтобы понять этот вариант, вам нужно будет выполнить шаги, описанные ниже:

Примечание
Не забудьте войти на свой сервер PostgreSQL, прежде чем выполнять эти шаги.


Шаг №1: просмотр существующих баз данных PostgreSQL в Windows 10:

Все мы знаем, что хотим создать конкретную базу данных в PostgreSQL только в том случае, если она уже существует на нашем сервере. База данных, которую мы хотим создать в данном конкретном случае, называется «myNewDB». Поэтому сначала мы попытаемся узнать имена всех наших существующих баз данных PostgreSQL, чтобы узнать, существует ли такая база данных на нашем сервере или нет. Чтобы отобразить имена всех существующих баз данных PostgreSQL, вам необходимо выполнить следующий запрос PostgreSQL в консоли psql:

# SELECT datname FROM pg_database;


Этот запрос извлечет атрибут «datname» из pg_database нашего сервера PostgreSQL. Этот атрибут содержит имена всех существующих баз данных на сервере PostgreSQL. Оператор SELECT в PostgreSQL просто отображает извлеченные имена баз данных на консоли, как показано ниже:

postgres=# SELECT datname FROM pg_database;

datname

postgres sampledb template1 template0 abc abcdb defdb mydb (8 rows)

postgres=#

Из вывода, показанного на изображении выше, видно, что на нашем сервере PostgreSQL нет базы данных с именем «myNewDB»; поэтому мы можем попытаться создать базу данных с этим именем на нашем сервере в Windows 10.


Шаг №2: Создание базы данных PostgreSQL, если она не существует в Windows 10:

Теперь, когда мы увидели, что база данных, которую мы хотим создать, еще не существует на нашем сервере PostgreSQL, поэтому нам нужно будет выполнить следующий запрос для создания этой базы данных:

# SELECT ‘CREATE DATABASE myNewDB’ WHERE NOT EXISTS (SELECT FROM pg_database WHERE datname = ‘myNewDB’)gexec


С помощью этого запроса мы создадим базу данных с именем «myNewDB», которой еще не было на нашем сервере PostgreSQL в нашей системе Windows 10. За оператором SELECT в этом запросе следует оператор CREATE DATABASE. После этого мы упомянули имя нашей новой базы данных, которую нужно создать. Вы можете называть его как хотите. Затем мы написали оператор «WHERE NOT EXISTS», который проверяет, существует ли указанная база данных на сервере PostgreSQL или нет. За всеми этими операторами следует подзапрос, в котором есть еще один оператор «SELECT FROM», который проверяет pg_database нашего сервера PostgreSQL, чтобы подтвердить отсутствие базы данных, которую вы пытаетесь создать.

Наконец, есть параметр «gexec», завершающий этот запрос. Этот параметр чрезвычайно важен в этом запросе. Этот параметр отправляет текущий буфер запроса на сервер PostgreSQL, где каждый компонент или атрибут вывода этого запроса обрабатывается как запрос SQL, а не как запрос PostgreSQL. Фактически, это основная причина работы нотации «Создать базу данных, если не существует» в PostgreSQL. В противном случае, даже если вы случайно пропустите этот параметр, вы не сможете реализовать эту функцию в PostgreSQL.

postgres=# SELECT 'CREATE DATABASE myNewDB' WHERE NOT EXISTS (SELECT FROM pg database WHERE datname = 'myNewDB')gexec


Если вы правильно выполните весь синтаксис этого запроса, то база данных PostgreSQL с указанным именем будет успешно создана на сервере PostgreSQL, что вы можете подтвердить из выходного ответа, показанного на изображении ниже:

postgres=# SELECT 'CREATE DATABASE myNewDB' WHERE NOT EXISTS (SELECT FROM pg_database WHERE datname = 'myNewDB')gexec

CREATE DATABASE postgres=#


Шаг № 3: Проверка, была ли создана новая база данных PostgreSQL в Windows 10 или нет:

Если вы все еще не уверены, что ваша попытка создания новой базы данных PostgreSQL на вышеупомянутом шаге была успешной или нет, вы все равно можете проверить это, снова взглянув на все существующие базы данных PostgreSQL. На этот раз вы также сможете найти там свою новую базу данных. Вам просто нужно выполнить следующий запрос, чтобы увидеть это:

# SELECT datname  FROM pg_database;


На данный момент на нашем сервере PostgreSQL существует девять баз данных, и фактически самая последняя из них — это та, которую мы только что попытались создать, как показано ниже:

postgres=# SELECT datname FROM pg_database;

datname

postgres sampledb template1 template0 abc abcdb defdb mydb mynewdb (9 rows)

postgres=#


Заключение:

В этой статье говорилось о нотации «Создать базу данных, если не существует» и ее использовании. Затем мы обсудили, поддерживается ли эта нотация в PostgreSQL или нет. Узнав, что мы не можем использовать эту нотацию непосредственно в PostgreSQL, мы поделились с вами методом достижения той же функциональности, оставаясь в среде PostgreSQL.


2021-10-03T09:37:32
OS Windows

Настройка репликации PostgreSQL в контейнерах Docker

Мы рассмотрим процесс поднятия двух контейнеров с PostgreSQL и настройки репликации данных между ними. Использовать будем систему на базе Linux, однако, сам процесс настройки Docker и репликации не зависит от операционной системы.


Подготовка компьютера


На компьютере, где мы будем запускать наш кластер баз данных должен быть установлен Docker. Также мы сразу рассмотрим развертывание нужной нам инфраструктуры в docker-compose. Для установки необходимой одноименной платформы смотрим инструкцию Установка Docker на Linux.


После мы можем переходить к поднятию контейнеров.


Запуск контейнеров с СУБД


Как говорилось выше, мы будем поднимать наши контейнеры с помощью docker-compose.


Создадим каталог, в котором будем работать:


mkdir -p /opt/docker/postgresql


Переходим в него:


cd /opt/docker/postgresql


Создаем файл для docker-compose:


vi docker-compose.yml


---


services:


  postgresql_01:

    image: postgres

    container_name: postgresql_01

    restart: always

    volumes:

      - /data/postgresql_01:/var/lib/postgresql/data

    environment:

      POSTGRES_PASSWORD: postgres024


  postgresql_02:

    image: postgres

    container_name: postgresql_02

    restart: always

    volumes:

      - /data/postgresql_02/:/var/lib/postgresql/data

    environment:

      POSTGRES_PASSWORD: postgres024


* рассмотрим некоторый опции подробнее:


Запускаем наши контейнеры:


docker-compose up -d


Мы должны увидеть:


Creating postgresql_02 ... done

Creating postgresql_01 ... done


А если вывести список контейнеров:


docker ps


… мы должны увидеть наши два.


Теперь можно переходить к настройке репликации.


Настройка репликации


Условимся, что первичный сервер или master будет в контейнере с названием postgresql_01. Вторичный — postgresql_02. Мы будем настраивать потоковую (streaming) асинхронную репликацию.


Настройка на мастере


Подключаемся к контейнеру docker:


docker exec -it postgresql_01 bash


Заходим под пользователем postgres:


su - postgres


Создаем пользователя, под которым будем подключаться со стороны вторичного сервера:


createuser --replication -P repluser


* в данном примере будет создаваться учетная запись repluser с правами репликации.


Система потребует ввода пароля. Придумываем его и набираем дважды.


Выходим из-под пользователя postgres:


exit


Выходим из контейнера:


exit


Открываем конфигурационный файл postgresql.conf:


vi /data/postgresql_01/postgresql.conf


Приводим к следующием виду некоторые параметры:


wal_level = replica

max_wal_senders = 2

max_replication_slots = 2

hot_standby = on

hot_standby_feedback = on


* где


Посмотрим подсеть, которая используется для контейнеров с postgresql:


docker network inspect postgresql_default | grep Subnet


В моем случае, ответ был:


"Subnet": "172.19.0.0/16",


Теперь открываем файл:


vi /data/postgresql_01/pg_hba.conf


И добавляем строку после остальных «host    replication»:


host    replication     all             172.19.0.0/16           md5


* в данном примере мы разрешили подключение пользователю replication из подсети 172.19.0.0/16 с проверкой подлинности по паролю.


Перезапустим докер контейнер:


docker restart postgresql_01


Настройка на слейве


Выполним настройку вторичного сервера. Для начала, удалим содержимое рабочего каталога вторичной базы:


rm -r /data/postgresql_02/*


* в данном примере мы удалим все содержимое каталога /data/postgresql_02.


Мы должны быть уверены, что в базе нет ничего важного. Только после этого стоить удалять данные.


Заходим внутрь контейнера postgresql_02:


docker exec -it postgresql_02 bash


Выполняем команду:


su - postgres -c "pg_basebackup --host=postgresql_01 --username=repluser --pgdata=/var/lib/postgresql/data --wal-method=stream --write-recovery-conf"


* где postgresql_01 — наш мастер; /var/lib/postgresql/data — путь до каталога с данными слейва.


Система должна запросить пароль для пользователя repluser — вводим его. Начнется процесс репликации, продолжительность которого зависит от объема данных.


Проверка


Смотрим статус работы мастера:


docker exec -it postgresql_01 su - postgres -c "psql -c 'select * from pg_stat_replication;'"


Смотрим статус работы слейва:


docker exec -it postgresql_02 su - postgres -c "psql -c 'select * from pg_stat_wal_receiver;'"


Источник: https://www.dmosk.ru/miniinstruktions.php?mini=postgresql-replication-docker