Протокол TCP является одним из важнейших протоколов связи в компьютерных сетях. В этой статье познакомимся с ним поближе.
Архив рубрики: Публикации
Обновление Zabbix 4.2 до 4.4
Что нового в версии zabbix 4.4
О нововведениях свежей версии zabbix 4.4 в этот раз я почти ничего не слышал. Не видел ни статей на эту тему, ни видео выступлений, хотя обычно наблюдаю их. Либо материала было меньше, либо просто все прошло вне поля моего зрения. Слышал только, что готовится поддержка TimescaleDB, видел публикации на эту тему. Так что пришлось читать официальные what’s news и release notes на самом сайте zabbix. Вот что нового нам обещают в zabbix 4.4.
- Новый zabbix-agent, написанный на Go. Из новых возможностей агента заявлено — фреймворк для кастомизации проверок, возможность сохранения состояния между проверками, более гибкий планировщик, более эффективная передача данных, замена текущих агентов с поддержкой большего количества платформ в будущем.
- Вебхуки и более продвинутая логика для действий и оповещений на основе JavaScript. С помощью этих улучшений станет проще настраивать интеграцию с внешними сервисами.
- Новый стандарт для шаблонов. Как я понял, разработчики решили упорядочить создание шаблонов и предложили свой формат для их оформления. Подробнее описано в Zabbix template guidelines. Я пока еще не вникал и не разбирался с этой темой. Посмотрим, что в итоге получится. На мой взгляд хороший шаг сделан. Давно пора было как-то упорядочить шаблоны.
- Как я уже сказал ранее, добавлена поддержка TimescaleDB. Это должно существенно увеличить производительность хранилища данных, что является узким место системы мониторинга zabbix.
- Реализована база знаний для итемов и триггеров. Теперь их можно будет документировать. Любопытная фича, надо будет попробовать. Я обычно поле description для этого раньше использовал.
- Расширился функционал визуализации. Появились новые виджеты для дашбордов, новые типы графиков, возможность агрегировать данные с помощью функций.
- Добавилась поддержка новых версий операционных систем — centos 8, debian 10 и т.д.
Нововведения, как обычно, любопытные и кое-где я обновлю сервера, чтобы потестировать новые фичи. Там, где новый функционал не нужен, обновление ставить не буду. Я больше предпочитаю использовать LTS версии в production.
Основные нововведения Zabbix 4.4 разобрали, приступим к обновлению.
Подготовка к обновлению
Если у вас версия Zabbix ниже 4.0, то предварительно обновите ее до указанной. У меня есть цикл статей на тему обновления Zabbix:
Перед обновлением, сделаем на всякий случай бэкап базы данных. Для этого предварительно остановим сервер.
systemctl stop zabbix-server


/usr/bin/mysqldump --opt -v --databases zabbix -uzabbix -p'password' | /usr/bin/gzip -c > /root/zabbix.sql.gz
| zabbix | название базы данных заббикса |
| -uzabbix | ключ -u и дальше имя пользователя базы данных |
| -p’password’ | ключ -p и дальше пароль пользователя бд, если в пароле есть спецсимволы, экранируйте их одиночными кавычками |
На всякий случай сохраним php скрипты админки, чтобы можно было оперативно запустить старую версию в случае нештатной ситуации:
cp -R /usr/share/zabbix /root
Centos 7
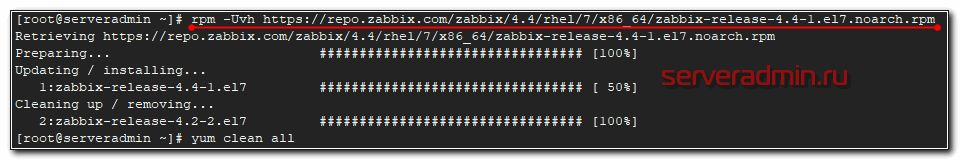
Подключаем репозиторий версии zabbix 4.4:
rpm -Uvh https://repo.zabbix.com/zabbix/4.4/rhel/7/x86_64/zabbix-release-4.4-1.el7.noarch.rpm
Centos 8
rpm -Uvh https://repo.zabbix.com/zabbix/4.4/rhel/8/x86_64/zabbix-release-4.4-1.el8.noarch.rpm
Старый репозиторий от версии 4.2 будет автоматически удален.
Очищаем и пересоздаем кэш yum:
yum clean all


yum makecache
Debian 9
Удаляем пакет текущего репозитория:
rm -Rf /etc/apt/sources.list.d/zabbix.list
Подключаем новый:
wget https://repo.zabbix.com/zabbix/4.4/debian/pool/main/z/zabbix-release/zabbix-release_4.4-1%2Bstretch_all.deb

dpkg -i zabbix-release_4.4-1+stretch_all.deb
Обновляем информацию о репозиториях:
apt update
Debian 10
Удаляем пакет текущего репозитория:
rm -Rf /etc/apt/sources.list.d/zabbix.list
Подключаем новый:
wget https://repo.zabbix.com/zabbix/4.4/debian/pool/main/z/zabbix-release/zabbix-release_4.4-1%2Bbuster_all.deb

dpkg -i zabbix-release_4.4-1+buster_all.deb
Обновляем информацию о репозиториях:
apt update
Ubuntu 18
Удаляем пакет текущего репозитория:
rm -Rf /etc/apt/sources.list.d/zabbix.list
Подключаем новый:
wget https://repo.zabbix.com/zabbix/4.4/ubuntu/pool/main/z/zabbix-release/zabbix-release_4.4-1%2Bbionic_all.deb

dpkg -i zabbix-release_4.4-1+bionic_all.deb
Обновляем информацию о репозиториях:
apt update
Если у вас другие версии систем, то простой найдите ссылки пакетов под свою версию в официальном репозитории — https://repo.zabbix.com/zabbix/4.4/ Дальнейшее обновление не будет отличаться от текущего.
К обновлению подготовились, можно приступать.
Установка обновления zabbix 4.2 до 4.4
Centos
Устанавливаем само обновление zabbix на сервер Centos следующей командой:
yum upgrade zabbix-server-mysql zabbix-web zabbix-agent
Это список пакетов заббикса для общего случая. Если у вас установлено что-то еще, лучше обновить все сразу. Посмотреть список установленных пакетов zabbix можно командой:
rpm -qa | grep zabbix

  zabbix-sender-4.0.4-1.el7.x86_64
  zabbix-threat-control-host-.24-el7.noarch
  zabbix-release-4.0-1.el7.noarch
  zabbix-threat-control-main-.49-el7.noarch
  zabbix-get-4.0.4-1.el7.x86_64
  zabbix-web-4.0.4-1.el7.noarch
  zabbix-agent-4.0.4-1.el7.x86_64
  zabbix-server-mysql-4.0.4-1.el7.x86_64
В моем случае есть еще пакеты zabbix-get и zabbix-sender. Обновляем все сразу:
yum upgrade zabbix-server-mysql zabbix-web zabbix-agent zabbix-get zabbix-sender
Debian / Ubuntu
Устанавливаем само обновление zabbix на сервер с Debian или Ubuntu следующей командой:
apt-get install --only-upgrade zabbix-server-mysql zabbix-frontend-php zabbix-agent
Дальше инструкция общая для всех систем. После завершения обновления, запускаем сервер:
systemctl start zabbix-server
В момент запуска произойдет обновление базы данных. Для маленькой базы (1-2 гб) это не займет много времени. Вы можете даже не заметить процесса. Если база больше, то надо подождать, пока не закончится обновление. Следить за ним можно с помощью просмотра лог файла zabbix сервера.
tail -f /var/log/zabbix/zabbix_server.log
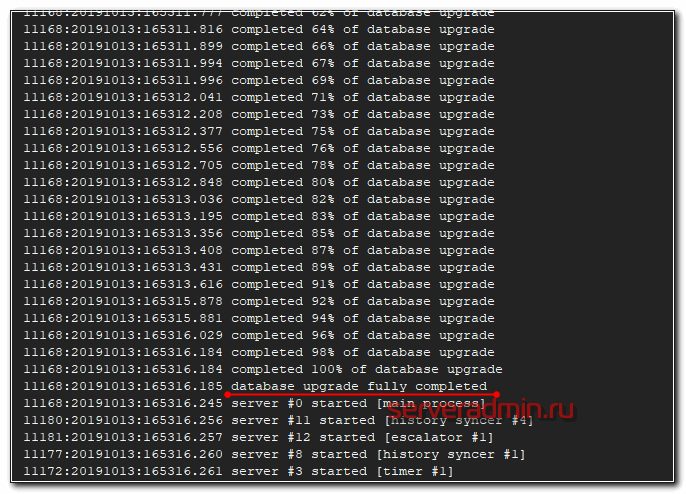
После завершения обновления базы, сервер запустится. После этого можно запустить и агент.
systemctl start zabbix-agent
В логах агента и сервера можно посмотреть версию запущенных сервисов.
Starting Zabbix Agent [zb.serveradmin.ru]. Zabbix 4.4.0 (revision cfac660b25).

Starting Zabbix Server. Zabbix 4.4.0 (revision cfac660b25).
Теперь можно идти в веб интерфейс и смотреть на обновленную версию zabbix server. Перед этим почистите кэш браузера и удалите куки от страницы заббикса. Если этого не сделать, то могут быть проблемы и ошибки, с чем я не раз сталкивался. Если у вас в качестве веб сервера используется nginx, не забудьте поменять владельца директории /etc/zabbix/web на nginx. После обновления он будет принадлежать apache, а web интерфейс не будет работать.
chown -R nginx:nginx /etc/zabbix/web
В веб интерфейсе в самом низу будет показана текущая версия сервера:
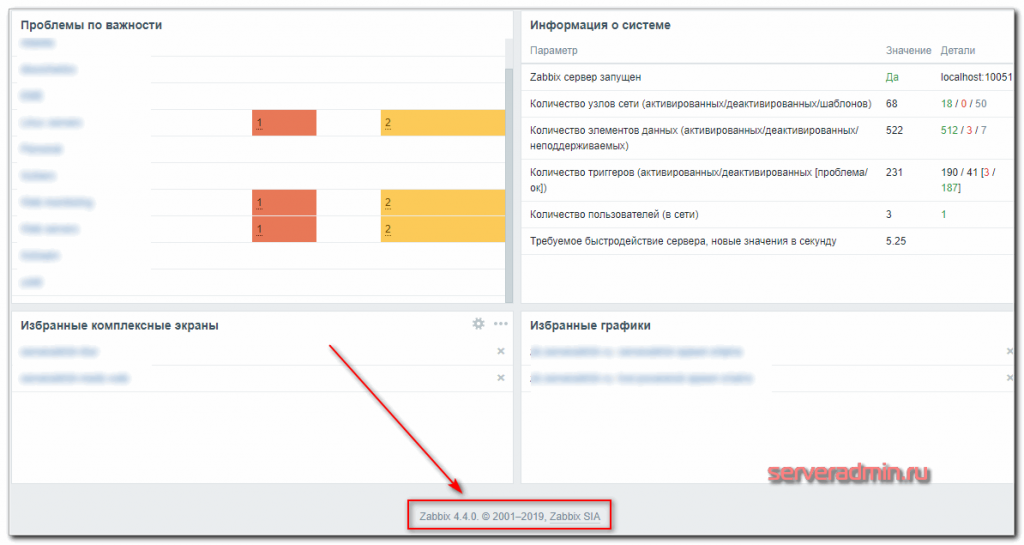
Можете изучать новую версию zabbix 4.4 и пробовать улучшения.
Заключение
Не понравилась статья и хочешь научить меня администрировать? Пожалуйста, я люблю учиться. Комментарии в твоем распоряжении. Расскажи, как сделать правильно!
Процедура обновления Zabbix сервера обычно не сложная. Проблемы чаще всего возникают в двух случаях:
- Проблемы с зависимостями пакетов, чаще всего php или mysql.
- Большая база данных, которая очень долго обновляется, либо не обновляется по какой-то причине.
Первая проблема решается ручным удалением или установкой нужных пакетов. Тут универсального совета дать невозможно. Зависит от того, что вы делали на сервере и почему у вас сломаны зависимости. Вторая проблема решается, в зависимости от причин проблем с базой. Если она слишком большая и поэтому все тормозит и длится слишком долго, надо либо ускорять сервер, либо чистить базу.
Иногда база не обновляется из-за каких-то проблем с записями. Чаще всего в полях acknowledged, куда можно понаписать всего, что угодно. Надо тоже разбираться по месту и удалять то, что мешает обновлению. Но в общем и целом, обновление проходит штатно и лично у меня никогда не было с ним проблем.
Источник: https://serveradmin.ru/obnovlenie-zabbix-4-2-do-4-4/
2021-03-07T22:21:50
Software
Установка и начальная настройка сервера мониторинга Zabbix на Ubuntu Server
Сервер Zabbix используется для сбора и анализа информации о состоянии узлов сети. В данной статье будет рассмотрен процесс его установки и развертывания веб-интерфейса для его управления. В качестве сервера баз данных мы будем использовать MariaDB/MySQL. Версия операционной системы, которая использовалась для написания инструкции — 18.04 (LTS), версия Zabbix — 4.2.
Подготовка сервера
Перед установкой Zabbix выполняем подготовительные процедуры.
1. Правильное время
Для получения актуальной информации необходимо, чтобы на сервере было правильное время.
Для этого сначала задаем правильную временную зону:
timedatectl set-timezone Europe/Moscow
* в данном примере задается московское время.
Затем устанавливаем и запускаем сервис синхронизации времени:
apt-get install chrony

systemctl enable chrony

systemctl start chrony
2. Настройка брандмауэра
Для работы сервера, открываем следующие порты:
ufw allow 80,443,10050,10051/tcp

ufw allow 10050,10051/udp
* где 80 — порт для http запросов (веб-интерфейс); 443 — для https запросов (веб-интерфейс); 10050 — порты для получения информации от zabbix агентов.
Установка веб-сервера
Управление сервером Zabbix будет осуществляться посредством веб-интерфейса. Для этого необходимо установить и настроить веб-сервер, СУБД и PHP.
СУБД
В данному инструкции мы будем использовать сервер баз данных mariadb.
Для установки вводим:
apt-get install mariadb-server
Разрешаем автозапуск сервера баз данных и запускаем mariadb:
systemctl enable mariadb

systemctl start mariadb
Задаем пароль для суперпользователя СУБД:
mysqladmin -u root password
* после ввода команды система потребует ввести пароль два раза.
Веб-сервер
Для наших целей будем использовать веб-сервер NGINX.
Для его установки вводим команду:
apt-get install nginx
Запускаем nginx и разрешаем его автозапуск:
systemctl enable nginx

systemctl start nginx
Открываем веб-браузер и переходим по ссылке http://<IP-адрес сервера>/ — мы должны увидеть окно приветствия:

PHP и PHP-FPM
Интерфейс zabbix разработан на PHP — наш веб-сервер должен обрабатывать скрипты, написанные на нем.
Устанавливаем php и необходимые компоненты:
apt-get install php php-fpm php-mysql php-pear php-cgi php-common php-ldap php-mbstring php-snmp php-gd php-xml php-gettext php-bcmath
Для настройки php, открываем файл:
nano /etc/php/7.2/fpm/php.ini
* где 7.2 — версия PHP. В вашем случае это может быть другая версия. Проверить можно командой php -v.
Редактируем следующие параметры:
date.timezone = "Europe/Moscow"

...

max_execution_time = 300

...

post_max_size = 16M

...

max_input_time = 300

...

max_input_vars = 10000
Разрешим запуск php-fpm и перезапустим его:
systemctl enable php7.2-fpm

systemctl restart php7.2-fpm
NGINX + PHP
Для того, чтобы NGINX обрабатывал PHP, открываем конфигурационный файл:
nano /etc/nginx/sites-enabled/default
В секции location добавляем параметр index:
location / {

        index  index.php;

        ...

    }
Внутри секции server добавим следующее:
  location ~ .php$ {

        set $root_path /var/www/html;

        fastcgi_buffer_size 32k;

        fastcgi_buffers 4 32k;

        fastcgi_pass unix:/run/php/php7.2-fpm.sock;

        fastcgi_index index.php;

        fastcgi_param SCRIPT_FILENAME $root_path$fastcgi_script_name;

        include fastcgi_params;

        fastcgi_param DOCUMENT_ROOT $root_path;

    }
* где /var/www/html — корневой путь хранения скриптов; /run/php/php7.2-fpm.sock — путь до сокетного файла php-fpm (точное расположение файла можно посмотреть в конфигурационном файле /etc/php/7.2/fpm/pool.d/www.conf).
Проверяем настройки nginx:
nginx -t
И перезагружаем его:
systemctl restart nginx
Создаем index.php со следующим содержимым:
nano /var/www/html/index.php
<?php phpinfo(); ?>
Открываем веб-браузер и переходим по ссылке http://<IP-адрес сервера>/ — теперь мы должны увидеть сводную информацию по PHP и его настройкам:

Веб-сервер готов для работы с Zabbix Web.
Установка и настройка сервера Zabbix
Переходим к установке самого Zabbix сервера.
Установка
Сначала установим репозиторий последней версии Zabbix. Для этого переходим на страницу https://repo.zabbix.com/zabbix/ и переходим в раздел с самой последней версией пакета — затем переходим в ubuntu/pool/main/z/zabbix-release/ — копируем ссылку на последнюю версию релиза:

* в моем случае это ссылка на https://repo.zabbix.com/zabbix/4.2/ubuntu/pool/main/z/zabbix-release/zabbix-release_4.2-1+bionic_all.deb. Чтобы понять, какое кодовое название нашей системы, вводим команду cat /etc/lsb-release | grep DISTRIB_CODENAME.
Скачиваем файл репозитория командой:
wget https://repo.zabbix.com/zabbix/4.2/ubuntu/pool/main/z/zabbix-release/zabbix-release_4.2-1%2Bbionic_all.deb
Устанавливаем его:
dpkg -i zabbix-release_4.2-1+bionic_all.deb
Обновляем списки пакетов:
apt-get update
Устанавливаем сервер, вводя команду:
apt-get install zabbix-server-mysql zabbix-frontend-php zabbix-get
Настройка базы данных
Входим в оболочку ввода sql-команд:
mysql -uroot -p
Создаем базу данных:
> CREATE DATABASE zabbix DEFAULT CHARACTER SET utf8 DEFAULT COLLATE utf8_bin;
* мы создали базу zabbix.
Создаем пользователя для подключения и работы с созданной базой:
> GRANT ALL PRIVILEGES ON zabbix.* TO zabbix@localhost IDENTIFIED BY 'zabbixpassword';
* в данном примете мы создали пользователя zabbix с доступом к базе zabbix и паролем zabbixpassword.
Выходим из sql-оболочки:
> q
В составе zabbix идет готовая схема для СУБД MySQL/MariaDB или postgreSQL. В нашем случае, нам нужен MySQL.
Для применения схемы переходим в каталог:
cd /usr/share/doc/zabbix-server-mysql/
Распаковываем архив с дампом базы:
gunzip create.sql.gz
Восстанавливаем базу их дампа:
mysql -v -u root -p zabbix < create.sql
* после ввода команды система запросит пароль. Необходимо ввести пароль, который мы задали после установки mariadb.
Настройка zabbix
Открываем конфигурационный файл zabbix:
nano /etc/zabbix/zabbix_server.conf
Добавляем строку:
DBPassword=zabbixpassword
* мы настраиваем портал на подключение к базе с паролем zabbixpassword, который задали при создании базы для zabbix.
И проверяем следующие строки:
...

DBName=zabbix

...

DBUser=zabbix

...
* имя базы и пользователя должны быть zabbix (как мы и создали в mariadb).
Создаем каталог для инклудов конфигурационных файлов (по какой-то причине, он может быть не создан при установке):
mkdir /etc/zabbix/zabbix_server.conf.d
Также создаем каталог для логов и задаем владельца:
mkdir /var/log/zabbix-server

chown zabbix:zabbix /var/log/zabbix-server
Запуск zabbix-server
Разрешаем автозапуск сервера мониторинга:
systemctl enable zabbix-server
После запускаем сам сервер zabbix:
systemctl start zabbix-server
Настройка nginx
При установке zabbix-web файлы портала копируются в каталог /usr/share/zabbix. Наш веб-сервер работает с каталогом /var/www/html.
Меняем это — открываем конфигурационный файл nginx:
vi /etc/nginx/sites-enabled/default
nano /etc/nginx/sites-enabled/default
Редактируем параметры root и set $root_path:
...

root /usr/share/zabbix;

...

set $root_path /usr/share/zabbix;

...
Перезапускаем nginx:
systemctl restart nginx
Установка портала для управления Zabbix
Открываем браузер и переходим по адресу http://<IP-адрес сервера>/ — откроется страница установки Zabbix Web. Кликаем по ссылке Next Step:

В следующем окне внимательно смотрим на результаты проверки нашего веб-сервера — справа мы должны увидеть все OK. Если это не так, проверяем настройки и исправляем предупреждения и ошибки, после перезапускаем страницу F5 для повторной проверки настроек.
Когда все результаты будут OK, кликаем по Next Step:
В следующем окне мы оставляем настройки подключения к базе как есть — дополнительно прописываем пароль, который задали при создании пользователя zabbix. После нажимаем Next Step:

* в нашем случае, пароль был zabbixpassword;
В следующем окне оставляем все как есть:
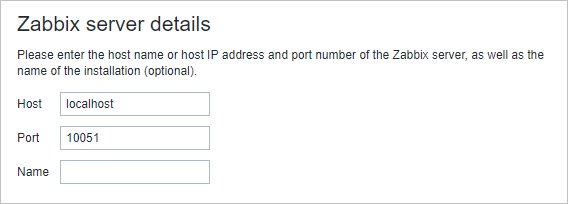
… и нажимаем Next Step.
В последнем окне мы проверяем настройки и кликаем Next Step.
Установка завершена — нажимаем Finish:

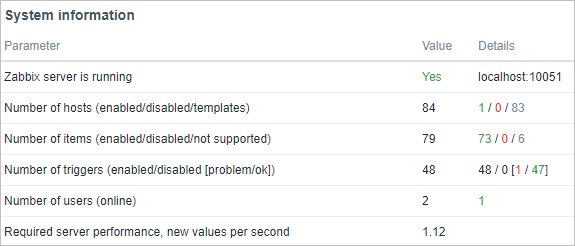
В открывшемся окне вводим логин Admin и пароль zabbix (по умолчанию) — откроется окно со сводной информацией по мониторингу:
Zabbix Agent
В качестве примера установим и настроим zabbix agent на наш сервер. Так как мы уже устанавливали репозиторий, установка агента выполняется командой:
apt-get install zabbix-agent
Откроем конфигурационный файл:
nano /etc/zabbix/zabbix_agentd.conf
Отредактируем следующую опцию:
Server=localhost
* в данном примере мы указываем агенту сервер Zabbix — мы может указать его имя или IP-адрес.
Разрешаем автозапуск агента и запускаем его:
systemctl enable zabbix-agent

systemctl start zabbix-agent
Источник: https://www.dmosk.ru/miniinstruktions.php?mini=zabbix-server-ubuntu
2021-03-07T22:10:22
Software
Как включить тайный режим Kali Linux
Тестеры на проникновение и хакеры Black Hat превыше всего ценят конфиденциальность и анонимность. Такой дистрибутив, как Kali Linux, инструмент, который предпочитают исследователи безопасности и тестеры на проникновение, может не предоставлять их постоянно, особенно в общественных местах, где запуск кода и открытие нескольких терминалов могут легко привлечь к себе ненужное внимание.
Offensive Security учел это и включил в Kali Linux 2019.4 режим, известный как режим под прикрытием.
Режим под прикрытием в Kali Linux — это набор скриптов, которые позволяют имитировать среду Windows 10 в Kali Linux. Он преобразует весь интерфейс в эквивалент Windows 10, ограничивая внимание, которое вы могли бы привлечь, если бы вы запускали XFCE с различными запущенными терминалами и драконом Kali в фоновом режиме.
Чтобы включить и использовать скрытый режим Kali Linux, вам потребуется Kali Linux 2019.4 или новее.
Обновление до версии 2019.4 или более поздней
Начните с обновления вашего дистрибутива с помощью команд:
sudo apt update

sudo apt -y full-upgrade
Вам также может потребоваться использовать среду рабочего стола XFCE.
Включение режима Kali под прикрытием
Чтобы запустить скрытый режим, откройте терминал и введите команду:
kali-undercover
Если вы предпочитаете использовать графический интерфейс, запустите меню приложения и найдите Kali Linux Undercover.
Возврат в нормальный режим
Чтобы вернуться в режим по умолчанию, введите команду:
kali-undercover
2021-03-07T22:05:07
Kali Linux
20 команд netstat для управления сетью Linux и Windows
20 команд netstat для управления сетью Linux и Windows
Этот инструмент очень важен и полезен для сетевых администраторов Linux/Windows для мониторинга и устранения неполадок, связанных с сетью, и определения производительности сетевого трафика. В этой статье показано использование команды netstat с примерами, которые могут быть полезны при ежедневной работе.
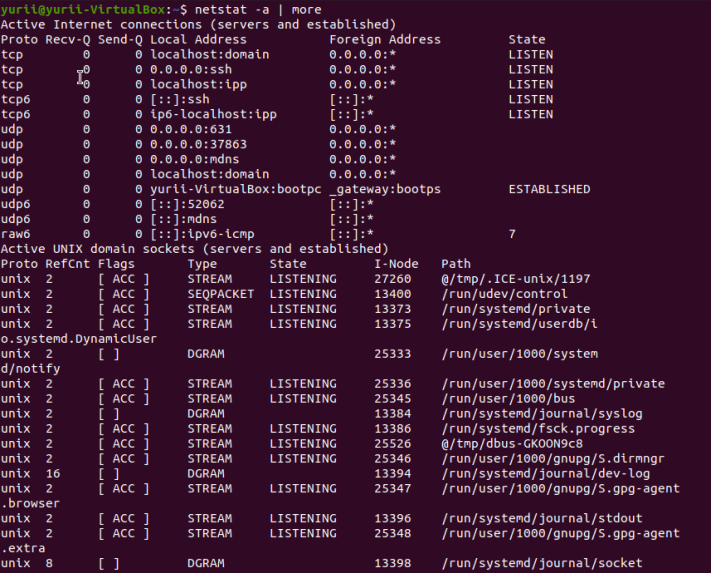
1. Перечисление всех портов для соединений TCP и UDP
Список всех портов (как TCP, так и UDP) с использованием опции netstat -a.
# netstat -a | more
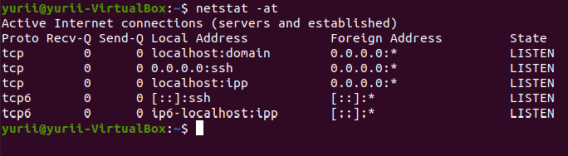
2. Перечисление соединений TCP-портов
Список соединений TCP (Transmission Control Protocol) с использованием опции netstat -at.
# netstat -at
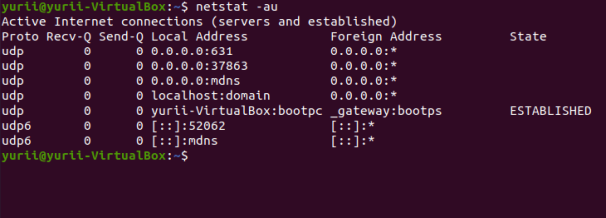
3. Спикок соединений портов UDP
Список соединений UDP (User Datagram Protocol) с использованием опции netstat -au.
# netstat -au
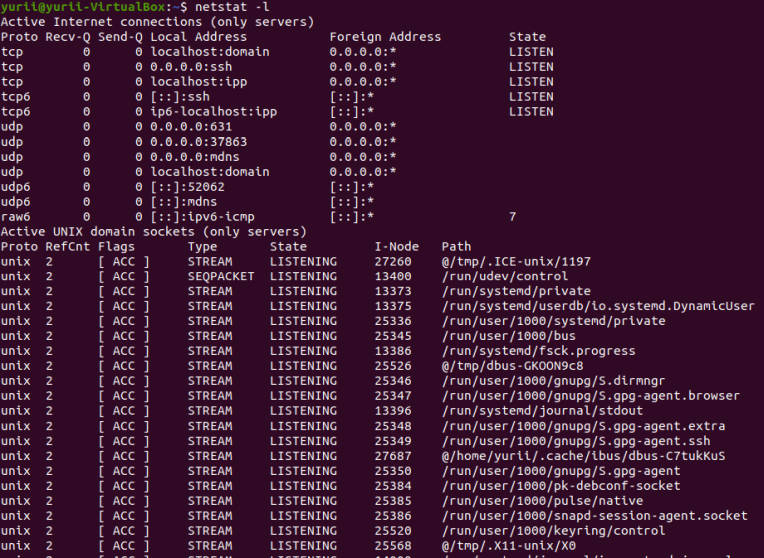
4. Список всех открытых входящих портов
Список всех открытых входящих портов с использованием опции netstat -l.
# netstat -l
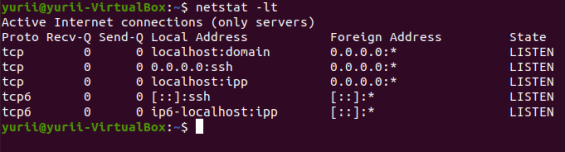
5. Список всех активных входящих портов TCP
Список всех активных TCP-портов прослушивания с использованием опции netstat -lt.
# netstat -lt
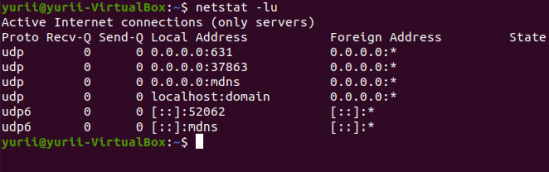
6. Список всех активных входящих портов UDP
Список всех активных входящих портов UDP с использованием опции netstat -lu.
# netstat -lu
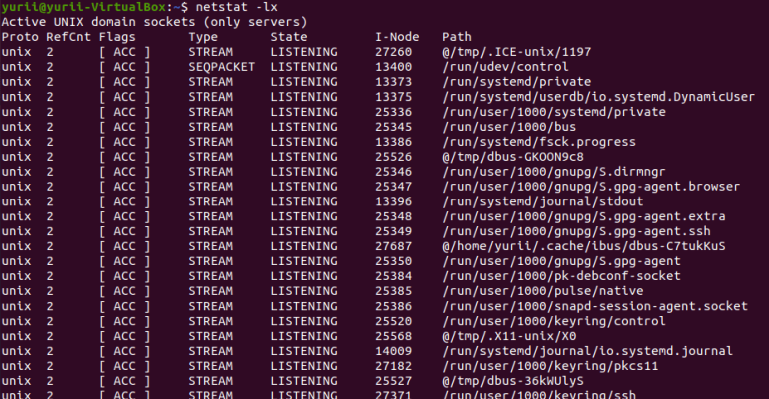
7. Список всех активных входящих сокетов UNIX
Список всех активных входящих сокетов UNIX с помощью опции netstat -lx.
# netstat -lx
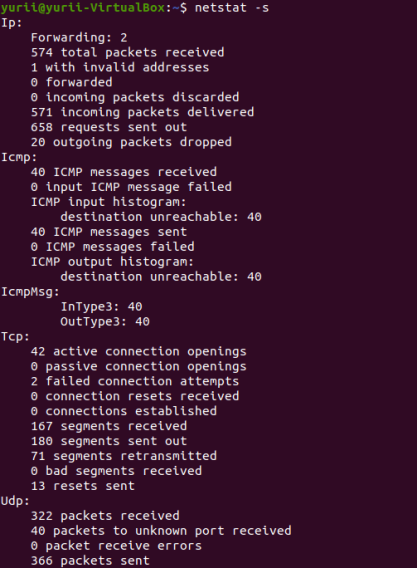
8. Отображение статистики по всем протоколам
По умолчанию для протоколов TCP, UDP, ICMP и IP показаны статистические данные. Параметр -s может использоваться для указания набора протоколов.
# netstat -s
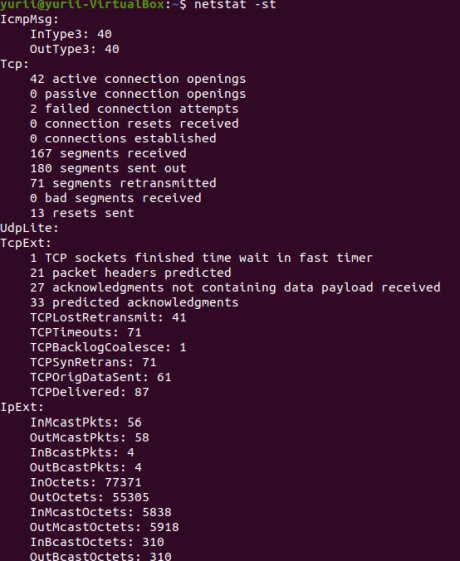
9. Отображение статистики по протоколу TCP
Отображение статистики TCP-протокола с использованием опции netstat -st.
# netstat -st
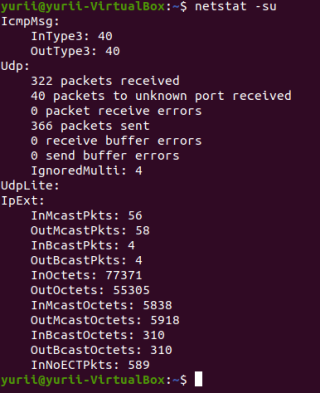
10. Отображение статистики по протоколу UDP
Отображение статистики UDP-протокола с использованием опции netstat -su.
# netstat -su
11. Отображение имени службы с PID
Ниже приведен пример отображения имени службы с её номером PID. Для этого необходимо использовать опцию netstat -tp, которая отобразит «PID / Program Name».
# netstat -tp
12. Отображение режима Promiscuous
Promiscuous mode или promisc mode — так называемый «неразборчивый» режим, в котором сетевая плата позволяет принимать все пакеты независимо от того, кому они адресованы.
Отображая режим Promiscuous с переключателем -ac, netstat выводит выбранную информацию на экран и обновляет её каждые пять секунд. По умолчанию экран обновляется каждую секунду.
# netstat -ac 5 | grep tcp
13. Отображение маршрутизации IP-адреса ядра
Отображение таблицы IP-маршрутизации ядра с помощью команды netstat.
# netstat -r
14. Отображение транзакций сетевого интерфейса
Отображение транзакций пакетов сетевого интерфейса, включая как отправляемые, так и принимаемые пакеты с размером MTU.
# netstat -i
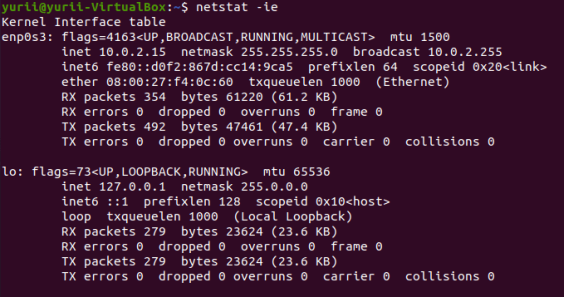
15. Отображение таблицы интерфейса ядра
Команда отображает таблицу интерфейса ядра, аналогично команде ifconfig.
# netstat -ie
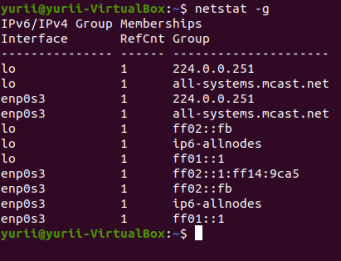
16. Отображение информации IPv4 и IPv6
Отображает информацию о членстве в многоадресной группе для IPv4 и IPv6.
# netstat -g
17. Циклический вывод информации Netstat
Чтобы получать информацию netstat каждые несколько секунд, используйте команду приведенную ниже. Она будет непрерывно выводить информацию, через каждые несколько секунд.
# netstat -c
18. Поиск не поддерживаемых адресов
Команда выводит список не настроенных семейств адресов с некоторой полезной информацией.
# netstat --verbose
19. Поиск программ прослушивания
Узнайте, сколько программ прослушивает работу на портов.
# netstat -ap | grep http
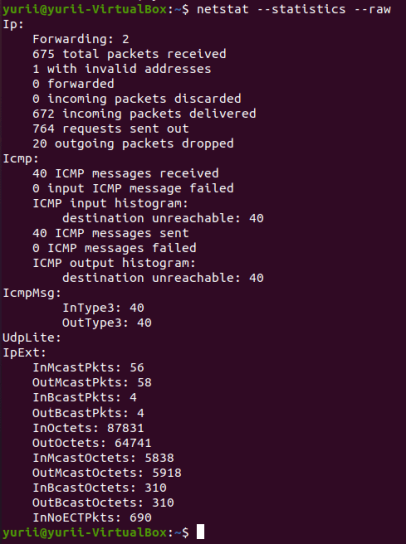
20. Отображение статистики сети RAW
Команда отображает статистику сети RAW со всей сопутствующей полезной информацией.
# netstat --statistics --raw
Источник: https://blog.sedicomm.com/2017/07/11/20-komand-netstat-dlya-upravleniya-setyu-linux-i-windows/
2021-03-07T11:50:18
Утилиты командной строки
Grep поиск текста в файлах Linux
Grep поиск текста в файлах Linux
Иногда может понадобится найти файл, в котором содержится определённая строка или найти строку в файле, где есть нужное слово. В Linux всё это делается с помощью одной очень простой, но в то же время мощной утилиты grep. С её помощью можно искать не только строки в файлах, но и фильтровать вывод команд, и много чего ещё.
В этой инструкции мы рассмотрим, как выполняется поиск текста в файлах Linux, подробно разберём возможные опции grep, а также приведём несколько примеров работы с этой утилитой.
Что такое grep?
Команда grep (расшифровывается как global regular expression print) — одна из самых востребованных команд в терминале Linux, которая входит в состав проекта GNU. Секрет популярности — её мощь, она даёт возможность пользователям сортировать и фильтровать текст на основе сложных правил.
Утилита grep решаем множество задач, в основном она используется для поиска строк, соответствующих строке в тексте или содержимому файлов. Также она может находить по шаблону или регулярным выражениям. Команда в считанные секунды найдёт файл в с нужной строчкой, текст в файле или отфильтрует из вывода только пару нужных строк. А теперь давайте рассмотрим, как ей пользоваться.
Синтаксис grep
Синтаксис команды выглядит следующим образом:
$ grep [опции] шаблон [имя файла…]
Или:
$ команда | grep [опции] шаблон
- Опции — это дополнительные параметры, с помощью которых указываются различные настройки поиска и вывода, например количество строк или режим инверсии.
- Шаблон — это любая строка или регулярное выражение, по которому будет вестись поиск
- Файл и команда — это то место, где будет вестись поиск. Как вы увидите дальше, grep позволяет искать в нескольких файлах и даже в каталоге, используя рекурсивный режим.
Возможность фильтровать стандартный вывод пригодится,например, когда нужно выбрать только ошибки из логов или найти PID процесса в многочисленном отчёте утилиты ps.
Опции
Давайте рассмотрим самые основные опции утилиты, которые помогут более эффективно выполнять поиск текста в файлах grep:
- -b — показывать номер блока перед строкой;
- -c — подсчитать количество вхождений шаблона;
- -h — не выводить имя файла в результатах поиска внутри файлов Linux;
- -i — не учитывать регистр;
- — l — отобразить только имена файлов, в которых найден шаблон;
- -n — показывать номер строки в файле;
- -s — не показывать сообщения об ошибках;
- -v — инвертировать поиск, выдавать все строки кроме тех, что содержат шаблон;
- -w — искать шаблон как слово, окружённое пробелами;
- -e — использовать регулярные выражения при поиске;
- -An — показать вхождение и n строк до него;
- -Bn — показать вхождение и n строк после него;
- -Cn — показать n строк до и после вхождения;
Все самые основные опции рассмотрели и даже больше, теперь перейдём к примерам работы команды grep Linux.
Примеры использования
С теорией покончено, теперь перейдём к практике. Рассмотрим несколько основных примеров поиска внутри файлов Linux с помощью grep, которые могут вам понадобиться в повседневной жизни.
Поиск текста в файлах
В первом примере мы будем искать пользователя User в файле паролей Linux. Чтобы выполнить поиск текста grep в файле /etc/passwd введите следующую команду:
grep User /etc/passwd
В результате вы получите что-то вроде этого, если, конечно, существует такой пользователь:
User:x:1000:1000:User,,,:/home/User:/bin/bash
А теперь не будем учитывать регистр во время поиска. Тогда комбинации ABC, abc и Abc с точки зрения программы будут одинаковы:
grep -i "user" /etc/passwd
Вывести несколько строк
Например, мы хотим выбрать все ошибки из лог-файла, но знаем, что в следующей строчке после ошибки может содержаться полезная информация, тогда с помощью grep отобразим несколько строк. Ошибки будем искать в Xorg.log по шаблону «EE»:
grep -A4 "EE" /var/log/xorg.0.log
Выведет строку с вхождением и 4 строчки после неё:
grep -B4 "EE" /var/log/xorg.0.log
Выведет целевую строку и 4 строчки до неё:
grep -C2 "EE" /var/log/xorg.0.log
Выведет по две строки с верху и снизу от вхождения.
Регулярные выражения в grep
Регулярные выражения grep — очень мощный инструмент в разы расширяющий возможности поиска текста в файлах. Для активации этого режима используйте опцию -e. Рассмотрим несколько примеров:
Поиск вхождения в начале строки с помощью спецсимвола «^», например, выведем все сообщения за ноябрь:
grep "^Nov 10" messages.1

Nov 10 01:12:55 gs123 ntpd[2241]: time reset +0.177479 s
Nov 10 01:17:17 gs123 ntpd[2241]: synchronized to LOCAL(0), stratum 10
Поиск в конце строки — спецсимвол «$»:
grep "terminating.$" messages

Jul 12 17:01:09 cloneme kernel: Kernel log daemon terminating.
Oct 28 06:29:54 cloneme kernel: Kernel log daemon terminating.
Найдём все строки, которые содержат цифры:
grep "[0-9]" /var/log/Xorg.0.log
Вообще, регулярные выражения grep — это очень обширная тема, в этой статье я лишь показал несколько примеров. Как вы увидели, поиск текста в файлах grep становиться ещё эффективнее. Но на полное объяснение этой темы нужна целая статья, поэтому пока пропустим её и пойдем дальше.
Рекурсивное использование grep
Если вам нужно провести поиск текста в нескольких файлах, размещённых в одном каталоге или подкаталогах, например в файлах конфигурации Apache — /etc/apache2/, используйте рекурсивный поиск. Для включения рекурсивного поиска в grep есть опция -r. Следующая команда займётся поиском текста в файлах Linux во всех подкаталогах /etc/apache2 на предмет вхождения строки mydomain.com:
grep -r "mydomain.com" /etc/apache2/
В выводе вы получите:
grep -r "zendsite" /etc/apache2/

/etc/apache2/vhosts.d/zendsite_vhost.conf: ServerName zendsite.localhost
/etc/apache2/vhosts.d/zendsite_vhost.conf: DocumentRoot /var/www/localhost/htdocs/zendsite
/etc/apache2/vhosts.d/zendsite_vhost.conf: <Directory /var/www/localhost/htdocs/zendsite>
Здесь перед найденной строкой указано имя файла, в котором она была найдена. Вывод имени файла легко отключить с помощью опции -h:
grep -h -r "zendsite" /etc/apache2/

ServerName zendsite.localhost
DocumentRoot /var/www/localhost/htdocs/zendsite
<Directory /var/www/localhost/htdocs/zendsite>
Поиск слов в grep
Когда вы ищете строку abc, grep будет выводить также kbabc, abc123, aafrabc32 и тому подобные комбинации. Вы можете заставить утилиту искать по содержимому файлов в Linux только те строки, которые выключают искомые слова с помощью опции -w:
grep -w "abc" имя_файла
Поиск двух слов
Можно искать по содержимому файла не одно слово, а два сразу:
egrep -w 'word1|word2' /path/to/file
Количество вхождений строки
Утилита grep может сообщить, сколько раз определённая строка была найдена в каждом файле. Для этого используется опция -c (счетчик):
grep -c 'word' /path/to/file
C помощью опции -n можно выводить номер строки, в которой найдено вхождение, например:
grep -n 'root' /etc/passwd
Получим:
1:root:x:0:0:root:/root:/bin/bash
Инвертированный поиск в grep
Команда grep Linux может быть использована для поиска строк в файле, которые не содержат указанное слово. Например, вывести только те строки, которые не содержат слово пар:
grep -v пар /path/to/file
Вывод имени файла
Вы можете указать grep выводить только имя файла, в котором было найдено заданное слово с помощью опции -l. Например, следующая команда выведет все имена файлов, при поиске по содержимому которых было обнаружено вхождение primary:
grep -l 'primary' *.c
Цветной вывод в grep
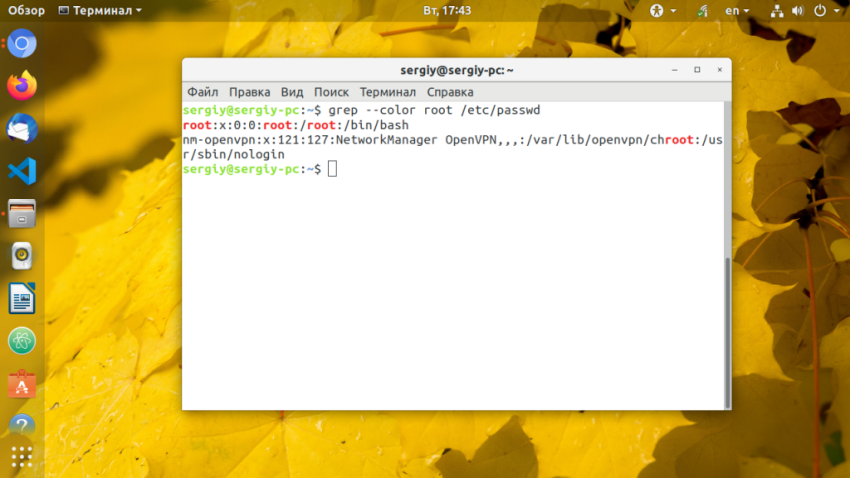
Также вы можете заставить программу выделять другим цветом вхождения в выводе:
grep --color root /etc/passwd
Получится:
Выводы
Вот и всё. Мы рассмотрели использование команды grep для поиска и фильтрации вывода команд в операционной системе Linux. При правильном применении эта утилита станет мощным инструментом в ваших руках. Если у вас остались вопросы, пишите в комментариях!
Источник: https://losst.ru/gerp-poisk-vnutri-fajlov-v-linux
2021-03-07T11:28:48
Утилиты командной строки