Рассмотрим ситуацию, что настройки роутера сбросились и как это исправить.
Такое могло случиться, если, например, вы хотели что-то подключить к роутеру, какой-то кабель и случайно нажали на кнопку «Reset», которая находится на самом роутере. Читать
Рассмотрим ситуацию, что настройки роутера сбросились и как это исправить.
Такое могло случиться, если, например, вы хотели что-то подключить к роутеру, какой-то кабель и случайно нажали на кнопку «Reset», которая находится на самом роутере. Читать
Как время летит. Восемь лет назад я написал сообщение в блоге об эксперименте с изображениями WebP на веб-сайте End Point, чтобы описать и продемонстрировать, как формат изображения WebP может хранить изображение эквивалентного качества в гораздо меньшем размере файла, чем старые форматы JPEG, PNG и GIF.
Основным недостатком в то время было то, что среди основных браузеров только Chrome и Opera поддерживали WebP, а тогда Chrome был гораздо менее популярен, чем сейчас.
Поскольку iOS 14 и macOS 11 (Big Sur) от Apple стали доступны в конце 2020 года, формат изображений WebP теперь работает во всех поддерживаемых в настоящее время основных операционных системах и браузерах: Linux, Windows и macOS, работающих под управлением Chromium, Chrome, Brave, Edge, Opera, Firefox, и Safari.
Прошло всего около 10 лет! 😁
Таким образом, для вас, кто размещает веб-сайты, все посетители вашего сайта могут видеть изображения и анимацию WebP, за исключением тех, кто исчезает с помощью Internet Explorer (теперь его поддержка Microsoft давно закончилась и его использование опасно), и люди (или их организации), которые преднамеренно не разрешать обновлять свои старые браузеры и операционные системы.
Это означает, что вы можете продолжать использовать изображения JPEG, PNG и/или GIF в местах, имеющих решающее значение для отображения основных функций вашего сайта, чтобы люди могли понять основные вещи, которые ваш сайт пытается сообщить.
Но для любых изображений, которые менее важны и в первую очередь делают их более красивыми, или когда вы не возражаете предложить пользователям старых браузеров обновиться, чтобы увидеть их, WebP теперь может быть вашим форматом изображения по умолчанию.
Мобильные телефоны и цифровые камеры обычно сохраняют изображения в формате JPEG, HEIF или необработанные (несжатые) изображения. Некоторые коллекции стоковых фотографий можно загрузить через WebP, но многие по-прежнему используют JPEG.
Таким образом, во многих случаях вы не будете начинать с изображения WebP, и вы будете конвертировать какое-то другое изображение в WebP, вероятно, после обрезки, масштабирования и других настроек.
GIMP (программа обработки изображений GNU) поддерживает изображения WebP примерно с 2017 года, а Adobe Photoshop изначально не поддерживает, но может использовать бесплатный плагин WebPShop.
Самый старый способ преобразования изображений в WebP, который до сих пор очень полезен для пакетной обработки или тонкой настройки, — это конвертер WebP от Google «cwebp».
С мощными предложениями «cwebp» связаны некоторые сложности, но в основном они безвредны.
Запустите эту команду, чтобы увидеть множество вариантов:
cwebp -longhelp
Или прочтите то же самое в его онлайн-документации.
Там, среди прочего, вы увидите параметр -z, который активирует предустановленные функции для кодирования без потерь, с целочисленным уровнем, выбранным от 0 до 9, где 0 — самый быстрый, но сжимает меньше, а 9 — самый медленный, но сжимает лучше. Используйте это для замены файлов PNG, если вы вообще не хотите ухудшения качества изображения.
В документации также показаны полезные функции -presetи -hintпараметры сжатия с потерями, аналогичные тому, что делает JPEG, но лучше:
-preset <string> ....... preset setting, one of:

                          default, photo, picture,

                          drawing, icon, text


-hint <string> ......... specify image characteristics hint,

                         one of: photo, picture or graph
Значение некоторых из этих терминов, особенно «фото» и «изображение», было для меня неясным и не определялось нигде в документации, которую я мог видеть.
Чтобы выяснить это, мне пришлось быстро заглянуть в исходный код, и там есть комментарии, немного объясняющие вариант использования каждой опции:
Комментарии к варианту -preset:
WEBP_PRESET_PICTURE,  // digital picture, like portrait, inner shot

WEBP_PRESET_PHOTO,    // outdoor photograph, with natural lighting

WEBP_PRESET_DRAWING,  // hand or line drawing, with high-contrast details

WEBP_PRESET_ICON,     // small-sized colorful images

WEBP_PRESET_TEXT      // text-like
И комментарии к варианту -hint:
WEBP_HINT_PICTURE,    // digital picture, like portrait, inner shot

WEBP_HINT_PHOTO,      // outdoor photograph, with natural lighting

WEBP_HINT_GRAPH,      // Discrete tone image (graph, map-tile etc).
Короче говоря, «cwebp» считает «изображение» в помещении и крупным планом, а «фото» — на улице и, скорее всего, с более дальним фокусом. Это хорошо знать.
Имея это в виду, я могу преобразовать стопку скриншотов, которые были собраны на моем компьютере, чтобы обращаться к ним позже. Один из видов скриншотов, которые я иногда делаю, — это видеовстречи, на которых люди в основном смотрят в помещении. Для них я буду использовать предустановку «изображение».
Простой bashскрипт хорошо работает для обработки множества изображений подряд:
for infile in Screenshot*.png

do

    echo $infile

    base=$(basename "$infile" .png)

    cwebp -preset picture -v "$infile" -o "$base".webp

done
Если у вас есть много изображений для преобразования в WebP и вы хотите сделать несколько одновременно, чтобы сделать это быстрее, вы можете использовать GNU parallel.
Мои скриншоты при преобразовании из PNG в WebP постоянно занимают около 3% исходного пространства, в 33–35 раз меньше! И качество примерно такое же. Удивительно.
Другие новые форматы изображений также находились в разработке в течение многих лет, преследуя некоторые из тех же целей. Должны ли мы пропустить WebP и использовать вместо этого один из них?
Подмножество HEIC (High-Efficiency Image Container) стандарта HEIF (High Efficiency Image File Format) использует высокоэффективное кодирование видео (HEVC, H.265) для хранения изображений с суффиксом .heic.
По сравнению с JPEG, HEIC предлагает приятные преимущества меньшего размера файла при том же уровне качества (примерно половина размера эквивалентного JPEG) и поддержку анимации (для замены GIF).
С другой стороны, HEIC обременен патентами, которые ограничивают его использование в крупных коммерческих проектах даже на устройствах, лицензированных для потребительского использования. Он также медленнее кодирует/декодирует. И, что касается архивариусов, HEIC показывает серьезное визуальное повреждение всего изображения, если часть файла повреждена. Напротив, в поврежденных файлах JPEG визуальное повреждение обычно локализовано в отдельных небольших квадратных областях, а не во всем изображении.
HEIC используется в операционных системах Apple с момента выпуска в 2017 году iPhone 7, iOS 11 и macOS 10.13 (High Sierra). Позднее поддержка была добавлена в Windows 10, Android 9 и Ubuntu 20.04.
На момент написания этой статьи ни один из основных браузеров изначально не поддерживал HEIC , даже собственный Safari от Apple.
Так что на данный момент HEIC в основном используется Apple для более эффективного хранения фотографий на своих мобильных устройствах.
AVIF (формат файла изображения AV1) конкурирует с HEIC и, что сбивает с толку, использует тот же формат файла контейнера HEIF, что и HEIC. Эта путаница на практике уменьшается за счет использования отдельного расширения файла..avif.
AVIF поддерживается в текущих версиях Chrome, Firefox и Opera. Поддержка была добавлена в WebKit в 2021 году, но до сих пор не появилась в Safari. Он также работает в новых версиях VLC, GIMP, Windows, Android и т. д.
У Netflix есть очень подробный пост в блоге , в котором сравниваются AVIF и JPEG и демонстрируются многочисленные преимущества AVIF.
Полусовместимый преемник JPEG уже давно находится в разработке, и JPEG XL, похоже, в конечном итоге займет эту роль.
Принимая во внимание, что другие новые форматы изображений, упомянутые выше, обычно теряют некоторое качество при повторном сжатии JPEG и других изображений, которые уже были сжаты с потерями, согласно Объединенной группе экспертов по фотографии (JPEG) :
Существующие файлы JPEG можно без потерь перекодировать в JPEG XL, значительно уменьшив их размер.
Сообщалось, что JPEG XL, как ожидается, станет доступен в своей окончательной стандартной форме в 2022 году, а поддержка уже доступна в предварительной форме в некоторых программах (см . статью об JPEG XL в Википедии ).
Это, конечно, означает, что на данный момент ни один из основных браузеров изначально не поддерживает JPEG XL.
Таким образом, все другие новые параметры еще не могут использоваться для обычных веб-изображений. WebP в настоящее время является очевидным выбором, хотите ли вы заменить фотографии JPEG с потерями, заменить без потерь изображения PNG или заменить анимацию GIF.
Наши разработчики настроили на сервере автоматическое преобразование высококачественных PNG-оригиналов в WebP или JPEG на стороне приложения на лету, при этом размер изображения зависит от размера области просмотра браузера. И мы работали с Cloudinary, Cloudflare и другими CDN, чтобы использовать их услуги преобразования изображений. Мы также готовы помочь с вашими проектами.
Граф, не имеющий направлений, называется неориентированным графом. Каждый граф должен иметь путь от одного узла к другому узлу. Остовное дерево также является неориентированным связным графом, в котором присутствуют все узлы графа с минимальным количеством ребер. Если остовное дерево не имеет всех узлов графа, то мы не можем сказать, что это остовное дерево. Суммарные веса остовного дерева будут меньше исходного веса графа, так как мы соединили его через ребра минимального веса. Покрывающее дерево также не имеет цикла. Любой граф имеет более одного остовного дерева, но только одно из них будет уникальным. Мы называем это минимальным остовным деревом, поскольку пытаемся создать полный граф со всеми узлами, сохраняя при этом низкий вес.
Мы можем нарисовать остовное дерево с помощью следующих двух методов:
В этой статье мы собираемся обсудить алгоритм Прима. Алгоритм Крускала будет рассмотрен в следующей статье.
Алгоритм Прима используется для нахождения минимального остовного дерева графа. Алгоритм примитива начинается с любого узла, а затем добавляет любой соседний узел с минимальным весом, и этот процесс продолжается до тех пор, пока не будут посещены все узлы в графах. При создании минимального остовного дерева графа мы также не должны создавать циклы, потому что циклов не должно быть в минимальном остовном дереве.
Алгоритм прима использует жадный подход для минимального остовного дерева. Мы должны выбрать любую вершину графа, а затем выбрать следующую вершину смежности, чей вес меньше, и мы продолжаем этот процесс до тех пор, пока не соединим все узлы графа.
Ниже приведен пример поиска минимального остовного дерева с использованием алгоритма Прима.
1. Выбираем любой случайный узел из графа G и добавляем его в MST (минимальное остовное дерево). Мы выбираем здесь узел 0.
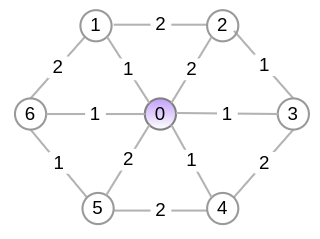
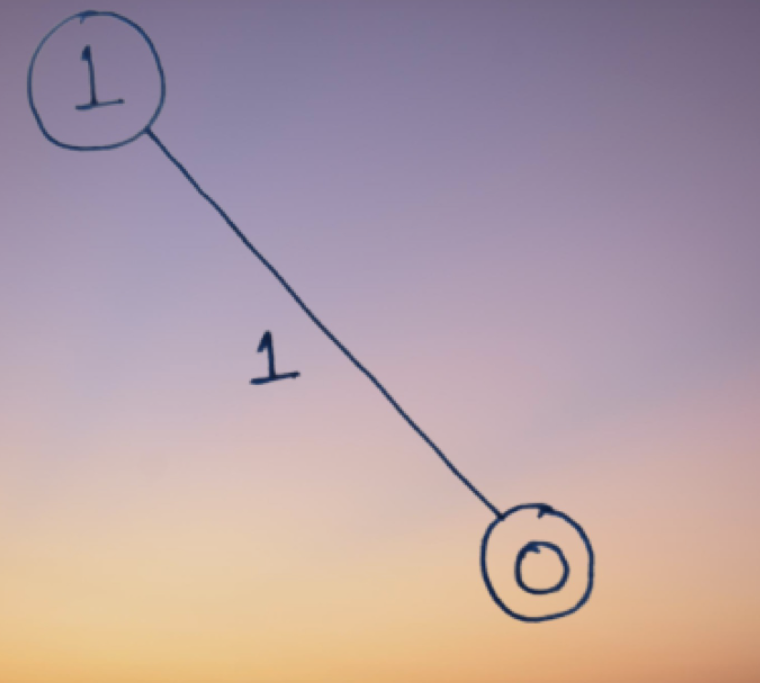
2. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
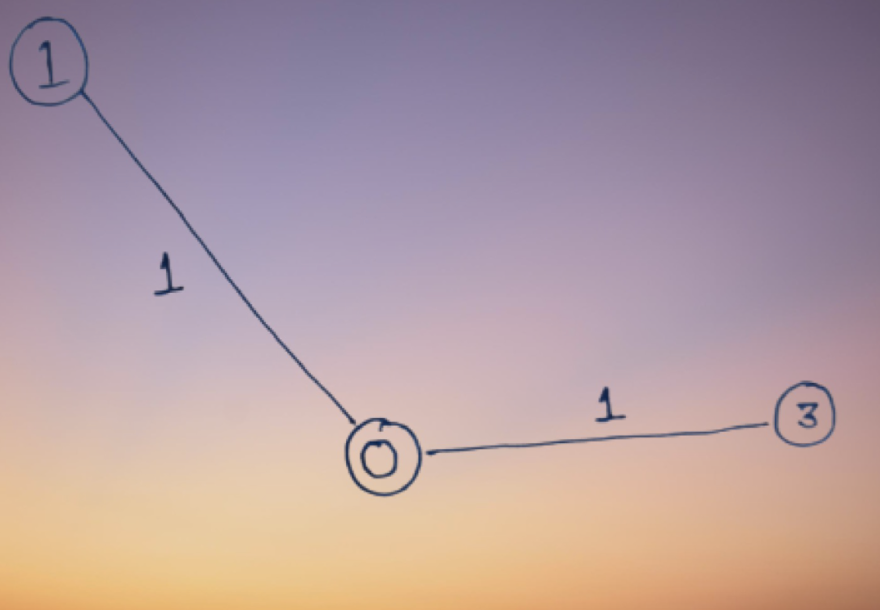
3. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0 или 1), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
4. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1 или 3), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
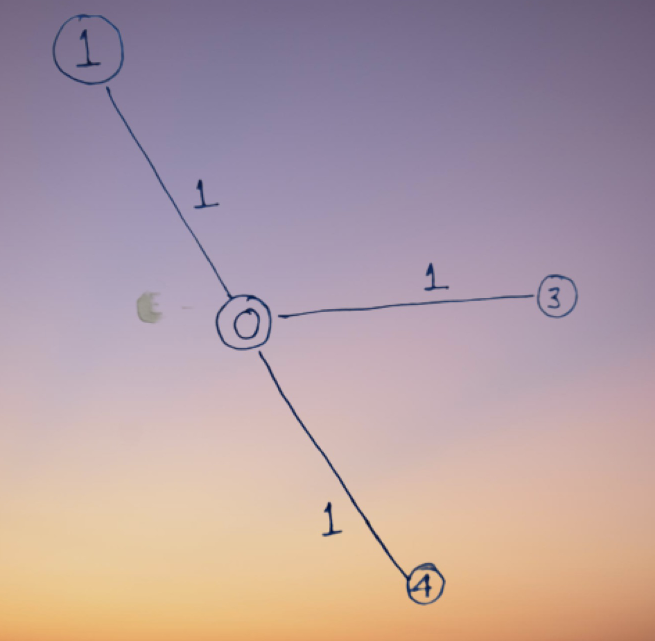
5. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3 или 4), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
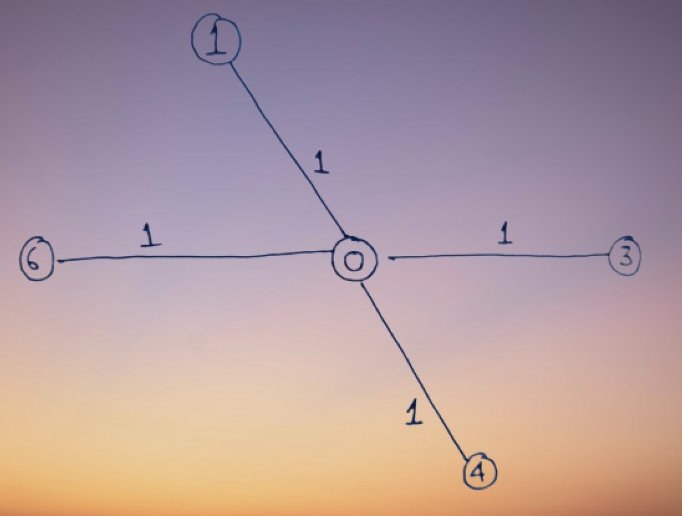
6. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3, 4 или 6), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
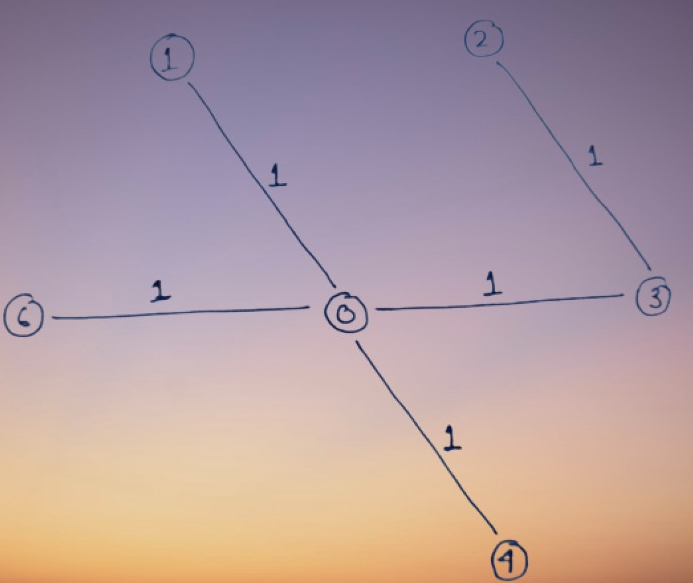
7. Теперь мы выбираем то ребро, которое является смежным с исходным узлом (0, 1, 3, 4, 6 или 2), но с наименьшим весом, а затем добавляем этот узел с наименьшим весом в минимальное остовное дерево.
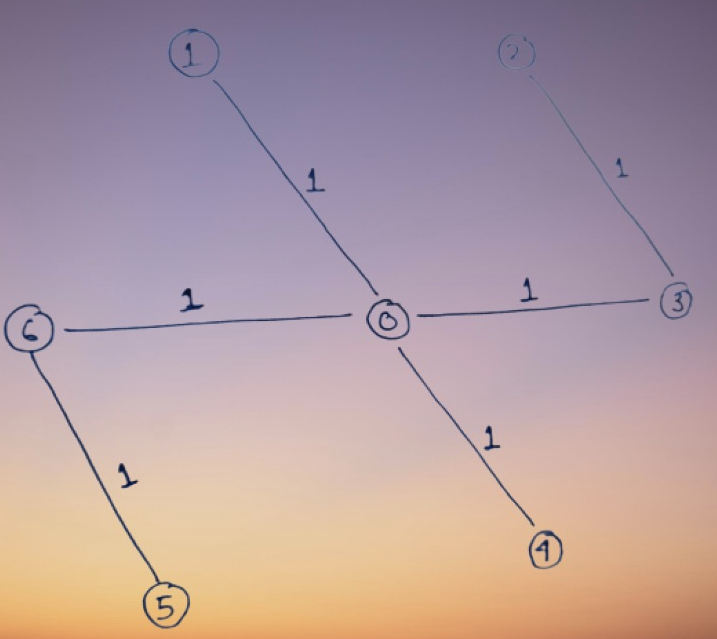
Выше наш окончательный MST (минимальное остовное дерево), а общая стоимость равна 6.
#include<iostream>


#include<vector>


#include<queue>


#include<algorithm>


#include<cstring>


typedef std :: pair<int,int> SII;


typedef std :: vector<SII> SSII;


int PrimsMST (int sourceNode, std :: vector<SSII> & graph){


    // В этой очереди будут храниться сведения о каждом узле

    // вместе с их весовой ценностью.


    std :: priority_queue<SII, std :: vector<SII>, std :: greater<SII>> k;


    k.push(std :: make_pair(0, sourceNode));


    bool nodesAdded[graph.size()];


    memset(nodesAdded, false, sizeof(bool)*graph.size());


    int mst_tree_cost = 0;


    while (!k.empty()) {


        // We are selecting here the node which has minimum cost


        SII itemNode;


        itemNode = k.top();


        k.pop();


        int Node = itemNode.second;


        int Cost = itemNode.first;


        // Здесь мы проверяем, не был ли какой-либо узел добавлен в MST,


        // затем добавляем этот узел.


        if (!nodesAdded[Node]) {


            mst_tree_cost += Cost;


            nodesAdded[Node] = true;


            // Выполните итерацию по узлам negibour, которые недавно были удалены


            // из очереди приоритетов.


            // и добавлен в MST, который еще не добавлен


            for (auto & pair_node_cost : graph[Node]) {


                int adjency_node = pair_node_cost.second;


                if (nodesAdded[adjency_node] == false) {


                    k.push(pair_node_cost);


                }


            }


        }


    }


    return mst_tree_cost;


}


    int main(){


    // Подробная информация о графике со стоимостью и узлом смежности.


    SSII fromNode_0_in_graph_1  = { {1,1}, {2,2}, {1,3},


    {1,4}, {2,5}, {1,6} };


    SSII fromNode_1_in_graph_1   = { {1,0}, {2,2}, {2,6} };


    SSII fromNode_2_in_graph_1   = { {2,0}, {2,1}, {1,3} };


    SSII fromNode_3_in_graph_1 = { {1,0}, {1,2}, {2,4} };


    SSII fromNode_4_in_graph_1  = { {1,0}, {2,3}, {2,5} };


    SSII fromNode_5_in_graph_1  = { {2,0}, {2,4}, {1,6} };


    SSII fromNode_6_in_graph_1   = { {1,0}, {2,2}, {1,5} };


    int num_of_nodes = 7; // Total Nodes (0 to 6)


    std :: vector<SSII> primsgraph;


    primsgraph.resize(num_of_nodes);


    primsgraph[0] = fromNode_0_in_graph_1;


    primsgraph[1] = fromNode_1_in_graph_1;


    primsgraph[2] = fromNode_2_in_graph_1;


    primsgraph[3] = fromNode_3_in_graph_1;


    primsgraph[4] = fromNode_4_in_graph_1;


    primsgraph[5] = fromNode_5_in_graph_1;


    primsgraph[6] = fromNode_6_in_graph_1;


    // Как мы уже знаем, мы должны выбрать исходную вершину,


    // поэтому мы начинаем с узла вершины 0.


    std :: cout << "Общая стоимость минимального связующего дерева после алгоритма Прима : "


                "" << PrimsMST(0, primsgraph) << std :: endl;


    return 0;


}
Общая стоимость минимального связующего дерева после алгоритма Прима : 6


Process finished with exit code 0
Мы изучили минимальное остовное дерево Prim, которое большинство людей предпочитает в первую очередь, когда им нужно найти граф MST из графа. Алгоритм Prim прост для понимания и реализации в реальном приложении. Алгоритм Prim очень полезен в реальных приложениях, например, при соединении железнодорожных путей с целыми городами. Так что это всего лишь один пример, но его применение огромно, поэтому мы должны понять этот алгоритм.
Хотите получить виртуальный номер быстро, не тратя лишних нервов и денег? Читайте нашу статью.
Кроме того, поясним, что такое виртуальный номер.
Виртуальный номер — это ваш обычный номер телефона, который хранится на физической SIM-карте. Однако, несмотря на это, между виртуальным номером и обычным номером есть существенная разница. Разница, однако, в том, что вам не обязательно иметь ту самую SIM-карту.
Получить виртуальный номер можно благодаря интернету. После этого освободите 5 минут своего времени с помощью интернет-площадок, торгующих поддельными номерами. А если вы уже зарегистрированы в системе интернет-магазина продавца, покупка займет пару минут.
Три простых шага для получения смс бесплатно через интернет:
Например, если вы хотите создать вторую страничку для ВКонтакте, то перейдите в кабинет, выберите страну, а после – зайдите на сайт социальной сети.
Скопируйте выданный номер и вставьте в форму регистрации ВКонтакте для получения СМС с кодом регистрации.
После поступления СМС сообщения вам остается скопировать код подтверждения и использовать его для завершения активации аккаунта.
Python предоставляет различные методы взаимодействия с операционной системой для управления именами файлов и именами каталогов через модуль os. В этой статье обсуждается один из встроенных методов Python, используемых для получения базового имени файла по заданному пути: метод os.path.basename(), который позволяет нам извлечь имя файла из указанного пути.
Мы должны использовать os.path.basename() в коде, импортируя модуль os. Этот метод os.path.basename() дополнительно использует функцию split() для разделения строки пути на пару, которая будет возвращать начало и конец. Головная часть предназначена для имени каталога, а хвостовая часть возвращается методом os.path.basename(). Давайте подробнее об этом методе.
Чтобы получить имя файла, которое является базовым именем из пути, мы должны использовать этот синтаксис.
Os.path.basename(path)
Os.path — это подрежим модуля os для манипулирования именами путей. Итак, сначала нам нужно импортировать модуль os для этого метода базового имени.
Этот метод os.path.name() принимает только указанную строку пути, представляющую путь к файловой системе.
os.path.basename() вернет значение в строке заданного пути, которое является базовым именем файла. Теперь у нас будет простой пример реализации того, как работает этот метод os.path.basename().
В Windows и Unix у нас есть разные форматы для извлечения базового имени файла с указанным путем, поэтому в этом примере мы собираемся извлечь базовое имя с синтаксисом окна и синтаксисом Unix. Сначала у нас есть пример окна.
В окне используется разделитель с обратной косой чертой ‘’; мы можем проверить или подтвердить этот разделитель с помощью метода os.path.sep(). Переменная «file_dir» имеет путь «UsersabcDownloadsMy Window», который является именем каталога файла, а «file_name» имеет путь, заданный «UsersabcDownloadsMy Windowindex.html». Обе переменные возвращают базовое имя файла с синтаксисом Window. Мы также будем печатать разделитель окон с помощью метода os.path.sep().
import os.path


file_dir = os.path.basename("UsersabcDownloadsMy Window")


print(file_dir)


file_name = os.path.basename("UsersabcDownloadsMy Windowindex.html")


print(file_name)


print(os.path.sep)
Экран консоли покажет выходные данные, печатающие имя каталога файла, базовое имя файла и знак разделителя.
Теперь у нас есть разделитель Unix, используемый в этом примере ниже. Unix использует косую черту ‘/’ в качестве разделителя пути. Мы можем получить этот разделитель, напечатав метод os.path.sep().
import os.path


file_dir = os.path.basename("/Downloads/ My Unix")


print(file_dir)


file_name = os.path.basename("/Downloads/ My Unix /unix.txt")


print(file_name)
Давайте рассмотрим пример извлечения имени файла с помощью метода os.path.basename(). Мы импортировали os.path для доступа к методу os.path.basename() в этом конкретном примере. У нас есть «базовое имя», которое вернет базовое имя файла, которое мы назначили в os.path.basename. С оператором print() у нас будет базовое имя.
import os.path


basename = os.path.basename("/home/example/exampleFile.txt")


print(basename)
Здесь у нас есть «/home/example/» в качестве имени пути и «exampleFile.txt» в качестве базового имени.
В этом примере мы найдем базовое имя каталога или имени папки. Имя папки или каталога также имеет базовое имя в полном пути. В этом примере у нас есть «Документы» в качестве базового имени из пути «/home/MyDocuments/Documents», который передается в os.path.basename(). Переменная ‘basename’ вернет вывод, который вызывается в функции print().
import os.path


basename = os.path.basename("/home/MyDocuments/Documents")


print(basename)
Мы получим «Документы» в качестве базового имени из приведенного выше кода.
Чтобы получить базовое имя из URL-адреса, нам нужно импортировать библиотеку из модуля стандартного пакета urllib, который называется urlparse. Это поможет нам разделить строки URL на компоненты или снова объединить строку URL в компоненты.
В этом примере будет получено базовое имя URL-адреса для формирования переменной «URL», которая имеет строковый URL-адрес «https://docs.python.org/3/download.html». URL-адрес передается в метод urlparse() в качестве аргумента, который разделит URL-адрес на части. Этот анализ URL-адреса хранится в новой переменной «x», которая будет отображать строку разделенного пути URL-адреса. На этот раз мы используем os.path.basename() через оператор печати.
import os


from urllib.parse import urlparse


url = "https://docs.python.org/3/download.html"


x = urlparse(url)


print(x.path)


print(os.path.basename(x.path))
Отображение разделенной строки URL-адреса и базового имени из URL-адреса.
В этом примере используется метод os.path.split() для возврата пары «голова» и «хвост» по отдельности. Для этого мы должны передать указанный путь в качестве аргумента в метод os.path.split(). Мы получим «голову» и «хвост» отдельно через оператор печати.
import os


path = "/Users/Desktop/Article/python/code.py"


head_tail = os.path.split(path)


print(head_tail)
Вы можете увидеть вывод этого кода, поскольку он показывает головную часть и хвостовую часть по отдельности.
Мы извлекли базовое имя и расширение, определенные в этом примере. Мы будем извлекать имя файла без расширения с помощью другого метода os.path.splitext(). Этот метод даст только базовое имя, определенное в os.path.basename().
Мы назначили путь как «home/example/example3.txt» в переменной «basename». Используйте индекс как «0», чтобы получить базовое имя без расширения.
import os.path


path_name="home/example/example3.txt"


basename = os.path.splitext(os.path.basename(path_name))[0]


print(basename)
У нас есть вывод basename как «example3» без расширения на экране консоли.
В этой статье мы рассмотрели все возможные способы получения базового имени по указанному пути. Кроме того, мы продемонстрировали получение базового имени в Windows и Unix с разными разделителями. Теперь, надеюсь, эта функция даст вам четкое понимание.
Парадигма внедрения зависимостей (DI) в течение минувшего десятилетия де-факто стала одной из доминирующих на платформе .NET и теперь обязательна к изучению для всех .NET-разработчиков.
Это переработанное и дополненное издание классической книги «Внедрение зависимостей в .NET».
Вы научитесь правильно внедрять зависимости для устранения жесткой связи между компонентами приложения. Читать