В данной инструкции будут рассмотрены небольшие сценарии работы с Gitlab Pipelines. Мы приведем примеры использования наиболее востребованных опций при работе с CI/CD. По мере необходимости, база шаблонов будет пополняться.
Шаблоны
В данном разделе напишем несколько готовых шаблонов, которые можно взять за основы при написании своего сценария.
1. Минимальный сценарий. Для небольших заданий, состоящих из пары заданий:
* в данном примере мы до того, как начнем проходить по всем заданиям сборки, определим переменную с версией, прочивав ее из файла, и передадим артефактом в качестве системной переменной VERSION.
Image
https://docs.gitlab.com/ee/ci/yaml/#image.
Задаем имя образа, если наше задание выполняется в контейнере docker:
Основная часть, где выполняются задания сценария, описана в опции script. Рассмотрим ее подробнее.
1. Описание массива команд. Мы просто перечисляем списком те команды, которые необходимо последовательно выполнить нашему сценарию в конкретной задаче:
TASK_NAME:
  ...
  script:
    - command1
    - command2
2. Длинные команды, разбитые на несколько строк. Нам может потребоваться выполнить команды в виде скрипта (с операторами сравнения, например). В этом случае будет удобна многострочная запись. Ее можно указать разными способами.
* в моем примере, в артефакты попадут все файлы, название которых заканчивается на txt, файлы ${PKG_NAME}.deb и ${PKG_NAME}.rpm, а также каталог configs. Где ${PKG_NAME} — переменная (подробнее о переменных ниже).
В других заданиях, которые будут выполняться после можно использовать артефакты, обращаясь к ним по именам, например:
* в данном примере мы исключаем каталог .git, в котором, как правило, хранятся метаданные репозитория. ** обратите внимание, что в отличие от paths, exclude не берет файлы и каталоги рекурсивно и нужно явно указывать объекты.
Extends
https://docs.gitlab.com/ee/ci/yaml/#extends.
Позволяет вынести часть сценария в отдельный блок и объединить его с заданием. Чтобы это лучше понять, рассмотрим конкретный пример:
* обратите внимание, что мы применяем правило if (о нем ниже).
Директивы правил и ограничений
Для управления поведением выполнения задач могут использоваться директивы с правилами и условиями. Подробнее мы их рассмотрим ниже, а в данном разделе просто перечислим их.
Rules
https://docs.gitlab.com/ee/ci/yaml/#rules.
Правила, при соблюдении которых наше задание может быть запущено. Примеры работы с директивой rules приведены ниже.
When
https://docs.gitlab.com/ee/ci/yaml/#when.
Определяет условия запуска задания, например, только ручной запуск или через определенный интервал времени. Примеры работы приведены ниже.
Needs
https://docs.gitlab.com/ee/ci/yaml/#needs.
Тоже набор правил, требующий определенных условий для запуска задачи. Все директивы условий и правил описаны ниже.
Правила и условия
Мы можем выполнять или пропускать задания, в зависимости от выполнения определенных условий. Для этого существует несколько полезных директив, которые мы рассмотрим в данном разделе.
Rules
Регламентирует различные правила, определенные с помощью:
if.
changes.
exists.
allow_failure.
variables.
1. Оператор if. Позволяем проверить условие, например, если переменная равна определенному значению:
* в данном примере задание будет выполняться, если коммит прошел в основной ветке и если администратор подтвердил запуск.
Needs
Позволяет задавать условия выполнения заданий только при наличии определенного артефакта или выполненного задания. С помощью правил данного типа можно контролировать порядок выполнения задач.
Рассмотрим примеры.
1. Artifacts. Принимает значение true (по умолчанию) и false. Для запуска задания нужно, чтобы на предыдущих этапах были загружены артефакты. Запись:
TASK_NAME:
  ...
  needs:
    - artifacts: false
… позволяет начать выполнение задания без этого.
2. Job. Позволяет начать выполнение задачи только после завершения другого задания:
TASK_NAME:
  ...
  needs:
    - job: createBuild
* в нашем примере задача начнет выполняться не раньше завершения задачи с названием createBuild.
Переменные
В данном разделе будут рассмотрены пользовательские переменные, которые мы можем использовать в сценарии на свое усмотрение, а также некоторые встроенные переменные, которые могут менять процесс работы конвейера.
Пользовательские переменные
Задаются с помощью директивы variables.
Можно определить глобально для всех заданий:
variables:
  PKG_VER: "1.1.1"
Или для конкретного задания:
TASK_NAME:
  ...
  variables:
    PKG_VER: "1.1.1"
Теперь можно использовать нашу переменную в сценарии. Для этого ставим перед ее названием знак доллара, а также стоит заключить его в фигурные скобки, например:
  script:
    - echo ${PKG_VER}
Переменные Gitlab
Данный тип переменных поможет нам управлять процессом сборки. Перечислим данные переменные с описанием их свойств:
Переменная
Описание
Пример
LOG_LEVEL
Определяет уровень журнала. Варианты: debug, info, warn, error, fatal, и panic. Имеет более низкий приоритет, по сравнению с аргументами командной строки —debug, —log-level.
LOG_LEVEL: warning
CI_DEBUG_TRACE
Включение или отключение ведения журнала отладки. Принимает значения true или false.
CI_DEBUG_TRACE: true
CONCURRENT
Ограничивает количество заданий, которые могут выполняться одновременно.
CONCURRENT: 5
GIT_STRATEGY
Способ загрузки файлов из репозитория. Возможны варианты: clone, fetch, и none (не загружать).
GIT_STRATEGY: none
Дополнительные параметры
В данном разделе мы рассмотрим различные опции, которые не вошли в другие разделы.
1. Workflow. Позволяем задать общие правила запуска для всего конвейера. Рассмотрим пример с официального сайта:
Не будет запущен, если название коммита содержит текст draft.
Будет запущен, если пайплайн сработал после merge request.
Будет запущен, если изменения внесены в основную ветку репозитория.
2. Значения по умолчанию. Задаются в директиве default. Опции с данными значениями будут использоваться во всех заданиях или могут быть переопределены на уровне конкретного задания.
Пример:
default:
  image: centos:7
  tags:
    - ci-test
* мы определили опцию с именем образа (например, образа docker) и тег (теги могут быть необходимы для запуска некоторых runner).
3. Импорт конфигурации из другого файла yml. Может быть полезным, например, для написания общей части сценария, которую мы захотим применять ко всем pipeline или для разделения громоздкого сценария на составные части. Выполняется с помощью опции include. Имеет различные варианты подгрузки файлов. Рассмотрим их подробнее.
а) подключение локального файла (local):
include:
  - local: .gitlab/ci/build.yml
б) коллекции шаблонов (template):
include:
  - template: Custom/.gitlab-ci.yml
* в данном примере мы подключим к нашему сценарию содержимое файла Custom/.gitlab-ci.yml.
* давайте разберемся, что происходит в нашем примере.
Мы создали задачу apt-cache. Точка в начале названия говорит системе, что данную задачу не нужно стартовать автоматически при запуске pipeline. Созданная задача состоит из двух секций script и after_script. Секций может быть больше.
Мы выполняем стадию install. В одной из строк выполнения мы вызываем apt-cache (только команды из раздела script).
При выполнении стадии update мы вызываем apt-cache два раза — первый выполняет команды раздела script, второй — after_script.
В данной инструкции мы рассмотрим пример docker-compose файла для организации системы мониторинга на базе Prometheus. Мы получим:
Базу данных Prometheus и интерфейс для выполнения PromQL.
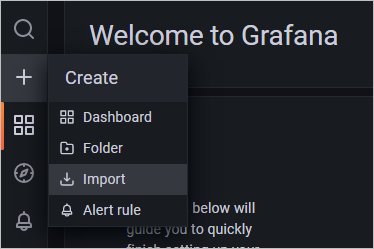
Визуализацию с помощью Grafana.
Сбор метрик через Node Exporter.
Мониторинг HTTP с использованием Blackbox.
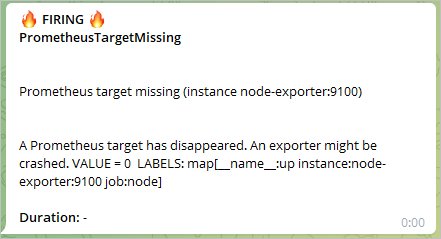
Отправку уведомлений в Telegram с помощью Alertmanager.
Мы будем работать в среде Linux, хотя полученный файл docker-compose можно применять где угодно. Останавливаться подробно на описании docker-compose мы не будем.
Подготовка системы
Подразумевается, что у нас установлен Docker и docker-compose, в противном случае, можно воспользоваться инструкцией Установка Docker на Linux.
* в данном примере мы создаем 2 сервиса — prometheus и node-exporter. Также мы отдельно определили подсеть 172.28.0.0/16, в которой будут находиться наши контейнеры docker.
* в данном примере мы прописываем наш node-exporter в качестве таргета.
Запускаем контейнеры:
docker-compose up -d
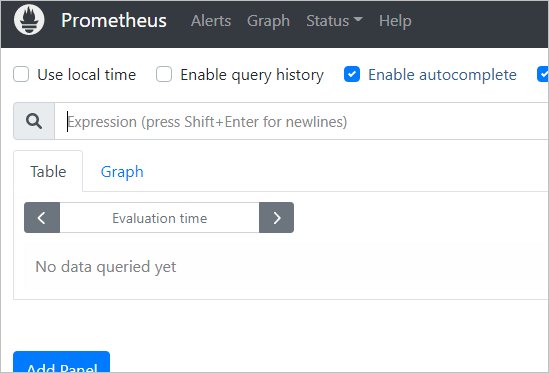
Ждем несколько секунд и можно пробовать подключиться. Открываем браузер и переходим по адресу http://<IP-адрес сервера>:9090 — мы должны увидеть страницу Prometheus:
Переходим по адресу http://<IP-адрес сервера>:9100 — мы должны увидеть страницу Node Exporter:
Мы движемся в правильном направлении. Идем дальше.
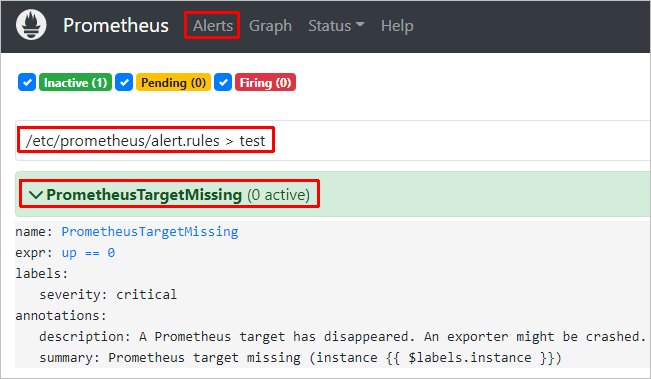
* в данном примере мы указали, что наш сервер мониторинга должен использовать в качестве системы оповещения alertmanager, который доступен по адресу alertmanager:9093. Также мы добавили файл alert.rules с описанием правил оповещения.
Создаем файл с правилами оповещения:
vi prometheus/alert.rules
groups:
- name: test
  rules:
  - alert: PrometheusTargetMissing
    expr: up == 0
    for: 0m
    labels:
      severity: critical
    annotations:
      summary: "Prometheus target missing (instance {{ $labels.instance }})"
      description: "A Prometheus target has disappeared. An exporter might be crashed. VALUE = {{ $value }}  LABELS: {{ $labels }}"
* в данном примере мы добавили правило, которое будет срабатывать при недоступности узла (node-exporter).
Осенью 2018 года мы опубликовали список из 25 полезных инструментов Kubernetes. С тех популярность платформы сильно выросла. Экосистема оркестрации контейнеров бурно развивается, можно найти вспомогательные инструменты практически для любой задачи.
Поэтому команда Kubernetes aaS от Mail.ru обновила и дополнила подборку. Предлагаем вашему вниманию список с почти сотней полезных инструментов, упрощающих жизнь тем, кто работает с Kubernetes.
Оператор Kubernetes, который автоматизирует обновления DaemonSet, StatefulSet, Helm и Deployment. Одна команда, никаких зависимостей, конфигурационных файлов и блокировок.
Набор служб Kubernetes, который упрощает работу в продакшене под серьезной нагрузкой. Обеспечивает мониторинг производительности в кластере, ведение журналов, управление сертификацией и автоматическое обнаружение ресурсов в K8s через общедоступные DNS-серверы. Это полезный набор сервисов и для других инфраструктурных нужд.
После установки k3sup (произносится как ketchup) вы можете за считанные секунды сгенерировать kubeconfig на любой локальной или удаленной виртуальной машине.
На платформе можно развернуть кластеры Kubernetes в виде облачного сервиса: за несколько минут вы получите готовый к работе кластер без необходимости в настройке и обновите его до нужной версии. Также кластеры просто масштабировать — они работают на инфраструктуре Mail.Ru, рассчитанной на высоконагруженные сервисы.
Средство для инициализации кластеров Kubernetes в оптимальной конфигурации на вашей инфраструктуре. Главное преимущество — возможность запускать минимально жизнеспособные кластеры Kubernetes в любой среде. Надстройки и сетевые настройки не входят в конфигурацию из коробки, все придется настроить вручную.
Набор ролей Ansible для развертывания и конфигурации Kubernetes. Работает на разных облачных платформах: AWS, GCE, Azure, Mail.Ru Cloud Solutions, OpenStack и bare metal IaaS. Это open source проект, построен на kubeadm. Подходит тем, кто хорошо знаком с Ansible — с этим инструментом вам ничего не нужно больше знать, чтобы развернуть все нужные ресурсы.
Позволяет развертывать Kubernetes с помощью нескольких команд, поддерживает развертывания на локальном хосте, bare metal, в облачных средах, в том числе OpenStack.
Хорошее начало для тех, кто только знакомится с Kubernetes. Инструмент позволяет пользователям легко запускать одноузловой кластер локально внутри виртуальной машины на ноутбуке пользователя. Поддерживается в Mac OS X, Windows и Linux.
Запускает автономные кластеры и помогает настроить временную плоскость управления Kubernetes. Bootkube также можно использовать для создания необходимых ресурсов, которые будут использоваться при начальной загрузке нового кластера.
Сертифицированный CNCF дистрибутив Kubernetes, работающий внутри контейнеров. Позволяет упростить и автоматизировать установку Kubernetes, не зависеть от операционной системы и платформы, на которой вы работаете.
Простая утилита для прослушивания сервера Kubernetes API, помогает в генерации метрик о состоянии объектов. Фокусируется на работоспособности различных объектов внутри кластера, включая узлы, поды и развертывания.
Терминальная консоль, позволяющая управлять кластером Kubernetes и отслеживать его статус в режиме реального времени. Мониторит кластер, показывает, что происходит с ресурсами подов, журналы контейнеров и другие параметры. Позволяет легко перейти к нужному пространству имен и выполнить команду в нужном контейнере. Это помогает быстро справляться с неполадками и восстанавливать работу.
Плагин Rakess (Review Access) показывает все права доступа к кластеру Kubernetes. Конечно, для отдельных ресурсов можно выполнить проверку командой kubectl auth can-i list deployments, но она не дает полную информацию обо всех ресурсах на сервере.
Bash-скрипт, позволяющий агрегировать журналы многих подов в один поток. В исходной версии не умеет фильтровать или выделять, но на Github есть отдельный форк, позволяющий раскрашивает логи с помощью MultiTail.
Еще один инструмент из категории «tail для подов в Kubernetes». Особенности: использование регулярных выражений для удобной фильтрации подов (не нужно знать конкретные ID), аналогично можно фильтровать отдельные контейнеры для запрашиваемых подов, есть стандартные и кастомные Go-шаблоны для выводимых логов, ограничение вывода логов по периоду времени или количеству строк и много чего еще.
Не можем снова не упомянуть этот опенсорсный инструмент для мониторинга и уведомлений, который давно стал стандартом для мониторинга Kubernetes. Он интегрирован со всеми популярными языками программирования, помогает создавать собственные метрики и содержит много готовых интеграций с популярными технологиями, например: PostgreSQL, MySQL, ETCD.
С помощью Prometheus Operator можно создавать экземпляры Prometheus в кластерах Kubernetes, в том числе тесную интеграцию с Grafana и Alertmanager.
Инструмент трассировки с открытым исходным кодом. Умеет мониторить транзакции и сервисные зависимости в распределенных системах, выявлять и устранять неполадки. Один из способов начать работу с ним в Kubernetes — использовать специальный оператор Jaeger.
Оператор Kubernetes для Icinga. Умеет запускать периодические проверки на кластерах Kubernetes, а потом отправлять уведомления по электронной почте, СМС или в чат, если что-то идет не так. В инструмент по дефолту включен комплект проверок специально для Kubernetes. С его помощью можно расширить возможности мониторинга Prometheus, также он станет резервной системой, если внутренние системы мониторинга полностью откажут.
Read-only системная панель, способная работать со многими кластерами Kubernetes. Позволяет удобно перемещаться между кластерами, отслеживать ноды и состояние подов. Визуализирует ряд процессов, таких как создание и уничтожение подов.
Запускается в подах в кластере Kubernetes, отслеживает системные изменения, после запуска вы будете получать уведомления через веб-хуки. Можно настроить свои уведомления, просто отредактировав файл конфигурации.
Отслеживает и устраняет неполадки в кластерах Kubernetes и Docker, чтобы вы могли легко выявлять и устранять проблемы с контейнеризованными приложениями. Вы можете использовать его, чтобы определить узкие места производительности приложений.
Обеспечивает видимость всего вашего стека, позволяет контролировать эффективность базовой инфраструктуры и производительность запущенных микросервисов в Kubernetes.
Инструмент для проверки конфигурационного файла Kubernetes YAML или JSON. Проверка осуществляется с использованием схем, сгенерированных из Kubernetes OpenAPI. Это позволяет производить валидацию схем для разных версий Kubernetes.
Плагин Helm, используемый для валидации диаграмм на соответствие схемам Kubernetes. Для проверки диаграмм можете выбрать определенные версии Kubernetes.
BotKube может отслеживать, отлаживать и запускать проверки в кластерах Kubernetes. Инструмент также интегрируется в различные платформы для обмена сообщениями, такие как Slack и Mattermost. Преимущества — открытый исходный код и простота настройки.
Sonobuoy — диагностический инструмент для проверки на соответствие нормативам, отладки рабочей нагрузки и проведения пользовательских тестов, которые помогают определить состояние кластера. Тесты выполняются неразрушающим образом, при этом генерируются четкие информативные отчеты.
Состоит из двух диаграмм Helm для тестирования пропускной способности сети и нагрузочного тестирования кластеров Kubernetes. Это поможет убедиться в правильности их конфигурации, а также в работоспособности служб и правильном распределении нагрузки.
Инструмент специфичен для Kubernetes и также следует принципам хаос-инжиниринг, позволяя проверить объекты, работающие в контейнерах. Также его можно использовать для проверки выбранных компонентов кластера вручную через интерактивный режим. После развертывания инструмент работает автономно.
Реестры Harbor защищают образы с контейнерами путем внедрения системы управления доступом на основе ролей. Инструмент также проверяет образы на наличие уязвимостей и подписывает их как надежные.
Инструмент с открытым исходным кодом для анализа рисков безопасности ресурсов Kubernetes. С ним вы сможете контролировать систему и получите полный список рекомендаций по повышению ее общей безопасности.
Это приложение разработки компании SIGHUP позволяет легко управлять ролями доступа для Kubernetes через систему Role-Based Access Control. Создайте пользователей, назначьте пространство имен/разрешения, а также распространите файлы Kubeconfig YAML.
Инструмент от компании Octarine фокусируется на оценке рисков в рабочих нагрузках Kubernetes. Kube-scan запускается как под в кластерах и оценивает 30 параметров безопасности, чтобы вывести максимально приемлемый уровень риска. Затем инструмент анализирует, какие параметры работают в тандеме, чтобы понять, какие комбинации уменьшат уровень угроз.
K-rail предназначен для ситуаций, когда требуется чуть больше контроля в реализации ваших политик. Есть множество простых способов повышения привилегий, но в мультитенантном кластере они могут представлять опасность или приводить к нестабильности.
KeyCloak — опенсорсный инструмент управления доступом и идентификационной информацией пользователей. Он добавляет функцию аутентификации приложений и помогает минимальными усилиями обеспечить безопасность служб. Устраняет необходимость детально разбираться с ведением списка пользователей и их аутентификацией. Всё это теперь работает прямо из коробки.
Инструмент предназначен для защиты инсталляций Kubernetes на протяжении всего жизненного цикла. Он развертывает на каждом контейнере выделенный агент, работающий как межсетевой экран и устраняющий возможные уязвимости. Управлять ограничениями безопасности вы сможете через центральную консоль. Кроме того, инструмент позволяет использовать гибкие настройки безопасности в локальных и облачных средах.
С ним связан еще один open source инструмент — Kube-Bench, проверяющий среду Kubernetes по тестам из документа CIS Kubernetes Benchmark.
Инструмент от создателей проекта Calico, набор решений для сетевой безопасности Kubernetes с поддержкой мультиоблачных и устаревших сред через автоматизированную универсальную политику безопасности.
Klum, или Kubernetes Lazy User Manager, выполняет простые задачи, такие как создать/удалить/изменить пользователей. Он выдает файлы kubeconfig и управляет ролями юзеров.
StrongDM — это плоскость управления для проверки безопасности и доступа к вашим серверам и/или базам данных. Состоит из API аутентификации, прокси-сервера, поддерживающего протокол, и хранилища журналов.
Инструмент для обеспечения безопасности с открытым исходным кодом для облачных вычислений, обнаруживает риски для Kubernetes. Замечает неожиданное поведение приложения и оповещает об угрозах во время его выполнения.
Платформа, обеспечивающая мониторинг безопасности микросервисов и контейнеров. Поддерживаются Kubernetes и Docker. Может быть использована в облаке и локально.
Krew помогает разработчикам находить полезные плагины kubectl для программ и устанавливать, а потом управлять ими. Этот инструмент похож на APT, DNF или Homebrew.
Скрипт Kube-ps1 добавляет текущий контекст Kubernetes и сконфигурированное пространство имен из kubectl в консоль Bash/Zsh, никаких команд не требуется.
Если вы запускаете службы Kubernetes на удаленном кластере, то Kubefwd поможет перенаправить их на локальную рабочую станцию. Никаких модификаций не требуется: если вы используете kubectl, вы уже соответствуете всем требованиям.
Skaffold — консольная утилита, помогающая обеспечить процесс непрерывной разработки приложений Kubernetes. Инструмент очень легкий и не требует компонентов на стороне кластера.
Простой и очень мощный генератор алиасов для kubectl. С его помощью вы сможете очень быстро писать команды для повседневного администрирования Kubernetes, так как он предоставляет более 800 коротких алиасов на все случаи жизни.
Опенсорсная утилита, дополняет Kubectl, позволяет переключать контекст и подключаться одновременно к нескольким кластерам Kubernetes, а также перемещаться между пространствами имен. Есть поддержка автозаполнения в оболочках bash/zsh/fish.
kubectx помогает переключаться между кластерами вперед и назад:
kubens помогает плавно переключаться между пространствами имен Kubernetes:
Инструмент, ускоряющий работу с kubectl. Автодополняет команды, предлагает разные варианты, ищет и исправляет команды, которые введены неправильно, отображает in-line справку о выполняемых командах.
Если вы редко выходите из консоли, Tilt синхронизирует все изменения с кластером и обновляет серверы, так что вы сразу видите, как внесенные изменения влияют на систему. Инструмент показывает состояние каждого ресурса, выдает журналы для каждого из них или всё вместе. Все обновления выполняются внутри контейнера, что делает их очень быстрыми.
Инструмент позволяет отслеживать логи Docker для нужных подов. Он фильтрует поды по службам, развертываниям, меткам и иным параметрам. В соответствии с критериями фильтрации поды после запуска будут автоматически добавлены в журнал или удалены из него.
Пакетный менеджер, помогает управлять приложениями Kubernetes с помощью Helm Charts. Это позволяет пользователям создавать воспроизводимые сборки, которыми можно делиться.
Rook помогает автоматизировать различные задачи для хранилища данных, такие как развертывание, загрузка, масштабирование, обновление и так далее. Это гарантирует, что на Kubernetes будет стабильно работать решение любого поставщика (Ceph, EdgeFS, CockroachDB, Cassandra, NFS, Yugabyte DB).
Shell Operator упрощает создание операторов Kubernetes. Он обеспечивает интеграцию между событиями кластера Kubernetes и сценариями оболочки. Упрощает управление кластером.
Инструмент для управления релизами helm-чартов. Позволяет в одном месте описывать множество helm релизов, задавать порядок их деплоя и делать другие полезные вещи.
Этот инструмент автоматически генерирует документацию из диаграмм Helm в файл markdown. Данный файл содержит метаданные, включая таблицу со всеми значениями диаграммы и значениями по умолчанию.
Позволяет запускать дополнительный контейнер в интересующем вас поде. Новый контейнер будет использовать пространство имен совместно с целевым контейнером/контейнерами.
Почти мгновенно синхронизирует файлы вашей локальной системы с кластером Kubernetes. Подходит, если вы используете сценарии, в которых основной проблемой является доставка кода в работающий контейнер.
Используют для отладки процессов во время их работы в кластере. Простой в использовании, вы можете в интерактивном режиме выбрать нужный отладчик и пространство имен/под интересующего процесса.
Rafay — программный инструмент, который упрощает для компании или отдельного разработчика создание собственной платформы, системы автоматизации и управления жизненным циклом приложений. Rafay также способен запускать кластеры Kubernetes.
Rancher — полноценная программная платформа, которая легко развертывает контейнерные среды, выходящие за рамки инсталляторов Kubernetes, таких как Kops и Kubespray. Предоставляет множество функций, включая управление инфраструктурой, планирование и оркестровку контейнеров, мониторинг, проверку работоспособности, ведение журналов, а также мощную систему управления доступом на основе ролей.
Утилита от разработчиков Helm. Ее цель — упростить приложения, которые разрабатываются для работы в Kubernetes. С помощью двух простых команд вы можете работать с контейнерными приложениями, даже не нуждаясь в установке Docker или Kubernetes.
Пожалуй, наиболее популярный open source CI/CD-сервер в мире. К нему есть бесплатный плагин, помогающий развертывать приложения в Kubernetes, обновлять их с минимальным простоем и обеспечивать Green/Blue-развертывание обновлений.
Известный CI/CD сервис от JetBrains. Есть плагин, с которым можно использовать инфраструктуру кластера Kubernetes для запуска билд-агентов TeamCity (в версии 2017.1.x и новее).
Решение для непрерывного развертывания (CD), предоставляющее интерфейс самообслуживания для команд. Может интегрироваться с существующими процессами сборки. Это позволяет управлять кластерами Kubernetes, предоставляя каждому пользователю определенные разрешения для обеспечения безопасности развертывания.
CLI-инструмент с открытым исходным кодом, написанный на Go, предназначен для упрощения и ускорения доставки приложений. Werf создает образы Docker с использованием Dockerfiles или альтернативного быстрого встроенного компоновщика на основе собственного синтаксиса. Он также удаляет неиспользуемые образы из реестра Docker. Потом Werf развертывает ваше приложение в Kubernetes, используя диаграмму в формате, совместимом с Helm, с удобными настройками и улучшенным механизмом отслеживания развертывания, обнаружения ошибок и вывода журнала.
Инструмент позволяет создавать конвейеры, которые можно встроить в любую существующую систему CI/CD.
Garden — инструмент для разработчиков, который автоматизирует ваши рабочие процессы и делает разработку и тестирование приложений Kubernetes быстрее и проще. Подходит для совместной разработки в удаленном кластере.
Kiali помогает создавать определения, проверять и наблюдать за работой микросервисов и соединений в сервисной сетке Istio. Инструмент создает визуальное графическое представление топологии сервисной сетки и дает представление о таких функциях, как разрыв цепи (circuit breaker), маршрутизация запросов, задержка и других.
Универсальная панель управления для сервисных сеток и микросервисов. Может нативно работать и в виртуальной среде, и в Kubernetes. Легко вводится в арсенал инструментов любой команды в организации.
Tenkai — это менеджер микросервисов, основанный на диаграммах Helm. Инструмент с графическим веб-интерфейсом позволяет вызывать репозитории из диаграмм Helm, легко их настраивать и деплоить.
Репозиторий с множеством инструментов для обнаружения служб, которые видны из ваших приложений с микросервисами. Службы можно импортировать и из Kubernetes (а также из Docker и Consul).
Веб-инструмент с открытым исходным кодом, который позволяет визуализировать ваши рабочие нагрузки Kubernetes и предоставляет по ним обновления в режиме реального времени.
Kubernetic помогает легко и быстро развертывать общедоступные или приватные диаграммы, видеть все связанные объекты кластера и их зависимости на одном экране. Отличается такими функциями, как визуализация в реальном времени, а также поддержка нескольких кластеров.
Веб-интерфейс для каталога приложений в кластерах Kubernetes. Позволяет устанавливать, обновлять и удалять Helm-чарты нажатием одной кнопки, без использования командной строки.
Приложение для рабочего стола, работает в Windows, Mac и Linux. Может подключаться к локальному кластеру K8s, подходит для небольшого количества кластеров.
Программное обеспечение с открытым исходным кодом, удобный графический интерфейс. Отображает все конфигурации, относящиеся к приложению, в одном месте. Это экономит время, избавляя от необходимости искать настройки и копаться в селекторах и метках. Один из недостатков инструмента — он работает непосредственно на кластере K8s. Значит, вам придется развертывать Kubevious на каждом кластере, а не просто указывать на существующий.
Основанный на терминалах пользовательский интерфейс, использующий Node.js. Довольно прост в использовании, но в настоящее время ограничен несколькими командами kubectl. Позволяет легко перемещаться по различным пространствам имен кластера K8s и быстро отображать состояние заданного набора подов.
Безсерверная инфраструктура Kubernetes с открытым исходным кодом, которая позволяет вам развертывать небольшие фрагменты кода. Поддерживает большинство популярных языков, позволяет редактировать и развертывать функции в режиме реального времени.
Еще один открытый серверный фреймворк Kubernetes с открытым исходным кодом. Поддерживает все языки программирования. Напишите недолговечные функции на любом языке и сопоставьте их с HTTP-запросами (или другими триггерами событий) — инструмент позволяет развернуть функции мгновенно с помощью одной команды. Нет контейнеров для сборки и нет реестров Docker для управления.
Это модель программирования лямбда-стиля с открытым исходным кодом для Kubernetes. Позволяет разработчикам сосредоточиться на написании функций, в то время как Kubernetes позаботится обо всем остальном.
Серверная вычислительная платформа с открытым исходным кодом для любого облака — частного, общедоступного или гибридного. Используя этот инструмент, разработчики могут просто загрузить свой код, пока платформа работает с инфраструктурой.
Упрощает развертывание как функций, так и существующего кода в Kubernetes. Работает в публичных и частных облаках. Позволяет создавать микросервисы и функции на любом языке.
Cерверный проект, который позволяет использовать его в качестве автономного контейнера Docker или даже поверх другого кластера Kubernetes. Предназначен для работы с высокопроизводительными событиями и большими объемами данных. Также обеспечивает обработку данных в режиме реального времени с минимальными издержками.
Является открытой реализацией Kubernetes Kubelet. Запускается внутри контейнера в вашем текущем кластере и маскируется под узел. Оттуда он контролирует запланированные пакеты так, как это делает настоящий Kubelet.
На этом всё. Пишите в комментариях, если знаете другие полезные инструменты.
Сам Хельм в общих чертах рассмотрели в посте Helm: Kubernetes package manager — обзор, начало работы – теперь надо прикрутить его в Jenkins. И не просто прикрутить его вызов – а создать чарт, потому что сейчас приложение деплоится через “голые” манифест-файлы Kubernetes, в котором sed проставляет теги Докер-образа и значения переменных для загрузки на окружение через kubectl apply -f.
Данный пост очередной НЕ-HowTo, а пример знакомства с Helm: возьмём существующий проект, который уже деплоится в Kubernetes-кластер, обновим его манифесты, что бы использовать их с Helm, продумаем – как именно и куда будем деплоить, и создадим Jenkins-джобу.
По ходу дела будем ближе знакомиться с Helm, и его подводными камнями.
Итак, у нас имеется некое веб-приложение, которое надо деплоить в Kubernetes.
Само приложение разбито на две части – фронтенд на React, хостится и деплоится в AWS S3, и бекенд – NodeJS, работает в Docker-контейнере.
Первый вопрос, который появляется в голове – монорепа, или нет?
Т.е. – где хранить код приложения, где – файлы чартов Helm-а, а где – jenkins-файлы?
Хотелось бы монорепу, и всё держать в одном репозитории, но у нас подобных проектов будет не один, и смысла под каждый писать отдельные дженкис-файлы нет. Тем более, что если (когда!) захочется что-то изменить в одном – то придётся делать это во всех по отдельности.
При этом и их файлы манифестов для Kubernetes будут практически одинаковы – и можно было бы заморочится вообще, и используя возможности шаблонизатора Go – использовать один общий чарт на всех.
Но так как их одинаковость пока под вопросом – запускаемые веб-проекты ещё только разрабатываются, да ещё и отдельными группами девелоперов – то чарты будем делать под каждый проект отдельно.
Значит, у нас будет:
отдельный репозиторий с кодом проекта
там же в отдельной папке храним файлы чартов
отдельный репозиторий с файлами для Jenkins-pipeline
Хочется прикрутить ещё и релизы, да ещё и связать их с Github Releases – но это, может быть, потом. В целом – реализуемо, и даже есть helm/chart-releaser.
Jenkins build steps
Дальше.
Билд Docker-образов – и билд/деплой самих чартов – делать одной джобой – или разными?
Сейчас у нас образы собираются в одной джобе, после чего пушатся в DockerHub, после чего девелопер должен сходить в джобу деплоймента, и при запуске в параметрах указать тег (номер билда) + дополнительные параметры:
Это, конечно, ни разу неудобно, поэтому переделаем.
Опционально – удалять с chart uninstall. Про удаление ресурсов вообще поговорим ниже.
Что ещё?
Namespaces
Ооо – нейспейсы жеж!
Что хочется:
иметь возможность деплоить по одной кнопке в какой-то дефолтный namespace, имя которого зависит от проекта/приложения/чарта
деплоить в кастомный namespace – по имени бранча репозитория, из которого запускался билд
деплоить в вообще кастомный namespace – дать возможность указать его при старте джобы
А как их потом удалять?
Можно добавить вебхук из Гитхаба при delete-операциях, но во-первых часть проектов хостятся в Gitlab – хотя он тоже умеет в вебхуки. Но во-вторых – а все ли девелоперы всех команд будут удалять свои закрытые бранчи?
Т.е. тут проблема как раз из-за разных команд и разных проектов, а решение хочется иметь маскимально универсальное.
А удалять НС-ы надо – иначе будет пачка заброшенных ресурсов – подов, ингресов, волюмов, и т.д.
Что делать?…
Окей. А пусть будет какой-то дефолтный неймспейс. Например, чарт/приложение называются bttrm-apps – значит, для Dev-деплой джобы НС будем создавать bttrm-apps-dev-ns.
В джобе добавить параметр, в нём сделать возможность выбора – использовать этот дефолтный НС, создать/использовать НС по имени бранча, или указать свой.
Можно так в Jenkins?
Не факт – идём глянем.
Choise parameter – тут просто задаётся список предефайненных значений – нельзя будет задать своё имя НС-а:
А Multi string parameter?
Вроде как что-то аналогичное Choise parameter?
Смотрим на него:
Нет, тоже не подходит – оно просто из параметра передаст нам в переменную дженкисфайла значение из нескольких строк, а нам нужна одна string.
Значит – или таки обычный String параметр, или Choise parameter с набором уже заданных значений… Но тогда потеряем возможность создать кастомный НС…
Или… Или… Или… Мысль…
А что на счёт Boolien parameter?
Типа “поменять НС”…
Дефолтное значение “не менять” – и используем предефайненное значение bttrm-apps-dev-1-ns…
А если юзер выбирает менять – то используем имя НС как имя бранча – а имя бранча вытянем из репозитория после чекаута…
Мысль? А может быть!
Хотя снова-таки – лишаемся возможности создать кастомный НС…
А что если просто использовать тот же Choise parameter с набором уже заданных значений, но создать три значения:
use default bm-apps-dev-ns
use github-branch-name
set own name
А потом в коде самого пайплайна проверять выбор, и если выбрано set own name – то просто запросить User input, и пользователь задаст имя неймспейса, который хочет создать.
Тоже не самое кошерное решение – но может сработать. Пока остановимся на нём.
Остаётся открытым вопрос про удаление НС-ов – будем думать потом
Хотя потом может быть больно.
В конце-концов – мы спокойно можем раз в месяц удалять весь Dev-кластер, и провиженить заново – дело 20 минут и одного клика в Jenkins, а для Stage/Prod деплоев будут использоваться только жёстко заданные неймспейсы, потому там такой проблемы не будет (но это не точно).
Окей, make sense.
Что дальше?
Дальше локально сделаем:
создадим чарт для приложения – используем реальное, но отбранчуемся, что бы не мешать девелоперам.
настроим kubectl на новый Dev-кластер
выполним helm install
Потом пойдём делать джобу в дженкисе.
Джоба будет клонировать репозиторий с приложением, и делать helm install в нужный namespace.
А релиз-версии нужны судя по всему только если мы будем заливать чарты в виде архивов в свой Helm-репозиторий – в самом Кубере они никак не применяются…
Значит – пока этот вопрос отложим, потом вернёмся к chart-releaser.
Поехали тестить?
Helm test deploy
kubectl config
У меня есть новый тестовый кластер bttrm-eks-dev-1 – создаём для него конфиг.
aws --profile arseniy eks update-kubeconfig --name bttrm-eks-dev-1 --alias arseniy@bttrm-eks-dev-1
Added new context arseniy@bttrm-eks-dev-1 to /home/setevoy/.kube/config
Создаём тестовый чарт:
cd /tmp/
helm create deployment-testing-chart
Creating deployment-testing-chart
Helm: the server has asked for the client to provide credentials
Пробуем залить в default namespace:
helm install deployment-testing-chart --dry-run deployment-testing-chart/
Error: Kubernetes cluster unreachable: the server has asked for the client to provide credentials
WTF?
Проверяем контекст:
kk config current-context
arseniy@bttrm-eks-dev-1
(kk – алиас для kubectl в ~/.bashrc: alias kk="kubectl")
Всё верно…
А доступ есть?
kk get pod
error: You must be logged in to the server (Unauthorized)
kk config delete-context arseniy@bttrm-eks-dev-1
warning: this removed your active context, use "kubectl config use-context" to select a different one
deleted context arseniy@bttrm-eks-dev-1 from /home/setevoy/.kube/config
helm install deployment-testing-chart deployment-testing-chart/ --namespace deployment-testing-chart-ns
Error: create: failed to create: namespaces "deployment-testing-chart-ns" not found
This is a known limitation of Helm. Helm will not do cross-namespace management, and we do not recommend setting namespace: directly in a template. If you want to install resources in a namespace other than the default namespace, helm install –namespace=foo will install the resources in that namespace. If the namespace does not exist, it will create it.
Эээ? Так мы ж так и делали…
Читаем ниже:
For Helm 3, the namespace creation doesn’t happen during helm install any more, so you’ll have to create that namespace ahead of time as you do today.
For Helm 3, the namespace creation doesn’t happen during helm install any more, so you’ll have to create that namespace ahead of time as you do today.Right now, use kubectl create namespace foo prior to helm install. When Helm 3.2.0 is released, use helm install … –create-namespace.
А у нас какая?
helm version
version.BuildInfo{Version:"v3.2.0", ...
kk get ns
NAME                          STATUS   AGE
bttrm-apps-dev-1-ns           Active   28h
bttrm-workouts-dev-1-ns       Active   28h
default                       Active   28h
deployment-testing-chart-ns   Active   19s
...
Няшка.
Сервисы:
kk -n deployment-testing-chart-ns get svc
NAME                       TYPE        CLUSTER-IP       EXTERNAL-IP   PORT(S)   AGE
deployment-testing-chart   ClusterIP   172.20.227.114   <none>        80/TCP    2m1s
Окей, вроде работает – можно думать за Helm chart для самого приложения.
Хотя тут можно начать наоборот с Jenkins-джобы и скрипта, и использовать тестовый чарт, а потом создавать чарт реального приложения.
Но давайте сначала всё-таки приведём в рабочий вид приложение.
Helm – создание чарта
Сейчас у нас файлы для Kubernetes лежат в отдельном репозитории devops, а код приложения – в репозитории самого приложения.
Что надо сделать – это создать чарт в репозитории с приложением – в этом репозитории будет и Dockerfile, там же будем хранить Chart.yaml.
Скрипты для Jenkins (jekinsfiles) хранятся в ещё одном отдельном репозитории для общего доступа из различных, но однотипных джоб.
What about RBAC?
Кстати. Задумался я о том, как мы будем деплоить с Jenkins и о правах доступа.
Сам Jenkins использует свою EC2 Instance Profile, которая даёт ему полный доступ к кластерам. Ту же роль использую сейчас я при AssumeRole, которую мы настроили выше в ~/.aws/config.
А что с девелоперами?
У них-то создаются отдельные RoleBinding из определённых неймспейсов, в которые им разрешается доступ, а не глобальный рутовый доступ, как у меня.
Значит – эти RoleBinding надо включить в чарт, и создавать их в тех неймспейсах, которые будут создавать при деплое чарта из Jenkins в – напомню – том числе и кастомные неймспейсы.
Как быть? Делать RBAC сабчартом?
Вопрос… Да и для самого Helm, по-хорошему, надо создавать отдельный Kubernetes ServiceAccount при создании кластера.
Хотя – зачем нам выносить доступы юзеров в отдельный чарт или сабчарт?
Там всего-то создать одну RoleBinding в нужном неймпсейсе. А “глобальная” ClusterRole создаётся при провижене самого кластера из Ansible (потом надо будет переписать на Helm, и все RBAC-ресурсы через него деплоить).
Собственно, как говорилось в начале – все КАПСы вырезаются в Jenkins с помощью sed, и меняются на реальные значения, полученные из параметров джобы, а потом выполняется kubectl apply -f.
spec: replicas: DEPLOY_REPLICAS_NUM вот – тут уже пора в values.yaml идти, добавляем в нём replicaCount: 2 а в деплойменте используем replicas: {{ .Values.replicaCount }}, см. пример ниже
selector: matchLabels: app: bttrm-apps-EKS_ENV меняем на application: {{ .Chart.Name }}
Сначала думал в имя деплоймента включить .Chart.Version или .Chart.AppVersion – но тут у Хельма всё оказалось через… Печаль какую-то, т.к. задать их значения во время helm install нельзя – только во время package, см. https://github.com/helm/helm/issues/3555 (с 2018 обсуждают!).
Ладно – оставим на совести разработчиков – жираф большой, ему виднее. Пока в имени оставлю {{ .Chart.Name }} – по ходу дела посмотрим. Да и не факт, что использовать версии в имени хорошая идея.
Получится строка типа bttrm/bttrm-apps:TAG, а TAG думаю формировать при сборке образа из $BUILD_NUMBER + $GIT_COMMIT, т.е. получим что-то вроде bttrm/bttrm-apps:123.67554433.
Значения для плейсхолдеров типа CLIENT_HOST_VAL в основном будут задаваться из параметров джобы Дженкинса, но добавляем их в values тоже. Где можно – задаём дефолтные значения, где нет – просто “”.
Пока, кстати, вообще все значения можно задать в values – до Jenkins-джобы ещё будем тестить локально.
Кавычки
А что там с кавычками, кстати?
Тоже мрак)
С одной стороны – документация по созданию чарта (тыц>>>) и по переменным (тыц>>>) говорит использовать quote-функцию, которая будет “оборачивать” наши значения в кавычки.
При этом, если посмотреть файлы, сгенерированные при helm create – то там нет ни quote, ни кавычек – в большинстве случаев. Но не везде
YAML’s type coercion rules are sometimes counterintuitive. For example, foo: false is not the same as foo: “false”. Large integers like foo: 12345678 will get converted to scientific notation in some cases.The easiest way to avoid type conversion errors is to be explicit about strings, and implicit about everything else. Or, in short, quote all strings.
Мрак!
Ладно – в values.yaml стринги заключаем в кавычки, целочисленные – без кавычек.
В файле шаблонов… Я не знаю
Использовать quote – тогда само значение в переменных будет с кавычками. Посмотрел, как приложение запущено сейчас – без кавычек:
kk -n bttrm-apps-stage-ns describe pod bttrm-apps-stage-7c5cfd9698-tkmjp | grep CLIENT_HOST
CLIENT_HOST:                          https://test.example.com
Значит пока без quote, и без явного указания “” в шаблоне вообще.
helm install --debug bttrm-apps-backend-release bttrm-apps-backend
install.go:159: [debug] Original chart version: ""
install.go:176: [debug] CHART PATH: /home/setevoy/Work/landing-backend/k8s/bttrm-apps-backend
client.go:108: [debug] creating 6 resource(s)
Error: Deployment in version "v1" cannot be handled as a Deployment:
v1.Deployment.Spec: v1.DeploymentSpec.Template: v1.PodTemplateSpec.Spec: v1.PodSpec.Containers: []v1.Container: v1.Container.Env: []v1.EnvVar: v1.EnvVar.Value:
ReadString: expects " or n, but found 3, error found in #10 byte of ...|,"value":3001}
Ах ты ж…
Вот честно – я тут очень матерился.
Может я не догоняю чего-то, но ты же мне везде в документации говоришь, что Integer без кавычек кушаешь нормально?
Что ж ты теперь ругаешься на цифры?
Про то, как Go вообще ошибки выводит промолчим – в них часто сложно что-то понять.
Но тут в принципе видно значение, вызвавшее ошибку – 3001:
v1.PodSpec.Containers: []v1.Container: v1.Container.Env: []v1.EnvVar: v1.EnvVar.Value: ReadString: expects ” or n, but found 3, error found in #10 byte of …|,”value”:3001}
Непонятно, конечно, где именно – но так как порты в деплойменте встречаются не так часто – то просто добавляем кавычки для всех, меняем:
При этом в ports: - containerPort: на кавычки он ругается.
А в livenessProbe: port: при --dry-run не ругается. А при install – ругается.
Рукалицо. Ладно.
Деплоим ещё раз:
helm install --debug bttrm-apps-backend-release bttrm-apps-backend/
install.go:159: [debug] Original chart version: ""
install.go:176: [debug] CHART PATH: /home/setevoy/Work/landing-backend/k8s/bttrm-apps-backend
client.go:108: [debug] creating 6 resource(s)
NAME: bttrm-apps-backend-release
LAST DEPLOYED: Sun May 10 14:35:37 2020
NAMESPACE: default
STATUS: deployed
REVISION: 1
...
Йай!
Проверяем:
helm ls
NAME                    NAMESPACE       REVISION        UPDATED                                         STATUS          CHART                   APP VERSION
bttrm-apps-backend-release   default         1               2020-05-10 14:35:37.364401788 +0300 EEST        deployed        bttrm-apps-backend-0.1.0     1.16.0
Ну – бимба!
Оно 100% не работает, но нам важен сам файкт, что оно задеплоилось:
kk get pod
NAME                                 READY   STATUS    RESTARTS   AGE
bttrm-apps-backend-c4d8f8c5d-98vd2   1/1     Running   0          54s
bttrm-apps-backend-c4d8f8c5d-v6slt   1/1     Running   0          54s
...
helm install bttrm-apps-backend-release bttrm-apps-backend/ --namespace bttrm-apps-dev-1-ns --create-namespace
NAME: bttrm-apps-backend-release
LAST DEPLOYED: Sun May 10 14:45:23 2020
NAMESPACE: bttrm-apps-dev-1-ns
STATUS: deployed
REVISION: 1
TEST SUITE: None
Проверяем:
kk -n bttrm-apps-dev-1-ns get po
NAME                                READY   STATUS    RESTARTS   AGE
bttrm-apps-backend-6c54d5c676-5j6mc   0/1     Pending   0          47s
bttrm-apps-backend-6c54d5c676-vchvh   0/1     Pending   0          47s
Супер, но почему Pending?
Что-то с реквестами, наверно?
Глянем events:
kk -n bttrm-apps-dev-1-ns get event
LAST SEEN   TYPE      REASON                         OBJECT                                      MESSAGE
7s          Warning   FailedScheduling               pod/bttrm-apps-backend-6c54d5c676-5j6mc       0/8 nodes are available: 8 Insufficient cpu.
10s         Normal    NotTriggerScaleUp              pod/bttrm-apps-backend-6c54d5c676-5j6mc       pod didn't trigger scale-up
(it wouldn't fit if a new node is added): 4 Insufficient cpu
А почему?
В values.yaml500 CPU requests, WorkerNodes у нас на ЕС2 t3.medium – у каждого 2000 CPU юнитов…
Проверим реквесты:
kk -n bttrm-apps-dev-1-ns describe pod bttrm-apps-backend-6c54d5c676-5j6mc
Name:           bttrm-apps-backend-6c54d5c676-5j6mc
Namespace:      bttrm-apps-dev-1-ns
...
Host Port:  0/TCP
Requests:
cpu:      500
...
helm upgrade bttrm-apps-backend-release bttrm-apps-backend/ --namespace bttrm-apps-dev-1-ns

Release "bttrm-apps-backend-release" has been upgraded. Happy Helming!

NAME: bttrm-apps-backend-release

LAST DEPLOYED: Sun May 10 14:54:57 2020

NAMESPACE: bttrm-apps-dev-1-ns

STATUS: deployed

REVISION: 2

TEST SUITE: None
Евенты:
kk -n bttrm-apps-dev-1-ns get event

LAST SEEN   TYPE      REASON                         OBJECT                                      MESSAGE

47s         Normal    Scheduled                      pod/bttrm-apps-backend-69d74849df-nvtt2       Successfully assigned bttrm-apps-dev-1-ns/bttrm-apps-backend-69d74849df-nvtt2 to ip-10-3-33-123.us-east-2.compute.internal

15s         Warning   FailedMount                    pod/bttrm-apps-backend-69d74849df-nvtt2       MountVolume.SetUp failed for volume "apple-keys" : secret "apple-keys" not found

15s         Warning   FailedMount                    pod/bttrm-apps-backend-69d74849df-nvtt2       MountVolume.SetUp failed for volume "apple-certificates" : secret "apple-certificates" not found

47s         Normal    SuccessfulCreate               replicaset/bttrm-apps-backend-69d74849df      Created pod: bttrm-apps-backend-69d74849df-nvtt2

...
Ага!
Всё создалось.
Теперь поды не стартуют, потому что не файлов сертификатов для Apple – но это уже детали, сейчас их создадим.
Helm secrets from files
Добавим файлы сертификата – в Jenkins они будут маунтиться из Credentials типа Secret file, тут добавляем в текущий репозиторий:
ll bttrm-apps-be/secrets/

total 12

-rw-r--r-- 1 setevoy setevoy  258 May 10 17:32 AppleAuth.key.p8

-rw-r--r-- 1 setevoy setevoy 3088 May 10 17:27 ApplePay.crt.pem

-rw-r--r-- 1 setevoy setevoy 2006 May 10 17:28 ApplePay.key.pem
Добавляем в ../.gitignore репозитория и в .helmignore чарта:
helm upgrade bttrm-apps-be-release bttrm-apps-be/ --namespace bttrm-apps-dev-1-ns

Release "bttrm-apps-be-release" has been upgraded. Happy Helming!

NAME: bttrm-apps-be-release

LAST DEPLOYED: Sun May 10 17:36:47 2020

NAMESPACE: bttrm-apps-dev-1-ns

STATUS: deployed

REVISION: 4

TEST SUITE: None
Проверяем секреты:
kk -n bttrm-apps-dev-1-ns get secret

NAME                                          TYPE                                  DATA   AGE

apple-certificates                            Opaque                                2      37s

apple-key                                     Opaque                                1      37s
Но поды серты не увидели, и не запустилиись, так и будут висеть в FailedMount.
Пересоздаём их – вызываем upgrade с --recreate-pods:
helm upgrade bttrm-apps-be-release bttrm-apps-be/ --namespace bttrm-apps-dev-1-ns --recreate-pods

Flag --recreate-pods has been deprecated, functionality will no longer be updated. Consult the documentation for other methods to recreate pods

Release "bttrm-apps-be-release" has been upgraded. Happy Helming!

NAME: bttrm-apps-be-release

LAST DEPLOYED: Sun May 10 17:39:39 2020

NAMESPACE: bttrm-apps-dev-1-ns

STATUS: deployed

REVISION: 5

TEST SUITE: None
Проверяем:
helm -n bttrm-apps-dev-1-ns ls

NAME                    NAMESPACE               REVISION        UPDATED                                         STATUS          CHART                   APP VERSION

bttrm-apps-be-release   bttrm-apps-dev-1-ns     2               2020-05-10 17:44:56.505478002 +0300 EEST        deployed        bttrm-apps-be-0.1.0     1.16.0

kk -n bttrm-apps-dev-1-ns get pod

NAME                                READY   STATUS    RESTARTS   AGE

bttrm-apps-be-dp-6f86d5c7d7-k4rjm   1/1     Running   0          2m

bttrm-apps-be-dp-6f86d5c7d7-ztcvp   1/1     Running   0          83s
Тут готово.
.dockerconfigjson
Сейчас в секретах файла bttrm-apps-secrets.yaml значение для .dockerconfigjson задан хардкодом:
неймспейс с именем бранча – APP_NAME + CLUSTER_ENV + GIT_BRANCH_NAME + “NS”, т.е. bttrm-apps-dev-1-WLIOS-5848-Projects-deployments
кастомный неймспейс, задаётся юзером
Есть сомнения по второму пункту – bttrm-apps-dev-1-WLIOS-5848-Projects-deployments – не слишком ли длинно?
Загуглим “kubernetes namespace best practices”, но лучшее, что нашлось – это вот эта запись в блоге, в которой говорится:
An easy to grasp anti-pattern for Kubernetes namespaces is versioning. You should not use Namespaces as a way to disambiguate versions of your Kubernetes resources
Namespace names are DNS1123 Labels: maximum 63 characters … You may want to populate generateName with a prefix, and let kubernetes make a unique suffix.
Хорошо – раз лимит в 63 символа – мы можем в дженкисфайле добавить хендлер, который будет проверять имя неймспейса, переданного из Jenkins-парамтеров, и при необходимости обрезать его.
Весь билд будет выполняться нашим кастомным Docker-образом kubectl-aws, собирается из такого Dockerfile:
FROM bitnami/minideb:stretch

RUN apt update && install_packages ca-certificates wget

RUN install_packages curl python-pip python-setuptools jq git

RUN curl -LO https://storage.googleapis.com/kubernetes-release/release/`curl -s https://storage.googleapis.com/kubernetes-release/release/stable.txt`/bin/linux/amd64/kubectl

RUN chmod +x ./kubectl

RUN mv ./kubectl /usr/local/bin/kubectl

WORKDIR /tmp

RUN curl  --location "https://github.com/weaveworks/eksctl/releases/latest/download/eksctl_$(uname -s)_amd64.tar.gz" | tar xz -C /tmp

RUN mv /tmp/eksctl /usr/local/bin

RUN pip install ansible boto3 awscli

WORKDIR /tmp

RUN curl -fsSL -o get_helm.sh https://raw.githubusercontent.com/helm/helm/master/scripts/get-helm-3

RUN /bin/bash get_helm.sh

USER root
Пока все значения тпиа Github URL и имени бранча в скрипте билда хардкодим – потом вынесем в параметры джобы.
Запускаем, проверяем – всё работает.
Пошли дальше.
Docker build
Далее нам надо собрать Docker-образ, и запушить его в репозиторий.
Добавлять ли тег latest? Вопрос.
Наверно нет – билдов может быть много, из разных бранчей – перезаписывать каждый раз latest смысла нет, тем более деплоится в Dev окружение всё будет автоматом при создании пул-реквестов, см. Jenkins: Github Pull-Request Builder плагин.
Значит – делаем только docker build с тегом из переменной $DOCKER_TAG.
Создаём данные доступа для DockerHub:
Добавляем новый стейдж “Docker build”, в нём с помощью Docker-плагина для Jenkins собираем образ, для логина в DockerHub через credentialsId передаём созданные выше данные:
Дальше генерируем пакет. Пока надо только для того, что бы можно было задать release verion и app-version. Позже хочется добавить их пуш куда-то в репозиторий – или Github, или S3-backended.
добавить создание неймспейса по имени бранча и кастомный НС
проверка длины неймспейсов
Но пока, думаю, хватит.
helm upgrade – resource cannot be imported into the current release
P.S. Когда добавлял RBAC-роль – то при апдейте получил ошибку:
helm upgrade --install --namespace bttrm-apps-dev-1-ns --create-namespace --atomic bttrm-apps-backend bttrm-apps-backend-17.tgz

Error: UPGRADE FAILED: rendered manifests contain a resource that already exists. Unable to continue with update:

RoleBinding "rbac-bttrm-web-apps-ro-role-binding" in namespace "bttrm-apps-dev-1-ns" exists and cannot be imported into the current release:

invalid ownership metadata; label validation error: missing key "app.kubernetes.io/managed-by":

must be set to "Helm"; annotation validation error: missing key "meta.helm.sh/release-name": must be set to "bttrm-apps-backend";

annotation validation error: missing key "meta.helm.sh/release-namespace": must be set to "bttrm-apps-dev-1-ns"
Собственно, это к тому, что Helm задаёт аннотации и лейблы сам – но есть смысл добавлять их в шаблоны манифестов:
Стоит попробовать Mizu – это ПО для мониторинга Kubernetes-трафика. Программа может сильно упростить ежедневную диагностику сетей, да и жизнь в целом.
Одна из наиболее частых задач, с которыми сталкиваются администраторы Kubernetes по ходу тестирования и дебаггинга – проверка коммуникаций между компонентами внутри сети.
Если вы хоть как-то взаимодействуете c Kubernetes по работе, то наверняка частенько проверяете входящий трафик, чтобы изучить входящие запросы и т.п. Обычно задачи подобного рода решаются при помощи утилиты tcpdump, установленной в конкретный контейнер. Таким образом, проверяются некоторые сетевые аспекты вне контейнеров, но иногда такой подход оказывается довольно сложным из-за специфики окружения или конфигурации системы.
Чтобы не натыкаться на кучу проблем по ходу мониторинга сети, советую использовать утилиту Mizu. Многие программисты, работающие с Kubernetes, мечтали бы найти подобный инструмент раньше.
Mizu можно описать как простой, но при этом мощный инструмент для отслеживания трафика в Kubernetes. Он позволяет отслеживать все API-коммуникации между микросервисами независимо от используемого протокола и упрощает процесс дебаггинга соединений.
Установка Mizu
Процесс установки довольно простой. Все что нужно – загрузить бинарный файл Mizu и настроить соответствующие разрешения в системе. Выбор бинарного файла (установщика) зависит от архитектуры устройства. Например, чтобы установить Mizu на компьютер Apple с чипом Intel нужно ввести в терминал команду:
Обычно этого достаточно. Загруженный бинарный файл теперь можно использовать для подключения к кластеру Kubernetes и работы с Kubernetes API, но для этого нужно внести несколько изменений в настройки Докера.
Вот как это может выглядеть в случае с базовым nginx-сервером. Начать стоит с команды:
kubectl run simple-app --image=nginx --port 3000
После развертки базового приложения на основе nginx переходим непосредственно к запуску Mizu. Делается это всего одной командой:
mizu tap
Через пару секунд на экране появится веб-страница с интерфейсом Mizu. Здесь и отображается весь трафик на выбранном сервере. Но для настройки такого поведения необходимо внести изменения в параметры портов. К примеру, если ваше приложение называется ‘my-app’, команда будет выглядеть так:
kubectl expose pod/my-app
После этого деплоим еще один временный сервер, используя готовый образ (при помощи следующей команды):
kubectl run -it --rm --image=curlimages/curl curly -- sh
Теперь можно использовать утилиту curl для отправки запросов непосредственно на nginx-сервер. Например, так:
curl -vvv http://my-app:3000
Уже после первых нескольких запросов вы увидите большой объем полезной информации, отображающейся в интерфейсе Mizu. В первую очередь стоит отметить то, насколько детально описываются все процессы, происходящие внутри Kubernetes. Но что еще важнее, в Mizu есть диаграммы, наглядно показывающие зависимости между запросами с учетом используемого протокола и другой полезной информации.
Конечно, Mizu не сможет заменить более сложные продукты и полноценные системы наблюдения за сетью. Но это довольно удобный инструмент, который поможет вам исправить немало багов по ходу работы с Kubernetes, и его точно стоит иметь под рукой.
Контейнеры Docker обычно считаются неизменяемыми после начала их работы.
Однако некоторые параметры конфигурации можно изменять динамически, например, имя контейнера и лимиты его аппаратных ресурсов.
В этом руководстве мы покажем вам, как использовать встроенные команды Docker для изменения выбранных параметров запущенных контейнеров.
Мы также рассмотрим, что не следует изменять, и обходные пути, которые можно использовать, если вы считаете, что это необходимо.
Переименование контейнера
Самым простым изменением является переименование созданного контейнера. Имена присваиваются с помощью флага –name для команды docker run.
Если имя не указано, демон Docker присваивает случайное имя.
Вы можете использовать имена для ссылок на контейнеры в командах Docker CLI; выбор подходящего запоминающегося имени позволяет избежать выполнения команды docker ps для поиска автоматически назначенного имени или ID контейнера.
Команда docker rename используется для изменения имен контейнеров после создания.
Она принимает два аргумента: ID или текущее имя целевого контейнера и новое имя, которое нужно присвоить:
# docker rename <target ID or name> <new name>
docker rename old_name new_name
Изменение политики перезапуска
Restart policies определяют, должны ли контейнеры запускаться автоматически после перезагрузки хоста или запуска демона Docker.
Четыре доступные политики позволяют принудительно запустить контейнер, заставить его оставаться остановленным или условно запустить на основе предыдущего кода выхода или состояния работы контейнера.
Docker поддерживает изменение политик перезапуска “на лету”.
Это полезно, если вы планируете перезагрузить хост или демон Docker и хотите, чтобы определенный контейнер оставался остановленным – или автоматически запускался – после определенного события.
Приведенный выше пример изменяет политику перезапуска demo_container на unless-stopped.
Эта политика заставляет контейнер запускаться вместе с демоном, если он не был остановлен вручную перед последним выходом демона.
Изменение лимитов аппаратных ресурсов
Команда docker update также может быть использована для изменения ограничений ресурсов, применяемых к контейнерам.
Вы должны передать один или несколько идентификаторов или имен контейнеров, а также список флагов, определяющих ограничения, которые необходимо установить для этих контейнеров.
Флаги доступны для всех ограничений ресурсов, поддерживаемых docker run.
Вот краткий список опций, которые вы можете использовать:
–blkio-weight – Изменить относительный вес Block IO контейнера.
–cpus – Установить количество процессоров, доступных контейнеру.
–cpu-shares – Установить относительный вес доли ЦП.
–memory – Изменить лимит памяти контейнера (например, 1024M).
–memory-swap – настройка объема памяти, который контейнер может обменять на диск; используйте размер, например 1024M, чтобы установить определенный лимит, или -1 для неограниченной замены.
–kernel-memory – Изменить лимит памяти ядра контейнера. Контейнеры, испытывающие недостаток памяти ядра, могут негативно влиять на другие рабочие нагрузки на хост-машине.
–pids-limit – настройка максимального количества идентификаторов процессов, разрешенных внутри контейнера, что ограничивает количество процессов, которые могут быть запущены.
Вот пример использования docker update для изменения лимита памяти и количества CPU для двух контейнеров
Все доступные флаги, кроме –kernel-memory, можно использовать с запущенными контейнерами Linux.
Чтобы изменить лимит памяти ядра, необходимо сначала остановить контейнер с помощью docker stop.
Имейте в виду, что ни один из этих флагов в настоящее время не поддерживается для контейнеров на базе Windows.
Однако они будут работать с контейнерами Linux, запущенными на хост-машине Windows.
Когда не следует использовать эти команды?
Команды docker update и docker rename следует использовать с контейнерами, которые вы создали вручную с помощью команды docker run.
Опасайтесь использовать их для контейнеров, созданных с помощью других инструментов, таких как docker-compose.
Изменение имени контейнера может сделать его необнаружимым для исходного инструмента, что может привести к поломке других компонентов вашего стека.
Кроме того, если вы декларативно определяете ограничения на ресурсы в файле docker-compose.yml, повторное выполнение команды docker-compose up приведет к повторному применению этих исходных ограничений к вашему контейнеру.
Поэтому вам следует придерживаться существующего решения для управления контейнерами, если вы его используете.
Для Compose это означает изменение имен контейнеров и лимитов ресурсов в файле docker-compose.yml, а затем выполнение команды docker-compose up -d для автоматического применения изменений.
Это позволит избежать непреднамеренного сиротства контейнеров или возникновения непреднамеренных побочных эффектов.
Что касается других свойств (образа/порты/тома)?
Аппаратные ограничения, политики ресурсов и имена контейнеров – это единственные параметры конфигурации, которые позволяет изменять Docker CLI.
Вы не можете изменить образ запущенного контейнера; вы также не можете легко изменить другие параметры, такие как привязка портов и тома.
Вам следует создать другой контейнер, если эти значения устарели.
Уничтожьте текущий экземпляр и с помощью команды docker run запустите новый контейнер с новым образом и исправленными настройками.
Поскольку контейнеры должны быть без статических данных и эфемерными, вы должны иметь возможность заменить их в любое время.
Используйте тома для хранения постоянных данных контейнера; этот механизм позволяет повторно подключить файлы с состоянием к новому контейнеру, повторив флаги -v, переданные исходной команде docker run:
docker run -v config-volume:/usr/lib/config --name demo example-image:v1

docker rm demo

# Существующие данные в /usr/lib/config сохранены
docker run -v config-volume:/usr/lib/config --name demo2 example-image:v2
Опасная зона: Изменение других свойств контейнера
Хотя вы должны стремиться заменять контейнеры везде, где это возможно, можно изменять свойства существующих контейнеров путем прямого редактирования конфигурационных файлов Docker.
Будьте осторожны при использовании этого метода: он совершенно не поддерживается, и неправильное изменение может привести к поломке вашего контейнера.
Хотя эта опция предоставляет возможность произвольно редактировать существующие контейнеры, она не будет работать во время их работы.
Используйте команду docker stop my-container, чтобы остановить контейнер, который вы хотите отредактировать, а затем продолжайте вносить свои изменения.
Конфигурационные файлы контейнеров имеют следующий путь
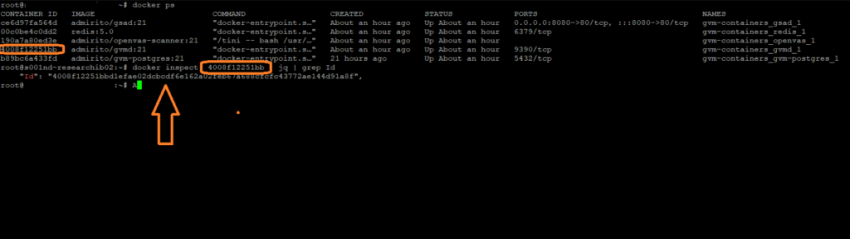
Вам нужно знать полный ID контейнера, а не усеченную версию, которую показывает docker ps.
Для этого можно использовать команду docker inspect:
docker inspect <short id or name> | jq | grep Id
Добравшись до config.v2.json контейнера, вы можете открыть его в текстовом редакторе, чтобы внести необходимые изменения.
В JSON хранится конфигурация контейнера, созданная при запуске docker run.
Вы можете изменить его содержимое, чтобы изменить такие свойства, как привязка портов, переменные окружения, тома, а также точку входа контейнера и команду.
Чтобы добавить привязку к порту, найдите в файле ключ PortBindings, затем вставьте новый элемент в объект:
После завершения редактирования перезапустите службу Docker и ваш контейнер:
sudo service docker restart

docker start my-container
Заключение
Контейнеры Docker должны быть эфемерными единицами, которые вы заменяете, когда их конфигурация устаревает.
Несмотря на это намерение, существуют сценарии, когда необходимо изменить существующий контейнер.
Docker обрабатывает наиболее распространенные случаи – изменение имени и корректировка лимита ресурсов в реальном времени – с помощью встроенных команд CLI, таких как docker update.
Когда вы хотите изменить другое свойство, всегда старайтесь в первую очередь заменить контейнер.
Это минимизирует риск поломки и соответствует модели неизменяемости Docker.
Если вы все же попали в ситуацию, когда необходимо изменить существующий контейнер, вы можете вручную изменить внутренние конфигурационные файлы Docker, как описано выше.
Наконец, помните, что контейнеры, управляемые другими инструментами экосистемы, такими как Docker Compose, должны быть изменены с помощью этих механизмов.
В противном случае вы можете обнаружить, что контейнеры неожиданно осиротеют или будут перезаписаны, если инструмент не знает о внесенных вами изменениях.